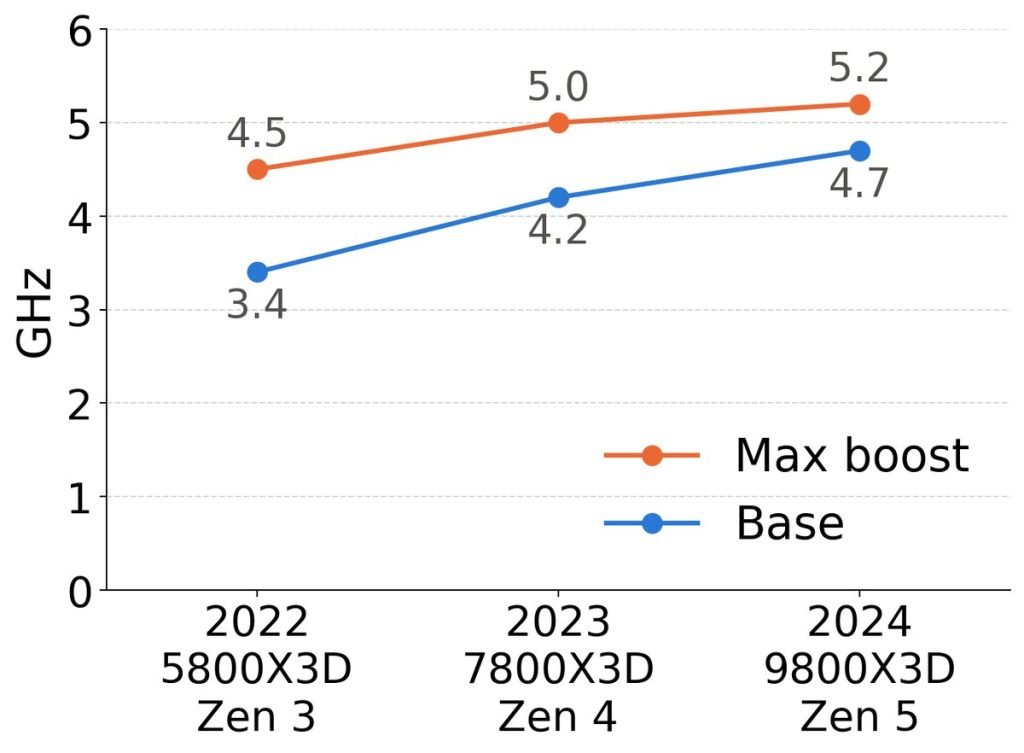
simdjson을 만든 것으로 유명한 다니엘 르미어(Daniel Lemire)가 재미있는 질문을 던졌어요. 자기가 쓰던 2년 전 AMD 라이젠과 최신 라이젠을 같은 벤치마크로 돌려봤더니 약 50%가 빨라졌는데, 도대체 2년 사이에 무슨 일이 있었길래 이만큼 차이가 나느냐는 거예요. 무어의 법칙은 끝났다고 하고, 클럭은 몇 년째 5GHz 근처에서 멈춰 있는데 말이죠. 이 질문을 따라가다 보면 요즘 CPU가 어디서 성능을 짜내는지 꽤 명확하게 보여요.
CPU 성능은 결국 곱셈이에요
CPU가 어떤 프로그램을 얼마나 빨리 끝내느냐는 크게 세 가지 곱으로 정해져요. 초당 몇 번 뛰는지(클럭), 한 번 뛸 때 명령어를 몇 개 처리하는지(IPC, Instructions Per Cycle), 그리고 그 명령어 하나가 얼마나 많은 일을 하는지(명령어의 폭)예요.
클럭은 이제 거의 안 올라요. 2년 전 라이젠도 5GHz 넘게 부스트했고 지금도 비슷해요. 발열과 전력 때문에 물리적으로 한계에 부딪힌 거예요. 그러면 남은 건 IPC와 명령어 폭인데, 이번 50%의 대부분은 여기서 나왔다고 보면 돼요.
IPC가 뭐냐면
IPC가 뭐냐면, 클럭 한 번에 CPU가 실제로 끝내는 명령어 수예요. 옛날 CPU는 클럭 한 번에 명령어 하나를 처리했지만, 요즘 CPU는 한 번에 여섯 개, 여덟 개씩 처리해요. 이걸 가능하게 하려면 여러 부품을 동시에 넓혀야 해요.
식당에 비유하면 이래요. 주문을 받는 직원(디코더)이 한 번에 몇 명의 주문을 받을 수 있는지, 주방(실행 유닛)에 요리사가 몇 명인지, 대기 중인 주문을 얼마나 많이 기억해뒀다가 재료가 준비된 것부터 순서를 바꿔 만들 수 있는지(리오더 버퍼와 비순차 실행), 손님이 뭘 시킬지 미리 맞혀서 재료를 준비해두는 실력(분기 예측)이 얼마나 좋은지. 이 모든 게 동시에 좋아져야 식당 전체 처리량이 올라가요. 요리사만 늘리면 주문 받는 직원이 병목이 되고, 주문만 많이 받으면 주방이 밀려요.
AMD는 세대를 거치면서 이 부품들을 전부 넓혀왔어요. 분기 예측기는 한 클럭에 두 개의 분기를 처리하는 구조로 바뀌었고, 디코더와 디스패치 폭도 넓어졌고, 비순차 실행을 위한 대기 공간도 커졌어요. 각각은 몇 퍼센트씩이지만 곱해지면 두 자릿수 IPC 향상이 나오는 거예요.
명령어 하나가 하는 일이 두 배로
르미어 같은 사람의 벤치마크에서 특히 큰 차이를 만들 수 있는 건 SIMD예요. 이게 뭐냐면, 명령어 하나로 여러 개의 데이터를 한꺼번에 계산하는 기능이에요. 숫자 16개를 더해야 할 때 일반 명령어는 16번 돌아야 하지만, 512비트 SIMD 명령어는 한 번에 끝낼 수 있어요. JSON 파싱, 문자열 검색, 이미지 처리, 압축 같은 작업이 이런 명령어의 덕을 크게 봐요.
AMD는 AVX-512라는 512비트 SIMD 명령어 집합을 지원해왔는데, 처음 도입했을 때는 내부적으로 256비트 연산 유닛을 두 번 돌려서 512비트를 흉내 내는 방식이었어요. 겉으로는 512비트를 지원하지만 실제 처리량은 256비트급이었던 거죠. 이후 세대에서 이 연산 유닛을 진짜 512비트 폭으로 넓혔어요. 그러면 AVX-512를 적극적으로 쓰는 코드는 같은 클럭에서 처리량이 거의 두 배로 뛰어요. 르미어가 만드는 라이브러리들은 대부분 이런 SIMD 코드로 되어 있으니 50%라는 숫자가 나오는 게 이상하지 않아요.
그런데 내 프로그램도 50% 빨라질까요
여기가 중요한 부분인데요, 아니에요. 르미어의 50%는 SIMD와 캐시를 잘 활용하는 고도로 최적화된 코드에서 나온 숫자예요. 일반적인 웹 서버, 데이터베이스, 자바나 파이썬으로 짠 업무용 코드는 분기가 많고 메모리 접근이 불규칙해서 IPC 향상의 일부만 가져가요. 보통 세대 간 일반 워크로드 성능 차이는 10~20% 정도로 보는 게 현실적이에요.
또 하나, CPU가 빨라져도 메모리가 못 따라오면 소용없어요. 데이터가 캐시에 안 들어가고 계속 DRAM에서 가져와야 하는 프로그램은 CPU 코어가 아무리 넓어져도 기다리는 시간이 대부분이거든요. 그래서 CPU 세대 교체와 함께 캐시 크기, 메모리 대역폭이 같이 커지는지 봐야 해요.
업계 맥락에서 보면
'클럭 대신 폭으로 간다'는 흐름은 AMD만의 이야기가 아니에요. 애플 M 시리즈는 처음부터 클럭을 낮게 가져가면서 코어를 극단적으로 넓게 만들어 IPC로 승부하는 설계였고, 그게 인텔과 AMD를 자극했어요. 인텔도 최근 세대에서 디코더와 실행 유닛 폭을 크게 늘렸고요. Arm 진영의 서버 칩들도 같은 방향이에요. 결국 모든 CPU 회사가 '한 클럭에 얼마나 많은 일을 하느냐'로 경쟁하고 있는 거예요.
다만 이 경쟁의 혜택을 받으려면 소프트웨어 쪽도 준비가 되어 있어야 해요. 넓어진 SIMD 유닛은 컴파일러가 SIMD 명령어를 생성하거나 라이브러리가 직접 SIMD 코드를 써야 활용되거든요. 하드웨어가 아무리 넓어져도 코드가 좁으면 그냥 노는 거예요.
한국 개발자에게는
당장 실무에서 할 수 있는 건 이런 것들이에요. 첫째, 빌드 서버나 CI 러너를 교체할 때가 됐다면 코어 수만 보지 말고 세대를 보세요. 같은 코어 수여도 최신 세대가 컴파일 시간을 눈에 띄게 줄여줘요. 둘째, C++나 Rust로 성능이 중요한 코드를 짠다면 컴파일러에 -march=native 또는 배포 대상 아키텍처를 명시해서 AVX-512 같은 명령어를 쓰게 해주세요. 기본 설정은 호환성을 위해 오래된 명령어만 쓰거든요. 셋째, 직접 SIMD를 짤 필요는 없어요. simdjson, simdutf 같은 라이브러리나 최신 버전의 런타임(Node.js, JVM, .NET)이 이미 내부적으로 활용하고 있으니, 런타임 버전을 올리는 것만으로도 혜택을 받아요.
마무리
한 줄로 정리하면, 최신 CPU는 더 빨리 뛰는 게 아니라 한 번 뛸 때 더 많은 일을 하도록 넓어졌고, 그 혜택은 코드가 넓은 명령어를 쓸 때 온전히 나온다는 거예요.
여러분은 서버나 개발 장비를 교체할 때 어떤 기준으로 고르시나요? 코어 수, 클럭, 세대 중에 실제 체감 차이를 만든 건 뭐였는지 궁금해요.
🔗 출처: Hacker News