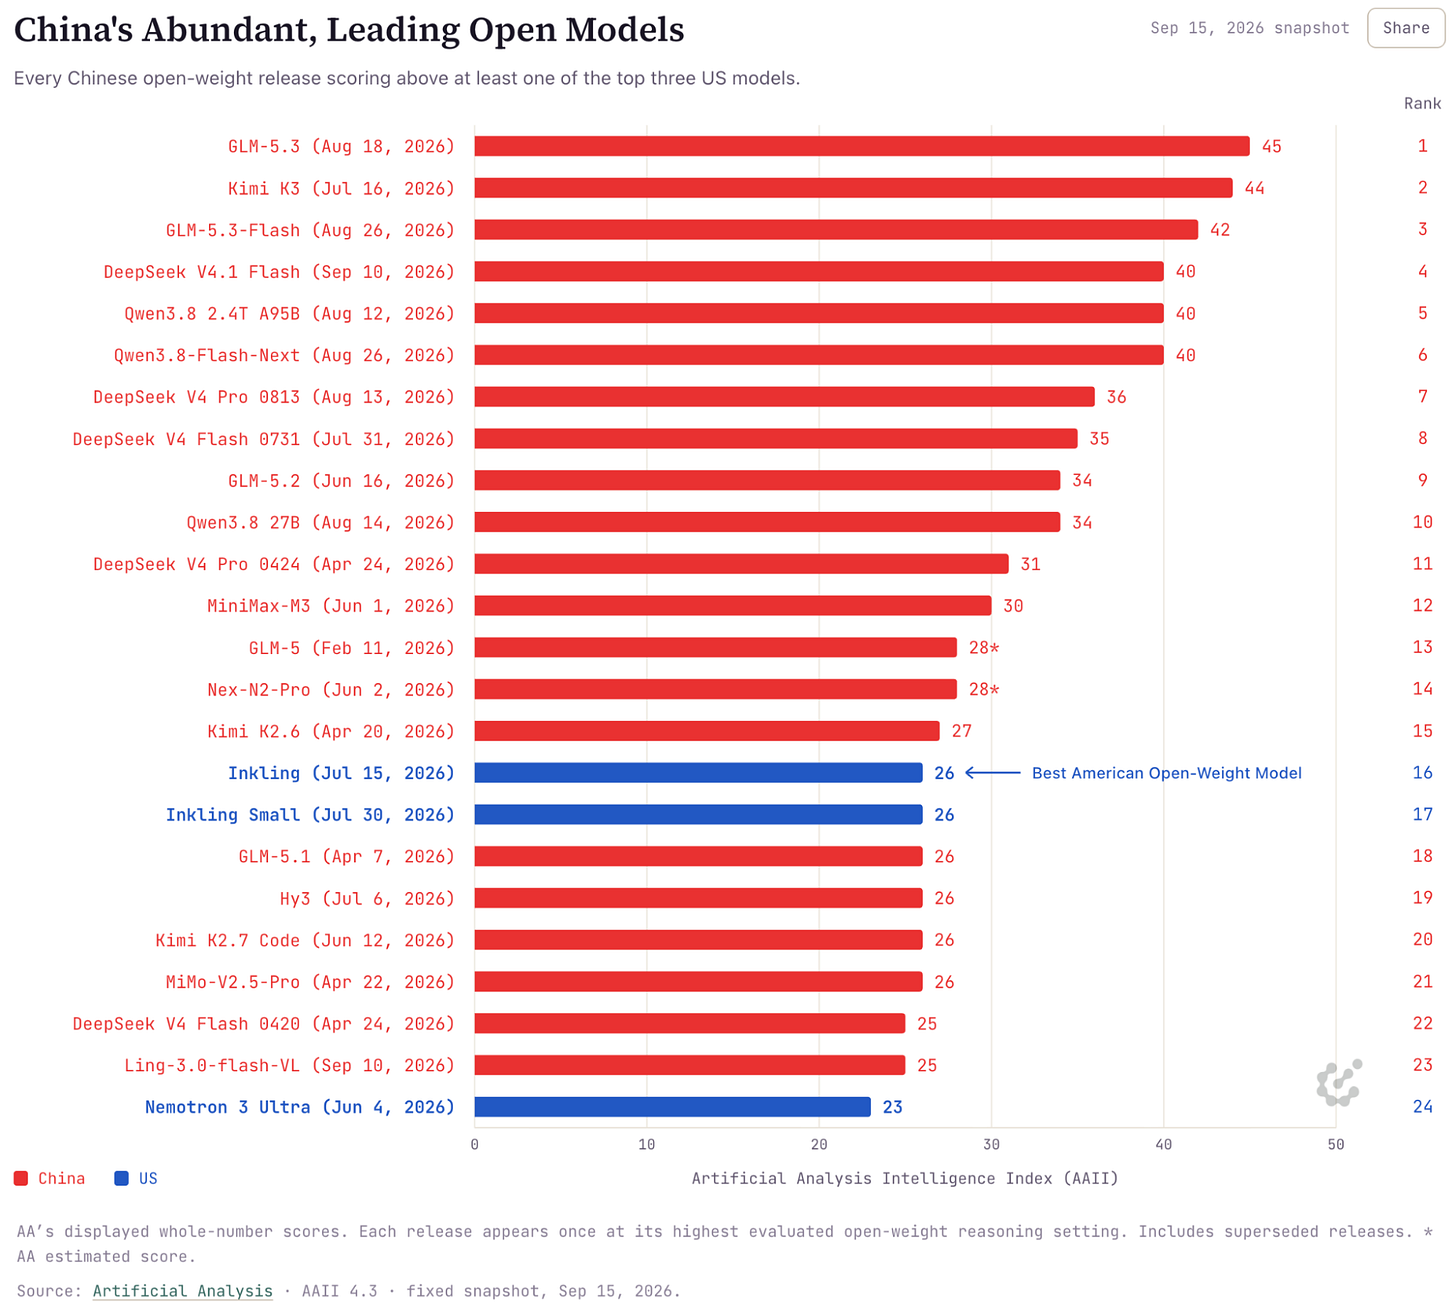
오픈 모델 시장, 지금 어떤 상황이냐면
인터커넥츠(Interconnects)를 운영하는 네이선 램버트가 오픈 모델의 세력 판도를 정리한 글을 올렸어요. 이 분은 Ai2(앨런 AI 연구소)에서 OLMo 같은 완전 공개 모델을 직접 만드는 연구자이기도 해서, 오픈 모델 얘기라면 가장 현장에 가까운 사람 중 하나거든요. 이 글을 계기로, 지금 오픈 모델 시장이 어떻게 돌아가고 있는지 한번 차분히 정리해볼게요.
먼저 용어부터 짚고 갈게요. '오픈 모델'이라고 하면 보통 오픈 웨이트(open weight) 모델을 말해요. 이게 뭐냐면, 학습이 끝난 모델의 가중치 파일을 누구나 내려받아서 자기 서버에서 돌릴 수 있게 공개한 모델이에요. GPT나 Claude처럼 API로만 쓸 수 있는 폐쇄형 모델과 반대 개념이죠. 다만 가중치만 공개하고 학습 데이터나 학습 코드는 안 푸는 경우가 대부분이라, 소프트웨어에서 말하는 진짜 '오픈소스'와는 조금 다르다는 점은 알아두시면 좋아요.
중국 랩들이 왜 이렇게 강해졌나
2025년 초 DeepSeek R1이 나온 이후로 흐름이 완전히 바뀌었어요. 그 전까지는 메타의 Llama가 오픈 모델의 기준점이었는데, 지금은 DeepSeek, 알리바바의 Qwen, 문샷의 Kimi, 즈푸의 GLM, MiniMax까지 중국 랩들이 최상위권을 거의 독식하고 있거든요. 특히 Qwen은 소형부터 대형까지 크기별로 모델을 촘촘하게 내놓고 라이선스도 Apache 2.0으로 풀어서, 사실상 '2025년의 Llama' 자리를 가져갔다고 봐도 돼요. 허깅페이스에서 파생 모델이 가장 많이 만들어지는 계열도 Qwen이에요.
기술적으로 눈여겨볼 건 MoE(Mixture of Experts) 구조예요. 이게 뭐냐면, 모델 안에 전문가 역할을 하는 작은 네트워크를 여러 개 두고, 입력 토큰마다 그중 몇 개만 골라서 계산하는 방식이에요. 병원에 갔을 때 모든 의사가 나를 진료하는 게 아니라 증상에 맞는 과의 의사만 보는 것과 비슷해요. 예를 들어 Kimi K2는 전체 파라미터가 1조 개인데 실제로 한 번에 활성화되는 건 320억 개 정도거든요. 덕분에 '덩치는 크지만 추론 비용은 작은' 모델이 가능해졌고, 중국 랩들은 이 구조를 극한까지 밀어붙이면서 GPU 수출 제한을 우회하는 노하우를 쌓았어요.
또 하나는 릴리스 속도예요. 몇 달 간격으로 새 버전이 나오고, 추론(reasoning) 모델, 코딩 특화 모델, 에이전트용 모델처럼 용도별 변형도 빠르게 쏟아지고 있어요. 폐쇄형 최상위 모델과의 격차가 몇 달 수준으로 좁혀졌다는 평가가 나오는 이유예요.
미국과 유럽은 어떻게 대응하고 있나
메타는 사실상 오픈 모델 경쟁에서 한 발 물러난 모양새예요. Llama 4가 기대에 못 미쳤고, 이후 조직을 크게 개편하면서 최상위 모델은 폐쇄형으로 갈 수 있다는 얘기가 계속 나오고 있거든요. 대신 그 빈자리를 여러 플레이어가 나눠 메우는 중이에요.
- OpenAI의 gpt-oss: 2025년 8월에 Apache 2.0으로 공개한 1200억, 200억 파라미터 모델이에요. OpenAI가 GPT-2 이후 처음으로 가중치를 공개했다는 상징성이 컸죠.
- 엔비디아 Nemotron: 하드웨어 회사가 모델까지 직접 내면서, 학습 데이터까지 상당 부분 공개하는 방향으로 가고 있어요.
- Ai2 OLMo: 데이터, 코드, 중간 체크포인트까지 전부 공개하는 '진짜 오픈소스' 노선이에요. 성능은 최상위권은 아니지만 연구용 기준점 역할을 하고 있어요.
- 미스트랄: 유럽 대표 주자로, 대형 MoE 모델과 소형 모델을 Apache 2.0으로 꾸준히 내고 있어요.
그래서 세력 균형은 어디로 가고 있나
흥미로운 건 중국 랩들도 영원히 다 풀지는 않을 수 있다는 점이에요. 알리바바의 최상위 모델인 Qwen3-Max는 API로만 제공되고, 즈푸나 MiniMax는 상장을 거치면서 수익화 압박이 커지고 있거든요. 오픈 웨이트는 지금까지 '인지도를 얻고 생태계를 장악하는 수단'이었는데, 그 전략이 언제까지 유지될지는 지켜봐야 해요.
반대로 서구 쪽에서는 '어떤 모델이 더 좋으냐'만큼 '누구 모델을 믿고 쓸 수 있느냐'가 중요해지고 있어요. 기업 입장에서는 라이선스, 학습 데이터 출처, 정치적으로 민감한 주제에 대한 응답 성향 같은 것들이 도입 결정에 직접 영향을 주니까요. 그래서 성능은 조금 뒤져도 출처가 분명한 미국이나 유럽 모델을 택하는 경우가 생기고 있어요.
한국 개발자에게 주는 시사점
실무적으로는 지금이 오픈 모델을 쓰기에 가장 좋은 시기예요. Qwen이나 DeepSeek 계열은 한국어 성능도 꽤 괜찮고, vLLM이나 SGLang 같은 서빙 프레임워크로 바로 띄울 수 있거든요. 다만 프로덕션에 넣을 때는 세 가지를 꼭 확인하세요. 첫째, 라이선스가 Apache 2.0이나 MIT인지, 아니면 사용 조건이 붙어 있는지. 둘째, MoE 모델은 활성 파라미터는 작아도 전체 가중치를 메모리에 올려야 하니, GPU 메모리 계산은 전체 파라미터 기준으로 해야 한다는 점. 셋째, 회사 정책상 특정 국가 출신 모델에 제약이 있는지.
배워둘 가치로 보면, MoE 구조와 추론 모델의 동작 원리는 지금 시점에서 꼭 이해해두는 게 좋아요. 앞으로 나올 오픈 모델은 대부분 이 두 가지를 기본으로 깔고 갈 테니까요. 작은 모델을 로컬에서 돌려보면서 양자화나 서빙 최적화를 손에 익혀두는 것도 추천해요.
정리
한 줄 요약: 오픈 모델 시장은 중국 랩이 성능과 속도로 주도하고, 미국과 유럽이 정책과 자본을 동원해 따라잡으려는 구도예요.
여러분은 실무에서 오픈 모델을 고를 때 성능을 우선하시나요, 아니면 출처와 라이선스를 우선하시나요? 그리고 중국 랩들이 최상위 모델을 폐쇄형으로 돌리기 시작하면, 오픈 모델 생태계는 어떻게 바뀔 거라고 보시나요?
🔗 출처: Hacker News