무슨 이야기냐면요
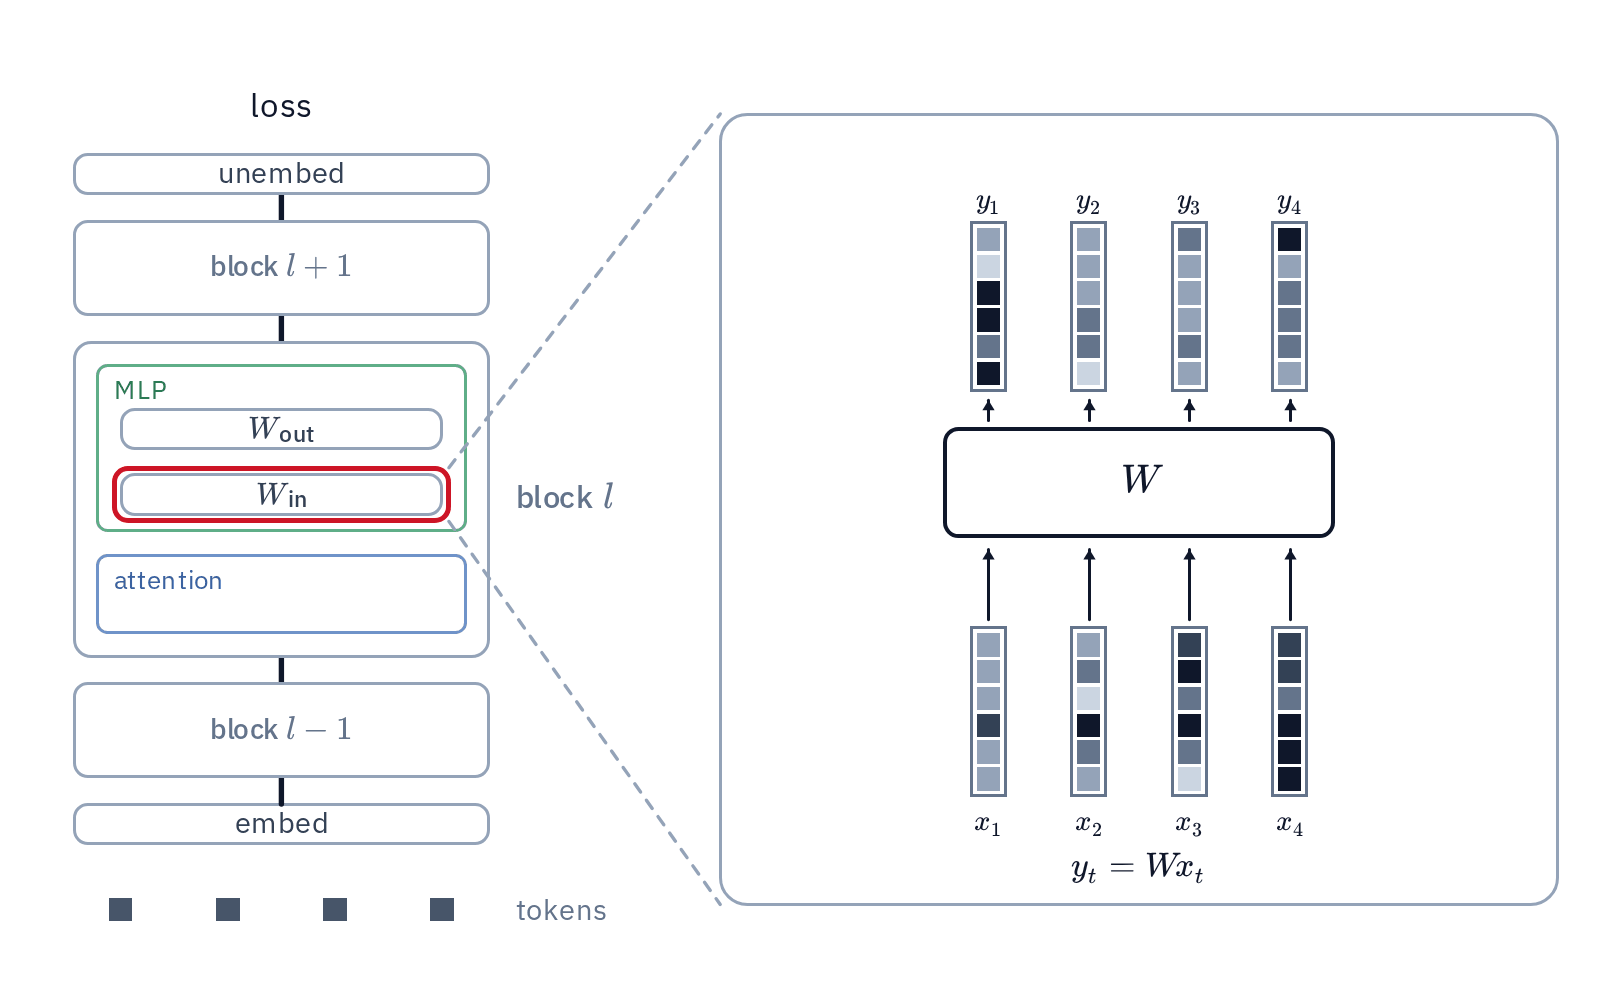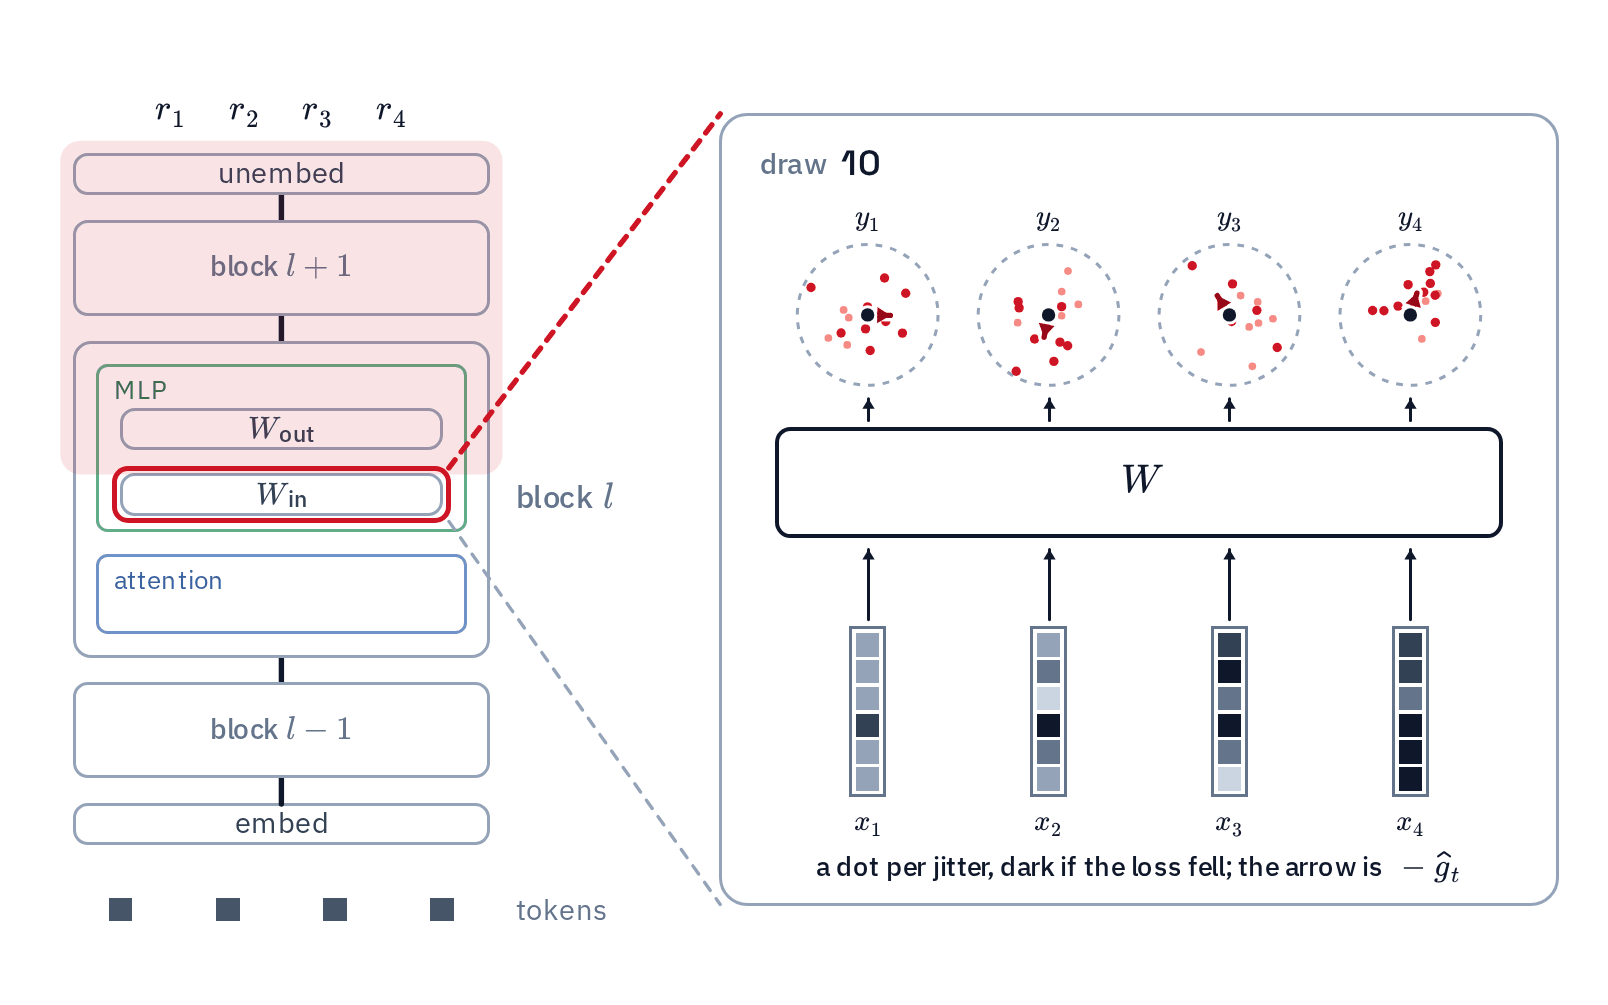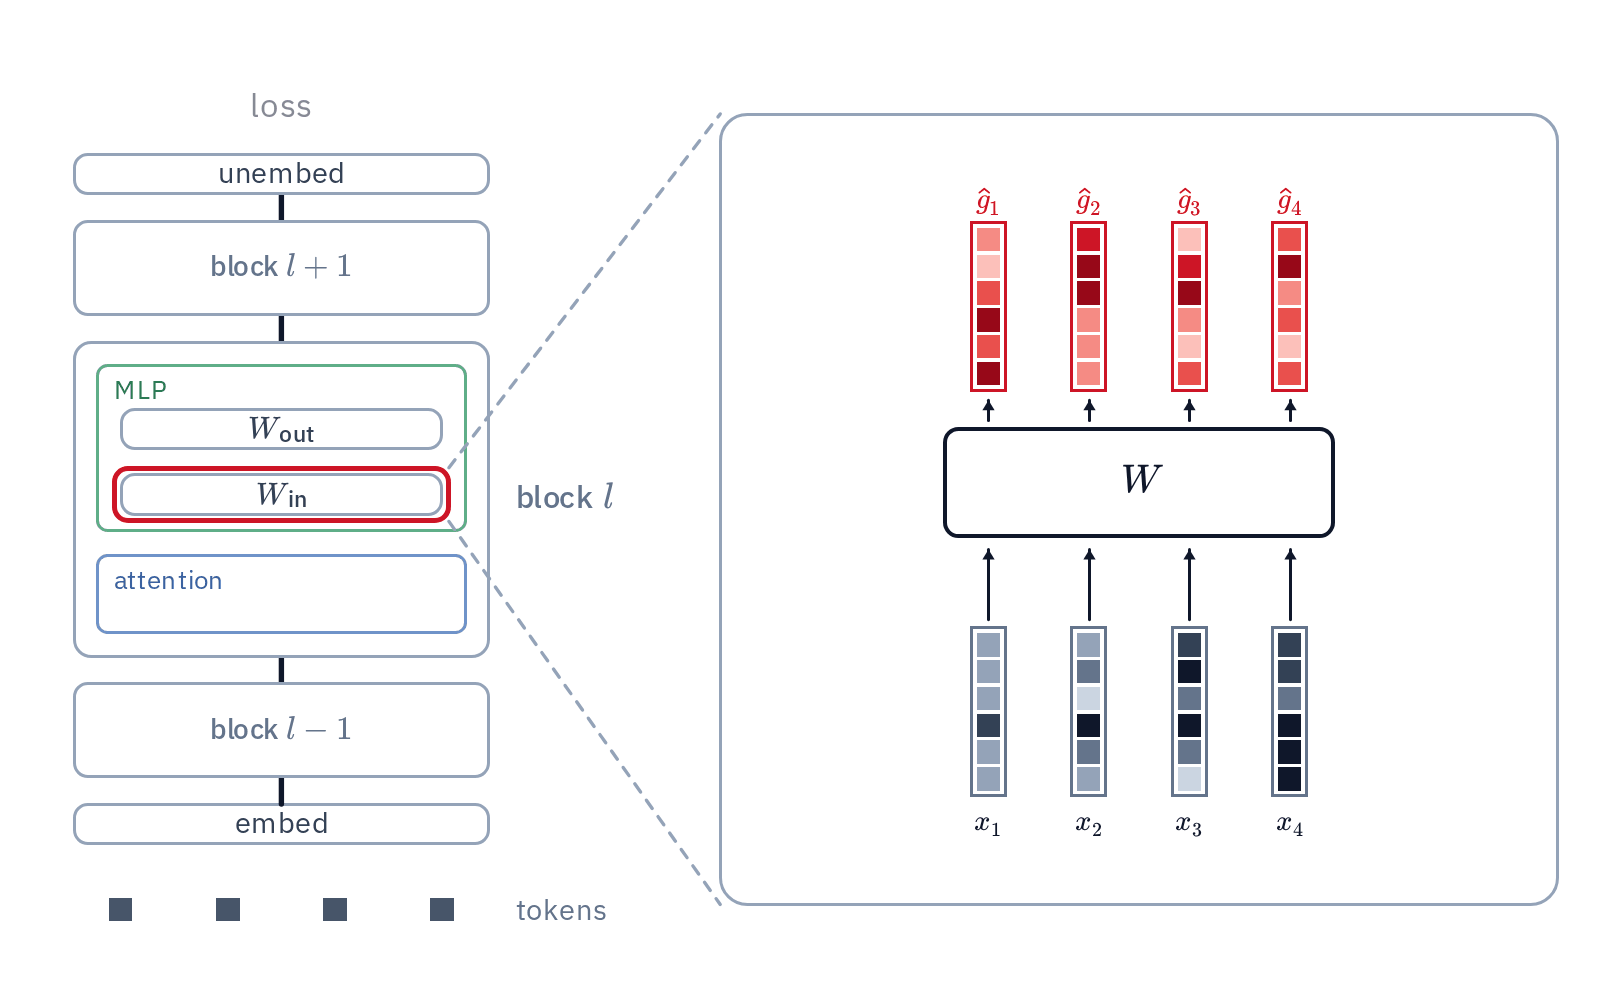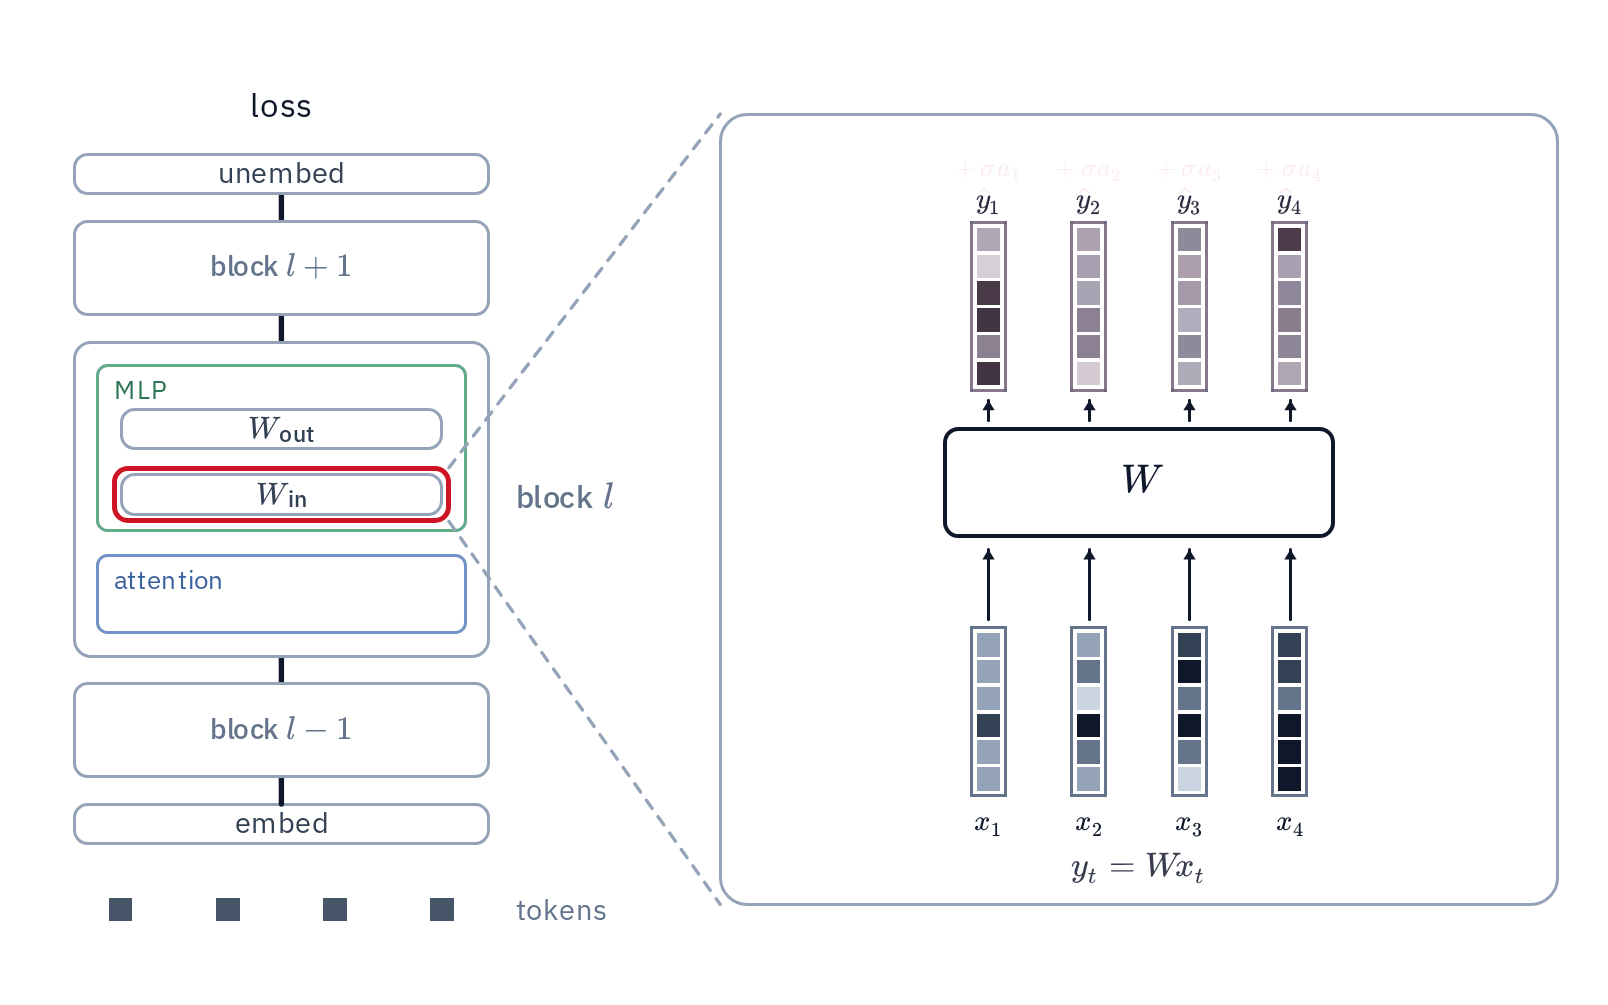
qlabs 연구팀이 Dust라는 연구를 공개했어요. 핵심 주장은 제목 그대로, 역전파(backpropagation) 없이 트랜스포머를 사전학습했다는 거예요. 지난 10여 년간 딥러닝에서 '학습'은 곧 '역전파'였어요. GPT든 이미지 모델이든 거의 전부 역전파로 학습됐죠. 그런데 역전파를 빼고, 그것도 파인튜닝이 아니라 처음부터 학습하는 사전학습을 해냈다고 하니 꽤 도발적인 주장이에요.
Dust의 구체적인 알고리즘과 실험 수치는 원문에 자세히 나와 있으니 꼭 같이 읽어 보세요. 이 글에서는 원문을 제대로 읽는 데 필요한 배경을 정리할게요. 역전파의 무엇이 문제인지, 지금까지 어떤 대안이 나왔는지, 이런 결과를 어떤 기준으로 봐야 하는지예요.
역전파가 뭐냐면
모델이 답을 내면 먼저 정답과 얼마나 다른지(손실, loss)를 계산해요. 역전파는 이 '틀린 정도'를 출력층에서 입력층 쪽으로 거꾸로 보내면서, 가중치 하나하나가 오답에 얼마나 책임이 있는지(기울기, gradient)를 계산하는 방법이에요. 프로젝트가 실패했을 때 최종 결과물부터 거슬러 올라가며 단계별 책임을 따지는 것과 비슷해요. 수학적으로는 미분의 연쇄 법칙(chain rule)을 계속 적용하는 거고요.
정확하고 효율적이라 표준이 됐지만, 단점도 분명해요.
- 메모리: 거꾸로 계산하려면 순전파 때 만든 중간값(activation)을 전부 저장해 둬야 해요. 그래서 학습은 추론보다 메모리를 훨씬 많이 써요.
- 잠금 문제: 앞쪽 층은 뒤쪽 층의 역전파가 끝날 때까지 업데이트를 못 하고 기다려야 해요. 여러 GPU에 층을 나눠 학습할 때 GPU가 노는 시간이 생기는 원인이에요.
- 하드웨어 제약: 미분을 정밀하게 계산해야 해서, 연산이 부정확한 아날로그 칩이나 뉴로모픽 칩에서는 쓰기 어려워요.
- 생물학적 타당성: 뇌는 이런 식으로 오차를 정확히 거꾸로 보내지 않을 거라는 지적도 오래전부터 있었어요.
지금까지 나온 대안들
2016년에 나온 피드백 정렬(Feedback Alignment)은 오차를 거꾸로 보낼 때 실제 가중치 대신 무작위 고정 행렬을 써도 학습이 된다는 걸 보여줬어요. 출력 오차를 각 층에 바로 보내는 DFA라는 변형도 있고요. 하지만 규모가 커질수록 역전파와의 성능 격차가 벌어졌어요.
힌턴이 2022년에 제안한 Forward-Forward는 순전파를 두 번 돌려요. 각 층이 진짜 데이터와 가짜 데이터를 구분하도록 각자 따로 학습하는 방식이에요. 0차 최적화(zeroth-order) 계열은 가중치를 살짝 흔들어 보고, 손실이 어떻게 바뀌는지로 기울기를 추정해요. 2023년에 나온 MeZO는 이 방식으로 추론할 때 정도의 메모리만 써서 LLM을 파인튜닝했어요. 진화 전략(ES)도 비슷한 원리로 최근 LLM 규모까지 확장되고 있어요. 2025년의 NoProp은 확산 모델 아이디어를 빌려 각 층이 독립적으로 학습하도록 했고요.
이 방법들에는 공통된 한계가 있었어요. 파인튜닝이나 작은 모델에서는 꽤 잘 되는데, 무작위 초기값에서 시작하는 대규모 사전학습에서는 학습 신호가 너무 약해서 잘 안 됐어요. 파라미터가 많을수록 '흔들어 보고 추정하는' 방식의 오차가 커지거든요. Dust가 '사전학습'을 강조하는 이유가 바로 여기 있어요.
이런 결과를 볼 때 체크할 포인트
1. 규모: 파라미터가 몇 개인 모델을, 몇 토큰으로 학습했나요?
2. 같은 연산량 기준 비교: 같은 FLOPs를 썼을 때 역전파와 비교해 손실이 얼마나 차이 나나요?
3. 이득의 출처: 메모리를 아낀 건지, 병렬화가 쉬워진 건지, 전체 학습 시간이 줄어든 건지 따져 보세요.
4. 스케일링 곡선: 모델이 커질수록 역전파와의 격차가 줄어드나요, 벌어지나요?
특히 4번이 중요해요. 지금 GPU와 소프트웨어 스택은 역전파에 맞춰 극도로 최적화돼 있어요. 그래서 새 알고리즘은 아이디어가 좋아도 Sara Hooker가 말한 '하드웨어 복권(hardware lottery)'에서 불리해요. 작은 규모에서 이겼다는 것보다, 규모가 커질 때 격차가 어떻게 변하는지가 진짜 판단 기준이에요.
한국 개발자에게 주는 시사점
당장 실무에서 PyTorch의 loss.backward()를 버릴 일은 없어요. 그래도 눈여겨볼 지점은 있어요. 메모리가 아주 빠듯한 온디바이스 학습에서는 순전파만으로 학습하는 기법이 실제로 쓸모가 있어요. 퓨리오사AI나 리벨리온처럼 추론용 NPU를 만드는 국내 기업 입장에서도 관심 가질 만한 흐름이에요. 추론 칩에서 가벼운 학습까지 할 수 있게 되는 시나리오와 이어지거든요.
공부하는 입장에서는 역전파를 '당연한 것'이 아니라 '여러 선택지 중 하나'로 보게 되는 계기가 될 거예요. Karpathy의 micrograd로 자동미분을 직접 구현해 보세요. MeZO 같은 0차 최적화 코드도 돌려서 메모리 사용량을 비교해 보고요. 그러면 이런 연구들이 무엇을 해결하려는지 몸으로 이해하게 될 거예요.
마무리
한 줄 정리: 역전파 없는 학습은 오래된 꿈이에요. 관건은 '작은 규모에서 된다'가 아니라 '규모를 키워도 버틴다'를 보여주는 거예요.
역전파의 대안이 주류가 되려면 성능 격차가 어느 정도까지 좁혀져야 할까요? 아니면 알고리즘보다 그걸 위한 전용 하드웨어가 먼저 나와야 할까요?
🔗 출처: Hacker News