고래가 '말'을 한다면, 컴퓨터로 알아들을 수 있을까
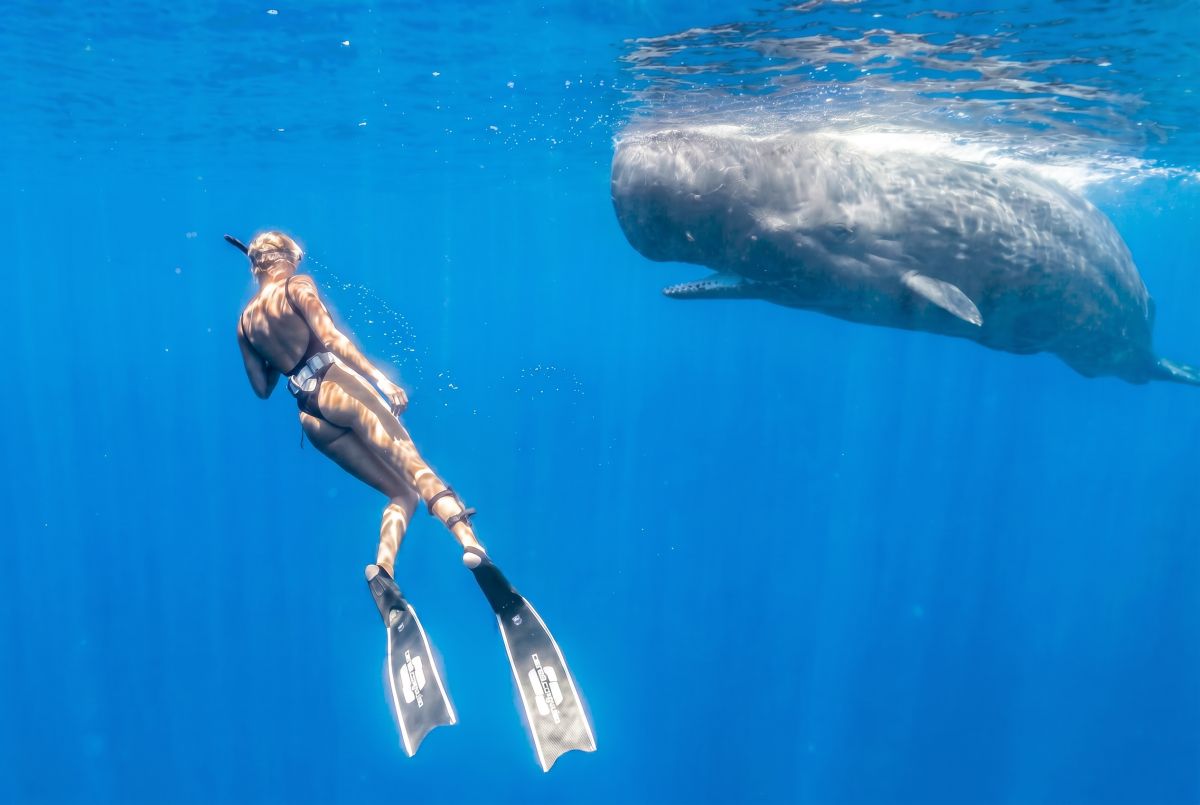
향유고래(sperm whale)는 지구에서 가장 큰 뇌를 가진 동물이에요. 이 고래들은 '코다(coda)'라고 부르는 딸깍거리는 클릭음 묶음으로 서로 소통해요. 모스 부호처럼 '딸깍-딸깍-딸깍딸깍' 하는 리듬 패턴이죠. 해양생물학자들이 수십 년 동안 이 소리를 녹음하고 분류해왔지만, 이게 정말 '언어'인지 단순한 신호인지는 여전히 풀리지 않은 질문이었어요.
최근 이 질문에 AI와 머신러닝이 본격적으로 뛰어들었어요. 향유고래의 의사소통을 해독하려는 연구가 계속 이어지고 있는데, 가장 대표적인 게 Project CETI(Cetacean Translation Initiative, 고래류 번역 프로젝트)예요. 해양생물학자, 로봇공학자, 언어학자, 머신러닝 연구자가 한 팀이 되어 카리브해 도미니카 연안에 사는 향유고래 가족들을 오랫동안 관찰하고 있어요.
데이터 모으는 것부터가 엄청난 엔지니어링이에요
ML을 해보신 분들은 아실 거예요. 모델보다 중요한 게 데이터잖아요. 고래 언어 연구에서도 가장 어려운 부분이 바로 데이터 수집이에요.
사람 언어로 대형 언어 모델(LLM)을 학습시킬 때는 인터넷에 있는 수조 개의 단어를 쓰지만, 고래 소리는 누가 대신 모아주지 않아요. 그래서 이런 프로젝트들은 바닷속에 수중 마이크(하이드로폰)를 여러 대 설치하고, 고래 몸에 흡착판 태그를 붙였다가 나중에 회수해요. 태그에는 소리뿐 아니라 수심, 움직임, 주변 상황까지 기록돼요. 드론으로 수면 위 행동을 찍고, 어떤 소리를 어떤 고래가 냈는지 '누가 말했는지'를 구분하는 작업도 해요.
이게 왜 중요하냐면, 언어를 이해하려면 소리만으로는 부족하고 맥락이 있어야 하거든요. '밥 먹자'라는 말을 이해하려면 그 말이 식사 직전에 나온다는 맥락을 알아야 하잖아요. 마찬가지로 고래가 특정 코다를 낼 때 무엇을 하고 있었는지가 함께 기록돼야 그 의미를 추론할 수 있어요.
AI가 찾아낸 '향유고래 음성 알파벳'
2024년에 CETI 연구진이 학술지 네이처 커뮤니케이션즈에 흥미로운 논문을 발표했어요. 코다 수천 개를 분석해보니, 향유고래 소리는 고정된 몇 가지 패턴을 반복하는 게 아니라 여러 요소를 조합하는 구조를 갖고 있었다는 거예요.
연구진은 코다의 특징을 네 가지로 나눴어요. 전체 속도인 템포(tempo), 클릭 사이 간격의 패턴인 리듬(rhythm), 주고받는 대화 속에서 템포가 조금씩 느려지거나 빨라지는 루바토(rubato), 그리고 코다 끝에 클릭을 하나 덧붙이는 장식음(ornamentation)이에요. 음악 용어를 빌려온 게 재밌죠. 이 요소들이 조합되면서 기존에 알려진 것보다 훨씬 많은 종류의 코다가 만들어진다는 걸 보여줬고, 연구진은 이걸 '향유고래 음성 알파벳'이라고 불렀어요. 그 뒤에는 클릭음의 주파수 특성에서 사람 말의 모음과 비슷한 패턴이 보인다는 분석도 나왔고요.
사람 언어로 비유하면, 우리가 자음과 모음 몇십 개를 조합해서 수많은 단어를 만드는 것처럼 고래도 기본 요소를 조합해서 표현의 폭을 넓히고 있을지도 모른다는 거예요. 그렇다고 '고래가 문장을 말한다'는 뜻은 아니에요. 조합하는 구조가 있다는 것과 그 조합에 의미가 담겨 있다는 건 별개의 문제거든요. 연구는 아직 '문법의 흔적'을 찾는 단계에 더 가까워요.
어떤 머신러닝 기법이 쓰일까
개발자 입장에서 흥미로운 점은 '정답 라벨이 없는 데이터'를 다룬다는 거예요. 고양이 사진을 분류할 때처럼 사람이 정답을 달아줄 수가 없잖아요. 고래 말의 뜻을 아는 사람이 아무도 없으니까요.
그래서 주로 쓰는 게 자기지도학습(self-supervised learning)이에요. 이게 뭐냐면, 데이터 안에서 스스로 문제를 만들어 학습하는 방식이에요. 예를 들어 코다가 이어진 순서에서 일부를 가려놓고 '다음에 올 코다는 뭘까?'를 맞히게 하는 거죠. GPT가 다음 단어를 예측하면서 언어를 배우는 것과 같은 원리예요. 이렇게 학습한 모델이 어떤 패턴은 잘 예측하고 어떤 상황에서는 틀리는지를 분석하면, 거꾸로 고래 소리의 구조를 추적할 수 있어요.
다른 하나는 비지도 군집화(clustering)예요. 비슷한 소리끼리 자동으로 묶어서, 사람이 미처 구분하지 못했던 유형을 찾아내는 방식이에요.
업계 맥락: 동물 언어 AI는 이제 하나의 분야예요
고래만 연구하는 게 아니에요. 비영리 단체 Earth Species Project는 여러 동물의 소리를 다루는 범용 오디오 모델을 연구하고 있고, 구글은 2025년에 돌고래 소리를 학습한 DolphinGemma라는 모델을 공개했어요. 공통된 흐름은 'LLM에서 효과를 본 대규모 사전학습 방식을 동물 소리에도 적용해보자'는 거예요.
다만 사람 언어와 결정적으로 다른 점이 있어요. 사람 언어 번역 모델은 영어-한국어 같은 번역 쌍이 엄청나게 많지만, 고래-사람 번역 쌍은 하나도 없어요. 그래서 이 분야의 진짜 과제는 모델 크기가 아니라 의미를 어떻게 검증하느냐예요. 특정 코다를 들려주고 고래가 예상한 반응을 보이는지 확인하는 '재생 실험'이 거론되는데, 고래에게 함부로 소리를 들려주는 것 자체가 윤리적 논쟁거리이기도 해요.
한국 개발자에게 주는 시사점
당장 실무에 쓸 기술은 아니지만 배울 점은 분명해요. 첫째, 라벨 없는 시계열 오디오 데이터를 다루는 방법론은 제조 설비의 이상음 탐지, 의료 음성 분석, 음향 모니터링 같은 국내 산업 현장에도 그대로 쓸 수 있어요. 둘째, 도메인 전문가(여기서는 해양생물학자)와 ML 엔지니어가 긴밀하게 협업하는 구조는 어떤 AI 프로젝트에서든 성패를 가르는 요소예요. 한국 바다에도 상괭이나 남방큰돌고래 같은 고래류가 살고 있으니, 국내 연구에 이런 방법론을 적용할 여지도 충분해요.
마무리
한 줄로 정리하면, 고래 언어 해독은 LLM의 학습 방식을 사람이 아닌 존재에게 적용해보는 가장 야심 찬 실험 중 하나예요.
정말로 고래의 말을 번역할 수 있게 된다면, 가장 먼저 무엇을 물어보고 싶으세요? 그리고 AI로 만든 소리를 동물에게 들려주는 실험은 어디까지 허용돼야 한다고 생각하세요?
🔗 출처: Hacker News