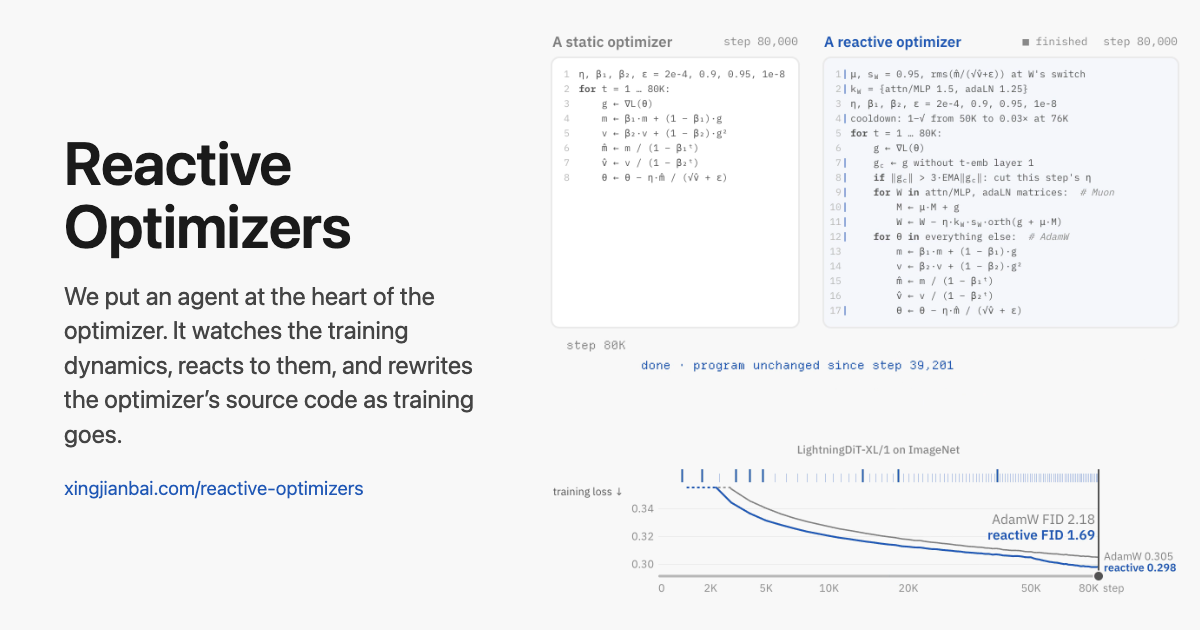
손실 그래프를 지켜보며 밤새던 일을 자동으로
딥러닝 모델을 학습시켜 본 분이라면 이런 경험이 있으실 거예요. 학습을 걸어두고 손실(loss) 그래프를 보는데, 어느 순간 그래프가 튀거나 평평해지면서 더 이상 내려가지 않아요. 그러면 학습을 멈추고 학습률(learning rate)이나 스케줄을 손본 다음 체크포인트에서 다시 시작하죠. 큰 모델을 학습하는 팀에서는 사람이 밤새 모니터링하면서 이 일을 하기도 하거든요.
리액티브 옵티마이저(Reactive Optimizers)는 이 과정을 한 단계 더 밀어붙인 아이디어예요. 하이퍼파라미터 숫자 몇 개를 바꾸는 데서 그치지 않고, 학습이 진행되는 도중에 옵티마이저의 소스 코드 자체를 다시 쓰자는 거예요. 학습 상황을 지켜보는 주체(LLM 에이전트를 떠올리면 쉬워요)가 지표를 보고 '지금은 이런 업데이트 규칙이 더 맞겠다'고 판단해서 코드를 바꾸고, 학습은 바뀐 코드로 이어서 진행돼요.
옵티마이저부터 짚고 갈게요
옵티마이저는 모델 가중치를 '어느 방향으로, 얼마나' 움직일지 정하는 규칙이에요. 눈을 가린 채 산을 내려가는 상황에 비유하면 기울기(gradient)는 발밑의 경사이고, 옵티마이저는 그 경사를 보고 어느 쪽으로 몇 걸음 갈지 정하는 걸음걸이 전략이라고 보면 돼요.
가장 단순한 SGD는 w = w - lr * grad 한 줄이에요. Adam은 여기에 기울기의 이동평균(모멘텀)과 기울기 크기의 이동평균을 더해서 파라미터마다 보폭을 다르게 잡아요. 최근에는 행렬 단위로 업데이트를 정규화하는 Muon 같은 옵티마이저도 많이 쓰이고요. 그런데 지금까지 이 규칙은 학습 시작 전에 정해지고 끝날 때까지 고정이었어요. 학습 중에 바뀌는 건 학습률 스케줄 정도였죠.
핵심 아이디어는 코드 자체를 바꾸는 것
리액티브 옵티마이저는 '옵티마이저는 고정된 알고리즘'이라는 전제를 깨요. 흐름을 대략 그려보면 이래요.
1. 학습을 일정 스텝 진행하면서 손실, 기울기 노름(기울기의 크기), 업데이트 크기 같은 신호를 기록해요.
2. 관찰자가 이 신호를 읽고 '손실이 진동한다', '특정 레이어의 기울기가 폭주한다' 같은 식으로 문제를 진단해요.
3. 진단에 맞춰 옵티마이저의 step() 함수를 고쳐요. 클리핑을 넣거나, 모멘텀 계산 방식을 바꾸거나, 레이어마다 다른 규칙을 적용하는 식이에요.
4. 모멘텀 버퍼 같은 옵티마이저 상태를 최대한 넘겨받아서 새 코드로 학습을 계속해요.
기존 하이퍼파라미터 튜닝과 가장 크게 다른 점은 탐색할 수 있는 범위예요. 학습률을 0.001에서 0.0005로 바꾸는 건 숫자 하나를 조정하는 일이지만, 코드를 바꿀 수 있으면 사람이 미리 떠올리지 못한 규칙까지 시도해볼 수 있거든요. 그만큼 위험도 커요. 잘못된 코드 한 줄이 학습 전체를 망칠 수 있으니까요. 그래서 이런 방식에는 짧은 구간에서 먼저 시험해보고, 결과가 나빠지면 이전 버전으로 되돌리는 안전장치가 꼭 함께 있어야 해요.
업계 맥락: 비슷한 시도들과 비교
이 아이디어가 갑자기 나온 건 아니에요. 몇 갈래의 흐름이 만나는 자리에 있거든요.
- 학습된 옵티마이저(Learned Optimizers): 구글의 VeLO처럼 옵티마이저 자체를 신경망으로 만들어 학습시키는 연구가 있었어요. 다만 결과가 블랙박스라서 왜 그렇게 움직이는지 해석하기 어려웠죠. 코드를 고치는 방식은 결과물이 사람이 읽을 수 있는 코드라는 점이 달라요.
- 심볼릭 탐색: 구글이 프로그램 탐색으로 Lion 옵티마이저를 찾아낸 연구도 규칙을 코드 형태로 탐색했다는 점에서 닮았어요. 다만 그건 학습 전에 오프라인으로 찾아낸 고정 규칙이었고, 리액티브 방식은 학습 '도중'에 반응한다는 차이가 있어요.
- Population Based Training(PBT): 딥마인드의 PBT는 여러 학습을 병렬로 돌리면서 학습 중에 하이퍼파라미터를 바꿔 끼워요. 학습 중에 적응한다는 점은 같지만 바꾸는 대상이 숫자에 머물러요.
- LLM 기반 코드 진화: AlphaEvolve처럼 LLM이 코드를 제안하고 평가하면서 개선하는 흐름이 요즘 활발한데, 리액티브 옵티마이저는 이 흐름을 학습 루프 안으로 가져온 형태라고 볼 수 있어요.
한국 개발자에게 주는 시사점
솔직히 당장 프로덕션 학습 파이프라인에 넣을 기술은 아니에요. 재현성(같은 조건에서 같은 결과가 나오는지)이 크게 흔들릴 수 있고, 무엇이 왜 바뀌었는지 기록해두지 않으면 디버깅이 정말 힘들어지거든요.
그래도 배워둘 점은 분명해요. 첫째는 학습 모니터링 지표를 꼼꼼히 남기는 습관이에요. 손실만 보지 말고 레이어별 기울기 노름이나 가중치 대비 업데이트 비율까지 기록해두면, 자동화든 사람이든 진단이 훨씬 쉬워져요. 둘째는 옵티마이저 코드를 직접 열어보는 경험이에요. PyTorch의 torch.optim.Optimizer를 상속해서 커스텀 옵티마이저를 한 번 짜보면 Adam이 실제로 무슨 일을 하는지 감이 확 와요. 셋째는 에이전트가 실험 루프 안으로 들어오는 흐름 그 자체예요. 작은 모델로 실험하는 연구실이나 스타트업이라면, 사람이 하던 '보고, 고치고, 다시 시작하는' 일을 에이전트에게 맡겨보는 실험은 충분히 해볼 만해요.
마무리
한 줄 정리: 옵티마이저는 고정된 공식이 아니라, 학습 상황에 반응해 다시 쓰일 수 있는 코드일 수도 있다는 발상이에요.
여러분이라면 학습 중에 스스로 바뀌는 옵티마이저를 믿고 맡길 수 있을까요? 재현성과 성능 사이에서 어디까지 허용할 수 있을지 의견 나눠주세요.
🔗 출처: Hacker News