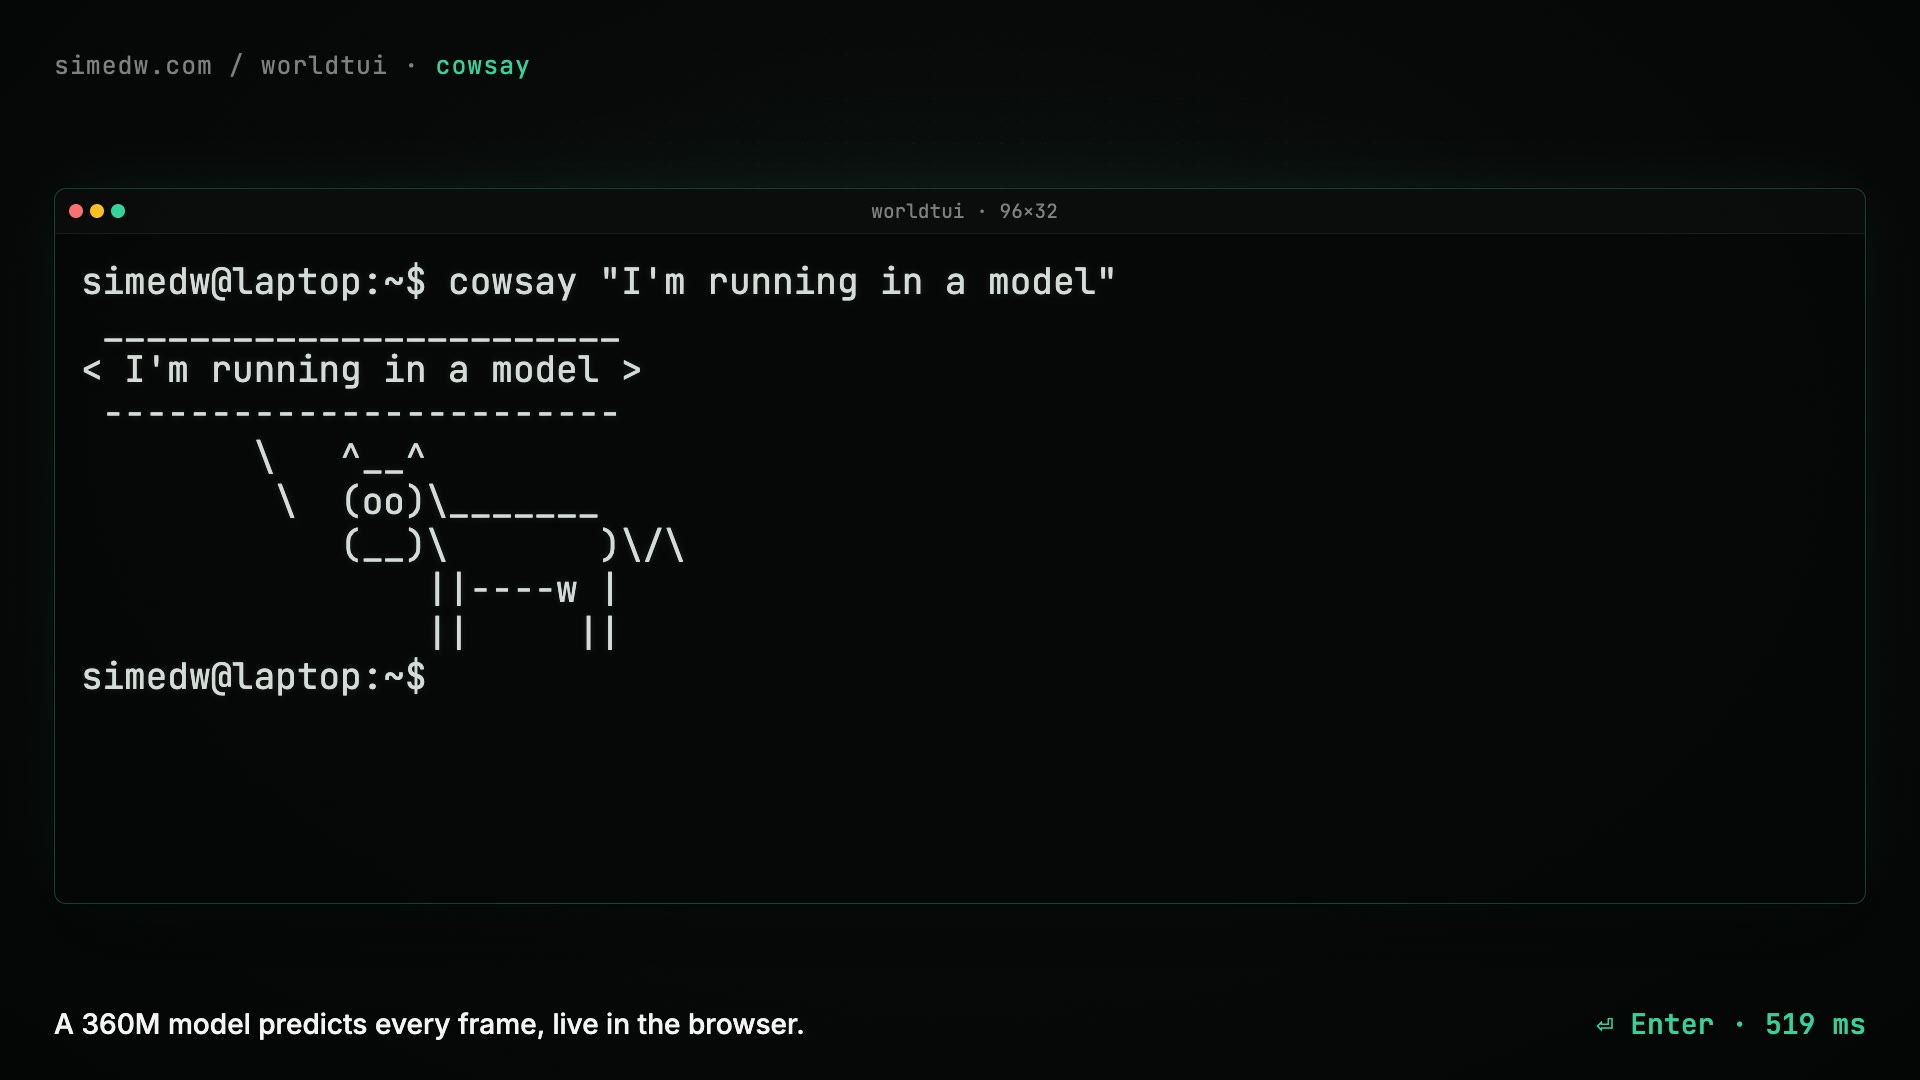
애플리케이션을 코드로 작성하는 대신 모델이 학습해서 '만들어내는' 미래는 오랫동안 연구자들의 상상 속 주제였다. 구글 딥마인드의 Genie 3처럼 사용자의 입력으로부터 다음 화면을 통째로 예측하는 월드 모델이 등장하면서, 게임 엔진이 장면을 렌더링하듯 모델이 프레임을 예측하는 방식이 현실성을 얻기 시작했다. WorldTUI는 이 아이디어를 거대한 GPU 클러스터나 방대한 영상 데이터 없이 개인이 검증해 본 사례다. 개발자는 야심을 게임 세계가 아니라 터미널로 축소했고, Qwen2.5-Coder-0.5B를 기반으로 미세조정해 '셸도 파일시스템도 없이 화면 변화만 예측하는 터미널'을 만들었다.
터미널이 월드 모델의 학습 대상으로 적합했던 이유는 분명하다. 터미널은 픽셀이 아니라 문자 격자이며, 실제 셸을 Docker 컨테이너 안에서 돌리면 키 입력과 그에 따른 화면 변화가 완벽하게 라벨링된 학습 데이터를 원하는 만큼 생성할 수 있다. 게다가 사전학습된 언어 모델은 ls나 cat이 무엇을 출력해야 하는지 이미 어느 정도 알고 있다. 저자가 정말 확인하고 싶었던 것은 단순히 그럴듯한 출력을 내는 수준을 넘어, 일관된 '세계'를 유지할 수 있는가였다.
화면을 토큰으로 다루는 방식
일반적인 LLM은 프롬프트 뒤에 토큰을 하나씩 이어 붙이지만, 터미널은 그 구조에 맞지 않는다. vim에서 esc 한 번이 상태를 바꾸고, clear는 화면을 지운 뒤 커서를 맨 위로 돌려보낸다. 그래서 WorldTUI는 텍스트 스트림이 아니라 화면 격자에 대한 '변경'을 예측하도록 설계됐다. 세션은 화면 크기, 내용, 커서 위치를 담은 스냅샷으로 시작하고, 이후 각 키 입력은 실제 터미널이 보내는 원시 바이트 그대로 들어간다. 모델은 어느 행을 어디서부터 다시 쓸지와 커서의 최종 위치를 답한다. Qwen이 256개 바이트 값에 대한 토큰을 이미 갖고 있어 문자·좌표·작은 숫자를 그대로 재활용했고, 전체 어휘는 바이트 토큰 256개, 행 토큰 64개에 몇몇 특수 연산을 더한 333개로 압축됐다. 디코딩은 문법 제약을 받아 모든 예측이 유효한 화면 갱신이 되도록 했다.
화면 전체를 다시 그리면 약 3,000토큰이 들기 때문에, 스크롤처럼 행을 위로 밀어 올리는 동작은 이전 화면의 행을 복사하는 연산으로 처리했다. 덕분에 스크롤 비용이 행당 약 96토큰에서 3토큰으로 줄었고, 같은 기법이 화면 지우기, vim의 행 삽입·삭제, man 페이지 탐색에도 쓰였다.
스스로 실수를 고치게 하기
단순 지도학습만으로는 글자가 나타나고 백스페이스로 지워지는 일상적 타이핑은 금방 배웠지만, 긴 세션에서는 파일명의 사소한 실수가 이후 전체로 전파되며 오류가 누적됐다. 저자는 모델이 이상적 시연이 아니라 자신이 실제로 거쳐간 상태에서 배우도록 하는 DAgger 방식을 차용해, 틀린 화면을 올바른 다음 화면으로 되돌리는 델타를 학습시켰다. 핵심 제약은 교정에 등장하는 단어가 앞선 실제 화면이나 사용자 입력에 이미 나타났어야 한다는 점이다. 모델이 한 번도 본 적 없는 파일명을 지어내 고치도록 가르치면 오히려 환각을 보상하게 되기 때문이다. 이 자기교정은 효과가 컸다. 추가 데이터와 함께 PresetBench 점수를 int4 기준 24/47에서 38/47로 끌어올렸다. 모델 학습과 이후 개선에는 RTX 4090 기준 약 75 GPU시간이 들었다.
병렬 디코딩과 기억이라는 숙제
실시간성을 위해서는 전체 재그리기에 최대 12초가 걸리는 순차 생성이 치명적이었다. 저자는 한 프레임의 대부분 행이 서로 독립적이라는 점에 착안해 행마다 배치 원소를 두고 동시에 생성했고, 디코딩 비용을 모든 행의 합에서 가장 긴 행 길이로 줄여 큰 프레임의 p95 지연을 6.7초에서 0.87초로 낮췄다. 다만 행들이 서로 조율하지 못해 vim이 0행 대신 3행에서 열리는 문제가 생겼고, 이를 같은 모델을 초안 작성과 검증에 모두 쓰는 자기 추측 디코딩으로 보완했다. 메모리 테스트에서 WorldTUI는 13개 중 9개의 값을 정확히 되읽어 프롬프트 기반 모델의 2~3개를 크게 앞섰다. tmux로 vim에서 파일을 고쳐 저장한 뒤 다른 창에서 cat으로 바뀐 내용을 확인했을 때, 저자는 프랑켄슈타인 박사가 된 기분이었다고 적었다.
흥미로운 발견은 모델을 더 적은 레이어로 증류하는 과정에서 나왔다. 레이어 7 하나만 제거해도 다음 토큰 정확도는 99.3%에서 98.9%로 거의 변하지 않았지만, 정확한 메모리 되읽기는 64/64에서 0/64로 무너졌다. 특정 레이어(1, 7, 15, 22)를 유지한 16레이어 학생 모델은 4비트 약 138MB 크기로 32개 세계를 모두 통과한 반면, 그 레이어를 버린 학생은 겉보기엔 멀쩡한 터미널 출력을 내면서도 두 값 중 틀린 쪽을 절반쯤 골라냈다. 즉 모델은 겉으로 멀쩡해 보이면서도 조용히 기억을 잃을 수 있다는 뜻이다.
실무자가 눈여겨볼 지점과 한계
WorldTUI는 아직 신뢰할 만한 파일시스템과는 거리가 멀다. 익숙한 명령은 그럭저럭 처리하지만 새로운 방식으로 조합하면 쉽게 깨지고, echo green >> colors 뒤에 cat colors를 해도 추가된 줄이 안 보이는 경우가 흔하다. 그럼에도 이 실험이 주는 함의는 작지 않다. 완벽히 라벨링된 데이터를 저렴하게 찍어낼 수 있는 좁은 도메인에서는, 개인 수준의 자원으로도 상태를 기억하는 월드 모델을 만들 수 있음을 보여준다. 또한 자기교정 학습이 오류 누적을 억제하는 실용적 수단이라는 점, 독립적 단위를 병렬로 디코딩하면서 검증으로 일관성을 되찾는 설계, 그리고 다음 토큰 정확도 같은 거친 지표가 기억 능력의 상실을 가리는 함정이라는 교훈은 생성 모델을 다루는 엔지니어에게 두루 적용된다. 모델 전체는 int4 양자화로 208MB까지 줄어 WebGPU 기반으로 브라우저 탭 안에서 로컬 추론으로 돌아가며, pythoon처럼 존재하지 않는 명령을 쳐 보면 그것이 진짜 셸이 아님을 금방 알 수 있다.