이미지 생성 AI로 시장 데이터를 만든다?
미드저니나 스테이블 디퓨전 같은 이미지 생성 AI는 이제 익숙하시죠. 노이즈에서 출발해 조금씩 그림을 다듬어 가는 디퓨전(diffusion) 모델이 그 뒤에 있어요. 그렇다면 같은 원리로 주가나 호가 같은 시장 데이터도 만들어낼 수 있을까요?
세계적인 퀀트 트레이딩 회사 제인 스트리트(Jane Street)가 기술 블로그에서 바로 이 질문을 파고들었어요. 키워드는 자기회귀 디퓨전(autoregressive diffusion)이에요. 이름은 어렵게 들리지만 하나씩 풀어보면 생각보다 직관적이에요.
왜 가짜 시장 데이터가 필요할까
'진짜 데이터가 있는데 왜 가짜를 만들어?'라는 의문이 들 수 있어요. 금융 데이터에는 근본적인 한계가 있거든요.
- 역사는 한 번뿐이에요. 2008년 금융위기나 2020년 코로나 폭락은 딱 한 번씩만 일어났어요. 전략을 검증하고 싶어도 극단적인 상황의 샘플이 너무 적죠.
- 과적합(overfitting) 위험: 같은 과거 데이터로 전략을 계속 다듬으면 과거에만 딱 맞고 미래엔 안 통하는 전략이 나오기 쉬워요. 기출문제만 달달 외운 학생 같은 거죠.
- 스트레스 테스트: '변동성이 지금의 두 배가 되면?' 같은 가상의 시나리오를 그럴듯하게 만들어 보고 싶을 때도 있어요.
자기회귀 + 디퓨전, 이게 뭐냐면
두 개념을 따로 먼저 볼게요.
자기회귀(autoregressive)는 '지금까지의 흐름을 보고 다음 하나를 예측'하는 방식이에요. ChatGPT 같은 언어 모델이 앞 단어들을 보고 다음 단어를 하나씩 이어 붙이는 게 대표적이죠. 과거 다음에 현재가 오는 시계열 데이터와 궁합이 좋아요.
디퓨전은 깨끗한 데이터에 노이즈를 조금씩 섞어 망가뜨리는 과정을 학습한 뒤, 거꾸로 노이즈에서 데이터를 복원하는 방식이에요. 강점은 복잡한 확률 분포를 잘 표현한다는 거예요. '다음 값은 평균 얼마' 하고 숫자 하나를 내놓는 게 아니라, '이럴 수도 저럴 수도 있다'는 다양한 가능성 자체를 샘플링할 수 있죠.
둘을 합치면 이런 구조가 돼요.
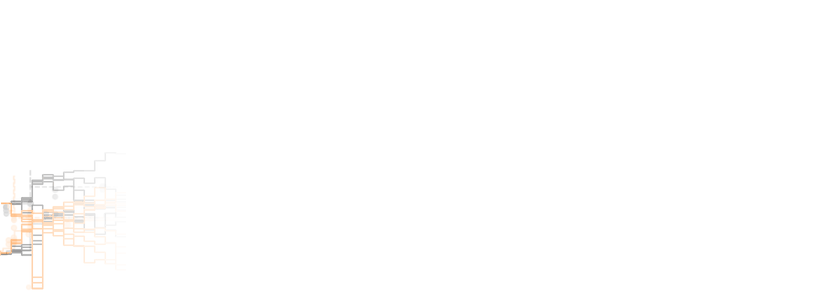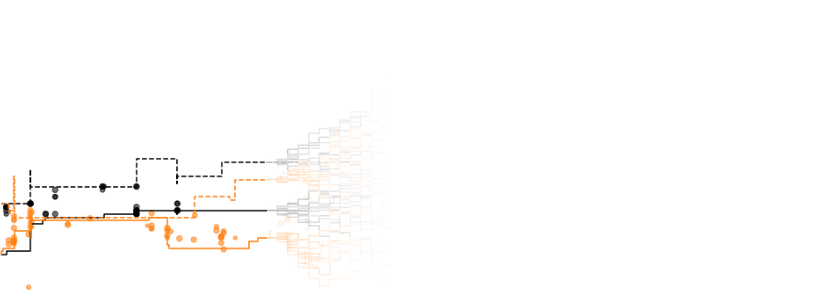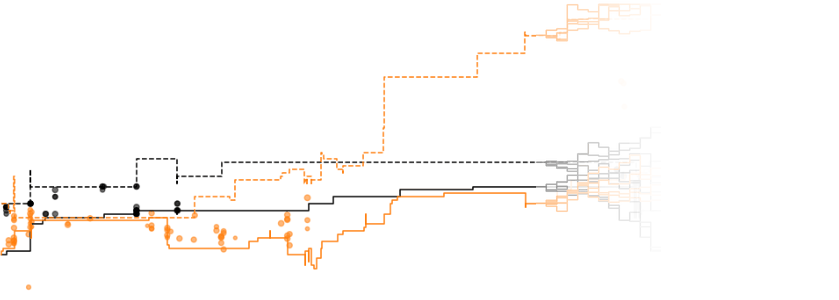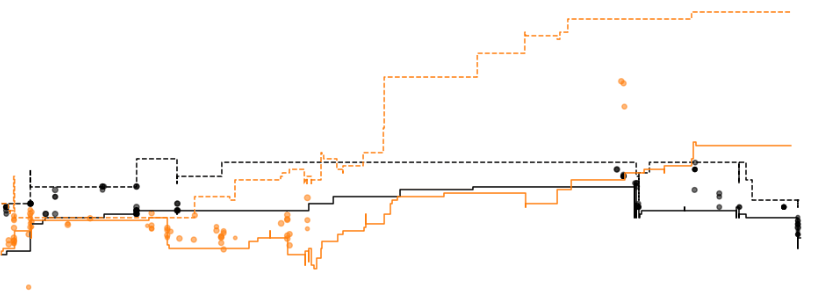
> 과거 구간을 조건으로 → 디퓨전으로 다음 시점 값을 샘플링 → 그 값을 과거 구간에 이어 붙이고 → 다시 다음 시점을 샘플링 → 반복
이 아이디어는 시계열 예측(TimeGrad 등)이나 이미지·영상 생성(MAR, Diffusion Forcing 등) 연구에서도 활발히 탐구돼 왔어요. 언어 모델은 단어라는 정해진 선택지 중 하나를 고르면 되지만, 가격이나 수익률은 연속적인 값이라 다음 값의 분포를 표현하는 데 디퓨전이 잘 맞는 거예요.
시장 데이터가 유독 어려운 이유
그런데 시장 데이터는 고양이 사진보다 훨씬 까다로워요.
첫째, 신호에 비해 노이즈가 극단적으로 커요. 수익률은 거의 무작위처럼 움직이고, 예측 가능한 패턴은 아주 미세하죠. 둘째, 금융 데이터에는 스타일라이즈드 팩트(stylized facts)라는 특유의 성질이 있어요. 극단적인 움직임이 정규분포 예상보다 훨씬 자주 일어나는 두꺼운 꼬리(fat tail), 크게 출렁인 뒤엔 또 크게 출렁이는 변동성 군집(volatility clustering) 같은 것들이요. 가짜 데이터가 이걸 재현하지 못하면 쓸모가 없어요. 셋째, 시장은 계속 변해요. 10년 전과 지금은 참여자도, 규칙도 다르거든요.
무엇보다 평가가 어려워요. 이미지는 사람이 보고 '진짜 같다'고 판단할 수 있지만, 수익률 그래프는 사람 눈으로 진짜와 가짜를 가려내기 힘들어요. 그래서 통계적 성질을 비교하거나, 진짜·가짜를 구분하는 판별 모델을 돌려 보거나, 생성 데이터로 학습한 모델이 실제 데이터에서도 통하는지 확인하는 간접적인 방법을 써야 해요. 제인 스트리트가 어떤 실험을 했고 어떤 결과를 얻었는지는 원문에서 직접 확인해 보세요.
업계 맥락
금융 데이터 생성은 오래된 주제예요. 전통적으로는 GARCH(변동성이 시간에 따라 변하는 걸 표현하는 통계 모델) 같은 방법으로 시장의 출렁임을 흉내 냈고, 2010년대 후반엔 GAN 기반 연구(QuantGAN, TimeGAN 등)가 유행했어요. 가상의 시장 참여자들을 시뮬레이션하는 에이전트 기반 시뮬레이터도 있고요. 디퓨전은 GAN보다 학습이 안정적이고 다양한 샘플을 잘 뽑아내는 편이라, 이미지 분야에서 GAN을 밀어냈듯 시계열 분야에서도 비슷한 흐름이 이어지고 있어요.
한국 개발자에게 주는 시사점
퀀트나 핀테크에 관심 있다면 '생성 모델은 이미지·텍스트용'이라는 고정관념을 깨볼 좋은 기회예요. 디퓨전은 시계열, 센서 데이터, 서버 지표처럼 연속적인 값의 분포를 다루는 곳이라면 어디든 응용할 수 있거든요. 이상 탐지용 학습 데이터가 부족한 제조나 보안 분야에서도 같은 아이디어를 시도해 볼 수 있어요. 현업 트레이딩 회사가 직접 실험하며 고민한 내용을 공유하는 글은 논문만 읽을 때보다 실무 감각을 키우는 데 큰 도움이 돼요.
마무리
한 줄 정리: 시장 데이터 생성의 진짜 난제는 '만드는 것'보다 '진짜 같은지 판단하는 것'이다.
여러분이라면 AI가 만든 가상 시장 데이터로 검증한 전략에 실제 돈을 넣을 수 있을까요? 생성 모델을 이미지·텍스트가 아닌 다른 데이터에 써본 경험이 있다면 공유해 주세요.
🔗 출처: Hacker News