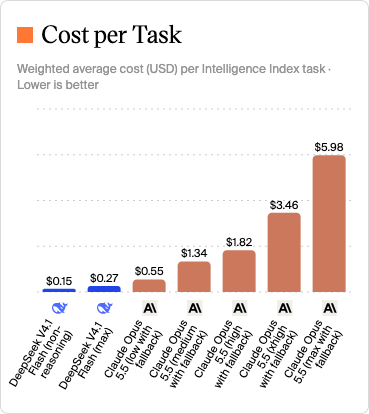
한 개발자가 자신의 블로그에 올린 글이 작은 논쟁을 불러왔다. 그는 지난 한 달간 'DeepSeek 4.1 Flash'라는 모델을 열두 개 남짓한 프로젝트에 집중적으로 써왔는데, 세션 도중 모델 이름을 가리면 이것이 DeepSeek인지 Opus인지 구분하지 못하겠다고 말한다. 대화의 질, 작업 결과, 속도 어느 쪽에서도 차이를 느끼지 못했다는 것이다. 그는 이 모델에 'Pro' 등급이 없다는 사실도 개의치 않으며, 프런티어 모델처럼 행동하기에 프런티어 모델처럼 다룬다고 했다. 벤치마크가 아니라 어디까지나 주관적 사용 경험에 기반한 주장이라는 점은 그 자신도 분명히 밝히고 있다.
글의 핵심 질문은 도발적이다. 왜 프런티어 연구소들은 지금 당황하지 않는가. 그의 진단은 간단하다. 중국의 증류(distilled) 모델들이 Anthropic이나 OpenAI보다 한두 달 뒤처져 있을지언정 동일한 작업 부하를 감당할 수 있고, 결국 시장을 잠식하리라는 것이다. 학습 데이터의 출처를 둘러싼 논쟁 — 누가 누구의 데이터를 가져왔는가 — 에 대해서는 선을 긋는다. 대부분의 개발자는 그런 식으로 생각하지 않으며, 그저 지불한 돈 대비 최대 효용을 얻으려 할 뿐이라는 현실 인식이다.
'충분히 좋은' 모델이 일하는 방식을 바꾼다
이 글에서 실무자가 주목할 만한 대목은 비용이 작업 습관 자체를 바꾼다는 관찰이다. 필자는 월 10달러짜리 OpenCode 구독으로 DeepSeek를 사실상 무제한으로 쓰며, 하루 대부분을 돌리는 세션에서도 예상 비용이 1달러를 넘는 경우가 드물다고 말한다. 비용이 거의 0에 수렴하면 '무의미해 보이는' 작업을 돌리는 데 대한 심리적 저항이 사라진다. 바탕화면 파일을 정리시키는 일이 1달러가 아니라 0.003달러로 끝나니, 탐색적 UI 테스트나 단순 반복 작업을 거리낌 없이 던지게 된다는 것이다. 그는 이를 수학 박사에게 책상 파일 정리를 시키는 일에 비유하면서도, 비용이 낮아진 지금은 그런 낭비가 더 이상 문제가 아니라고 본다.
작업 방식도 구체적이다. 복잡한 기획과 리서치까지 저가 모델에 맡기고, 가끔 중요한 작업에서만 상위 모델을 불러 최종 코드 리뷰로 몇 가지 엣지 케이스를 잡은 뒤, 수정 실행은 다시 저가 모델에 넘긴다. 이때 상위 모델을 쓰는 이유조차 '품질'보다는 '문제를 새로운 눈으로 다시 보는 것'에 가깝다고 설명한다. 하나의 모델에 전부 의존하기보다 역할을 나눠 배치하는 접근으로, 비용 구조가 바뀌면 실무 파이프라인의 설계도 달라진다는 점을 보여준다.
비용 절감의 기술적 근거와 자가호스팅 논리
필자는 저비용의 배경으로 캐시 최적화를 든다. DeepSeek가 V1 대비 KV 캐시를 약 437배 줄였고, 긴 코딩 세션에서 이 캐시를 GPU 메모리에 유지하는 것이 가장 큰 비용 요인 중 하나이기에, 캐시를 줄인 것이 하루 종일 돌려도 1달러 미만이라는 결과로 이어졌다는 설명이다. 그는 이 효율이 전력과 물 사용을 줄여 환경에도 낫다고 주장하며, 같은 종류의 캐시 개선이 상위 모델의 효율 향상에도 작용했으리라 추정한다. 다만 이 수치와 인과 관계는 모두 블로그 글쓴이의 서술이며, 독립적으로 검증된 벤치마크나 연구소 공식 자료가 함께 제시된 것은 아니라는 점은 분명히 해둘 필요가 있다.
자가호스팅에 대한 그의 결론은 냉정하다. 4.1 Flash의 경제성 앞에서는 비용 절감을 목적으로 한 자가호스팅이 투자 회수에 이르지 못한다는 것이다. 다만 프라이버시가 목적이라면 기다려 보라고 권한다. 지금의 캐시 최적화가 결국 로컬 환경으로 내려올 것이고, 현 시점에도 4.1 Flash는 실용적이지는 않아도 기술적으로는 자가호스팅이 가능하다는 것이 그의 전망이다.
한국 실무자가 읽어야 할 지점
이 글은 측정 가능한 보고서가 아니라 한 개발자의 의견이다. 모델명과 버전, 437배 같은 수치, 효율 개선의 인과 등은 글쓴이의 주관과 추정에 기대고 있어, 도입 판단의 근거로 삼기에는 검증이 필요하다. 그럼에도 한국의 개발 조직이 가져갈 함의는 선명하다. 첫째, '최고 성능 = 최고 비용'이라는 전제를 당연시할 필요가 없다는 것. 둘째, 모델 비용이 작업당 수십 분의 일로 떨어지면 자동화의 적용 범위 자체가 넓어진다는 것. 셋째, 단일 최상위 모델에 몰아주기보다 기획·실행·검증에 서로 다른 등급의 모델을 배치하는 설계가 현실적 선택지가 된다는 것이다.
동시에 간과해선 안 될 한계도 있다. 학습 데이터 출처를 둘러싼 법적·윤리적 쟁점, 그리고 해외 모델에 코드와 데이터를 넘길 때의 보안·규제 리스크는 글쓴이가 의도적으로 비껴간 영역이다. 비용과 체감 성능만으로 모델을 고르기 어려운 환경에 있는 조직이라면, 저가 모델의 효용은 인정하되 데이터 거버넌스와 재현 가능한 자체 평가를 반드시 함께 올려두는 편이 안전하다. 결국 이 글의 가치는 특정 제품을 추천하는 데 있지 않고, 비용 곡선이 꺾이는 순간 일하는 방식이 어떻게 재편되는지를 한 개발자의 실사용으로 비춰 보여준다는 데 있다.