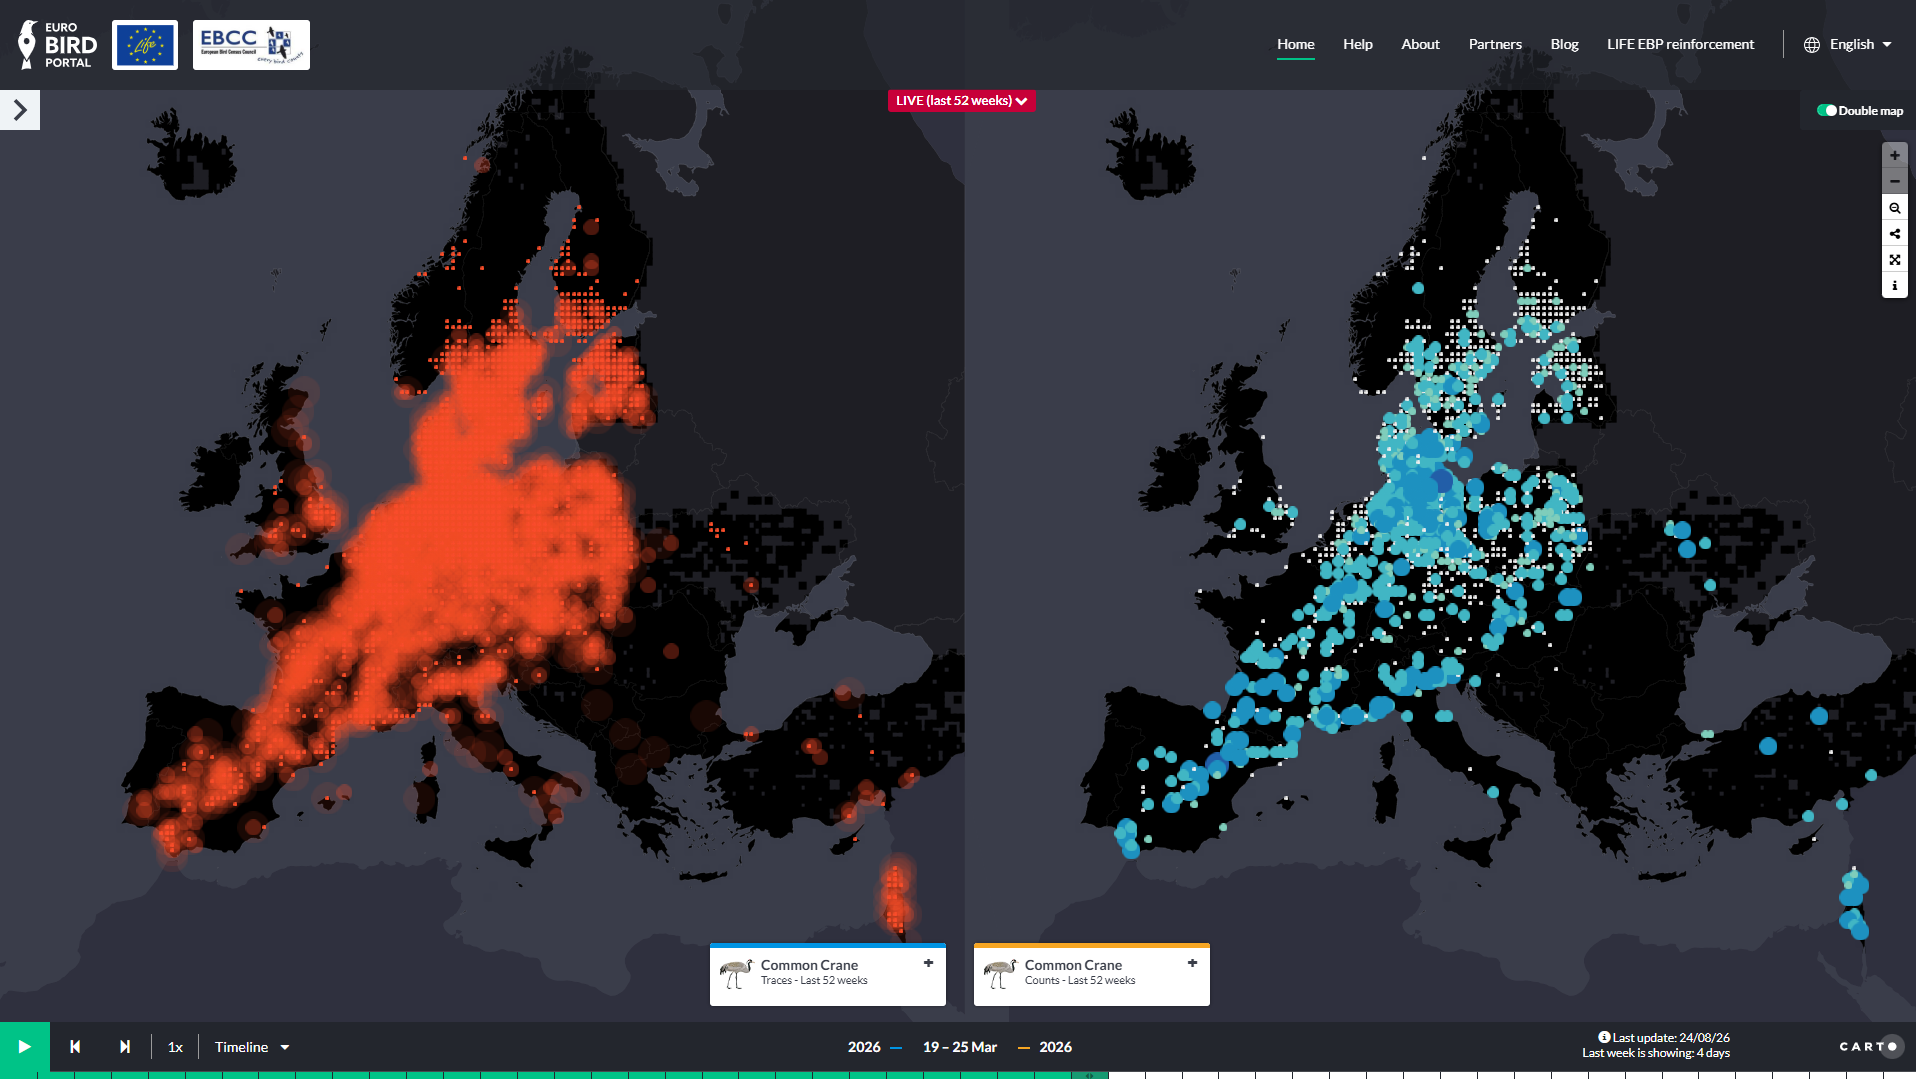
새들이 지금 어디쯤 날고 있는지, 대륙 전체를 한 장의 지도로
봄이 되면 제비가 아프리카에서 유럽으로 올라오고, 가을이면 다시 내려가죠. 그런데 「이번 주 제비가 유럽 어디까지 올라왔나」를 대륙 전체 규모로, 그것도 며칠 전 관찰까지 반영해서 지도로 볼 수 있다면 어떨까요? EuroBirdPortal(줄여서 EBP)이 바로 그걸 해주는 서비스예요. 유럽 조류 조사 협의회(EBCC)가 운영하는 프로젝트인데, 유럽 각국의 탐조 기록 사이트에 사람들이 올린 관찰 데이터를 모아서 종별, 주별 분포를 애니메이션 지도로 보여주거든요. 여기에 거의 실시간으로 갱신되는 LIVE 뷰어까지 붙어 있어서, 지금 이 순간 유럽의 새 이동을 들여다볼 수 있어요.
새 이야기 같지만, 개발자 입장에서 보면 이건 꽤 훌륭한 데이터 엔지니어링 사례예요. 나라마다 다른 시스템에서 나온 데이터를 매일 긁어모아 표준화하고, 통계적으로 보정한 뒤, 시공간 데이터를 시각화해서 서비스하는 파이프라인 전체가 들어 있거든요.
어떻게 돌아가는 걸까
먼저 데이터 출처부터 볼게요. 유럽에는 나라별로 탐조 기록을 올리는 온라인 포털이 따로 있어요. 영국의 BirdTrack, 독일과 프랑스, 스위스 등에서 쓰는 ornitho 계열 포털, 그리고 미국 코넬대에서 시작해 전 세계로 퍼진 eBird 같은 것들이죠. 이 포털들은 각자 자기 데이터베이스와 자기 스키마를 갖고 있어요. 같은 새를 두고도 종 코드가 다르고, 좌표 체계가 다르고, 「관찰 하나」를 정의하는 방식조차 달라요.
EBP는 이 포털들과 협약을 맺고 공통 포맷으로 데이터를 받아요. 핵심은 개별 관찰 기록의 정확한 위치를 그대로 가져오는 게 아니라, 격자 단위로 집계된 데이터를 받는다는 점이에요. 뷰어에서 보이는 지도는 30km 크기의 격자를 기준으로 그려지는데, 이렇게 하면 희귀종의 정확한 둥지 위치가 노출되는 걸 막을 수 있고 각 포털이 원본 데이터의 소유권을 그대로 유지할 수 있죠. 이런 구조를 연합형(federated) 모델이라고 하는데요, 이게 뭐냐면 데이터를 한군데 몽땅 복사해 오는 대신 각자 자기 데이터는 자기가 관리하고 약속된 형태의 집계 결과만 공유하는 방식이에요. 요즘 기업에서 이야기하는 데이터 메시와 비슷한 발상이죠.
규모도 만만치 않아요. 유럽 30개 가까운 나라에서 매년 1억 건이 넘는 관찰 기록이 이 파이프라인을 통과해요. 하루로 나누면 수십만 건이고, 봄가을 이동철에는 훨씬 몰리죠. LIVE 뷰어는 이 데이터를 매일 갱신해서 불과 며칠 전 관찰까지 지도에 반영해요.
그냥 점 찍으면 안 되는 이유: 관찰 노력 편향
여기서 통계적으로 재미있는 부분이 나와요. 관찰 기록을 그냥 지도에 찍으면 어떻게 될까요? 사람이 많이 사는 곳, 탐조 인구가 많은 나라에 점이 몰려요. 새가 많아서가 아니라 보는 사람이 많아서죠. 이걸 관찰 노력 편향이라고 해요.
EBP는 이걸 완전 목록(complete list)이라는 개념으로 풀어요. 이게 뭐냐면, 관찰자가 「그날 본 새를 전부 다 적었다」고 표시한 기록이에요. 이런 목록만 골라서 「그중 몇 퍼센트에 제비가 포함됐나」를 계산하면, 「제비를 몇 마리 봤나」가 아니라 「나가서 봤을 때 얼마나 자주 만났나」가 되거든요. 이 비율은 관찰자 수가 많든 적든 비교가 가능해서, 나라 간 편차를 훨씬 줄여줘요. 여기에 시공간 모델링을 더해서 관측이 비어 있는 격자를 주변 데이터로 추정하기도 하고요.
개발자 입장에서 교훈은 명확해요. 원본 데이터를 그대로 시각화하는 건 쉽지만, 그 데이터가 어떻게 수집됐는지를 이해하지 못하면 예쁜 거짓말 지도가 나온다는 거예요.
비슷한 프로젝트들과 비교하면
같은 영역의 대표 주자는 eBird예요. 수십억 건의 관찰 데이터를 기반으로 머신러닝 모델로 종별 분포와 추세를 추정하는 Status and Trends 제품을 내놓고 있죠. 방식이 EBP와 다른 건, eBird는 모든 데이터를 자기 플랫폼 하나로 모으는 중앙집중형이라는 점이에요. 반면 EBP는 이미 나라별로 성숙한 포털이 있는 유럽 상황에 맞춰 연합형을 택했어요. 어느 쪽이 낫다기보다는, 데이터 거버넌스 환경에 맞춰 아키텍처를 고른 거죠.
또 하나 참고할 만한 건 GBIF(세계생물다양성정보기구)예요. 여기는 Darwin Core라는 표준 스키마로 전 세계 생물 관찰 데이터를 받아요. 이기종 데이터를 통합할 때 「공통 스키마를 먼저 정의한다」는 접근의 교과서 같은 사례고, EBP도 결국 같은 문제를 유럽 조류라는 좁은 도메인에서 풀고 있는 셈이에요. 사진으로 종을 판별해주는 iNaturalist까지 넣으면, 시민과학 데이터 플랫폼이 수집, 판별, 집계, 모델링으로 각자 다른 층을 담당하는 그림이 보여요.
한국 개발자에게 주는 시사점
당장 써먹을 수 있는 건 세 가지예요. 첫째, 이기종 데이터 통합의 설계 패턴이에요. 공공데이터 API를 여러 개 엮어본 분이라면 스키마가 제각각인 고통을 알 텐데, EBP의 「집계 단위와 공통 포맷을 먼저 합의하고 원본은 각자 보관」 방식은 꽤 실용적인 참고가 돼요. 둘째, 시공간 데이터 시각화예요. 주 단위 격자 데이터를 애니메이션으로 돌리는 건 deck.gl이나 kepler.gl, MapLibre 같은 오픈소스로 충분히 재현할 수 있고, 포트폴리오 주제로도 좋아요. 셋째, 편향 보정이라는 사고방식이에요. 사용자 행동 로그든 센서 데이터든, 「이 데이터가 왜 여기 몰려 있지?」를 먼저 묻는 습관은 어느 도메인에서나 통해요.
응용 범위도 넓어요. 실제로 철새 이동 데이터는 조류 인플루엔자 방역에 활용되는데, 한국은 매년 겨울 이 문제를 겪는 나라잖아요. 국내에도 네이처링 같은 시민 관찰 플랫폼과 국립생물자원관의 데이터가 있으니, 이걸 엮는 파이프라인을 상상해 보는 것만으로도 좋은 사이드 프로젝트가 될 거예요.
정리
핵심 한 줄: 시민이 올린 관찰 기록도 공통 스키마, 연합형 수집, 편향 보정, 시공간 시각화를 거치면 대륙 규모의 실시간 인프라가 된다.
여러분은 한국에서 이런 연합형 시민과학 플랫폼이 가능하다고 보세요? 새가 아니라도 좋아요. 미세먼지 센서든 자전거 주행 기록이든, 「여러 곳에 흩어진 데이터를 하나의 살아 있는 지도로 만들면 재밌겠다」 싶은 게 있다면 댓글로 이야기 나눠봐요.
🔗 출처: Hacker News