딥러닝은 사실상 역전파(backpropagation) 하나 위에 세워진 분야다. 현대 신경망, 특히 트랜스포머 기반 언어 모델을 학습시킬 수 있는 신뢰할 만한 크레딧 할당 알고리즘은 지금까지 역전파뿐이었다. 역전파는 미분 가능성을 전제로 1차 그래디언트를 계산하며, 딥러닝의 아키텍처와 옵티마이저, 심지어 하드웨어까지 모두 이 제약에 맞춰 함께 진화해 왔다. qlabs가 공개한 'Dust'는 바로 이 전제를 흔든다. 역전파를 걷어내고, 해석적 구조 대신 훨씬 더 무차별적인(brute-force) 탐색에 기대어 트랜스포머를 사전학습시키려는 시도다.
이런 방향의 근거로 연구진은 서턴의 '쓴 교훈(bitter lesson)'과 알파고 제로를 든다. 인간 기보로 부트스트랩한 네트워크가 초반 학습은 빨랐지만, 충분한 연산이 주어지자 순수 자가대국 네트워크가 결국 이를 추월했다. 같은 논리로, 미분 가능성과 역전파는 연산이 부족한 환경에서 학습을 효율적으로 만드는 좋은 귀납 편향이지만, 연산이 풍부해질수록 오히려 작동 가능한 아키텍처의 공간을 제약하는 족쇄가 될 수 있다는 것이다. Dust는 연산량이 계속 늘어나는 세계를 전제로, 편향보다 탐색에 무게를 싣는 쪽에 베팅한다.
활성값을 흔들어 그래디언트를 추정한다
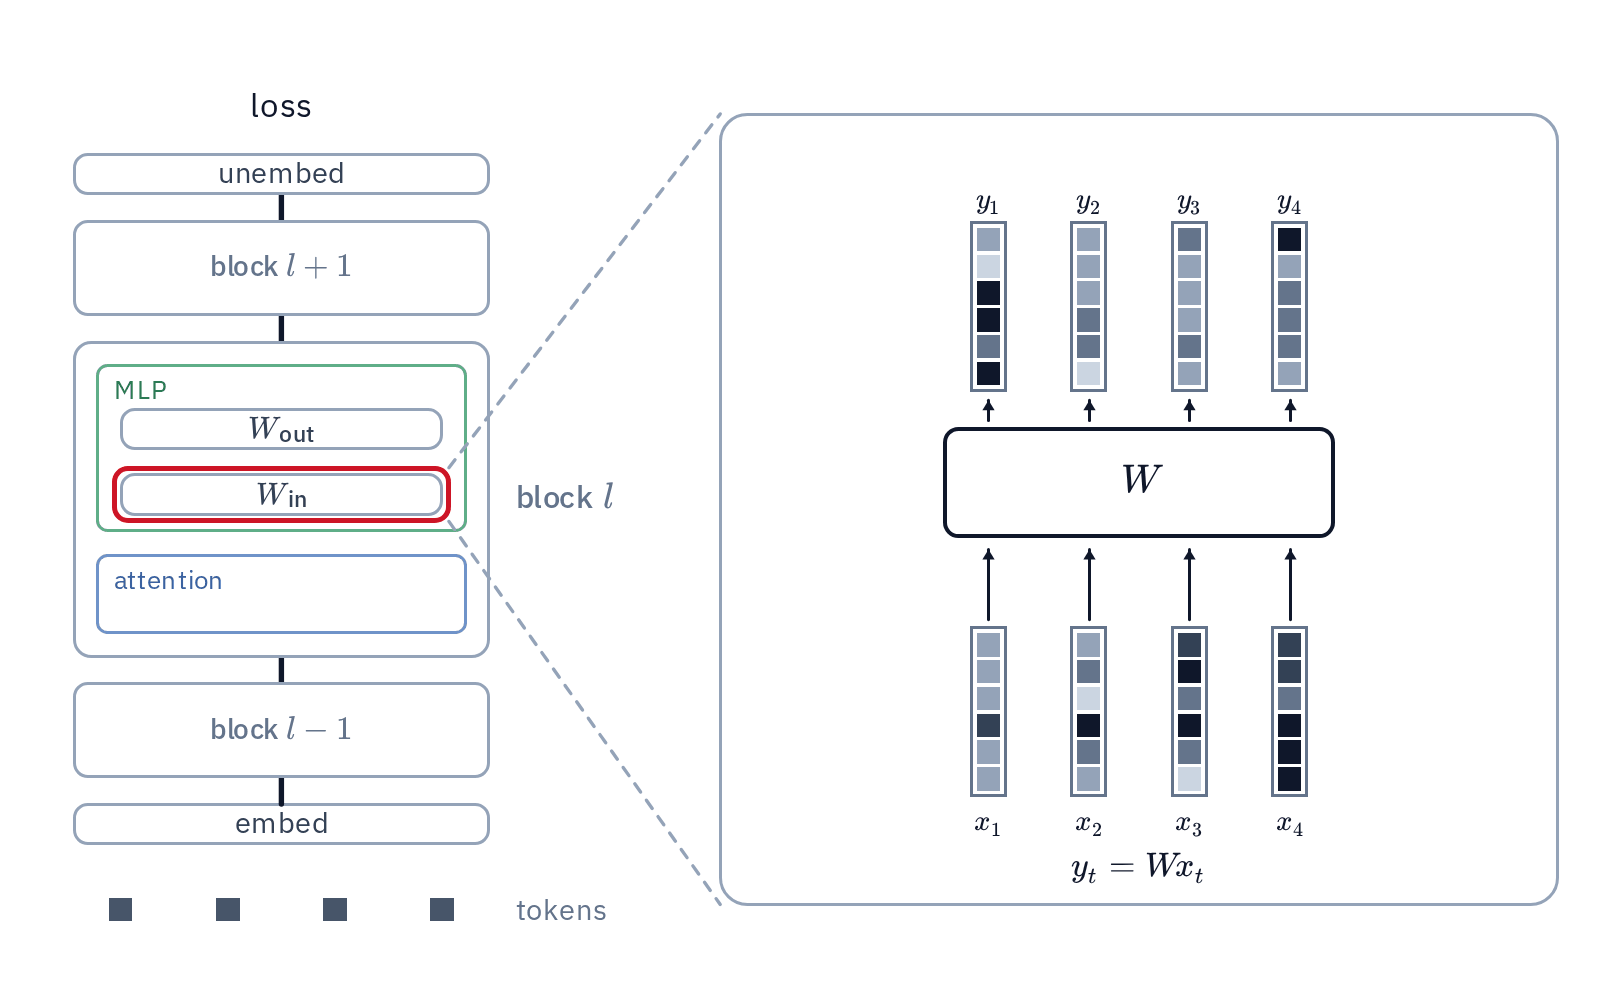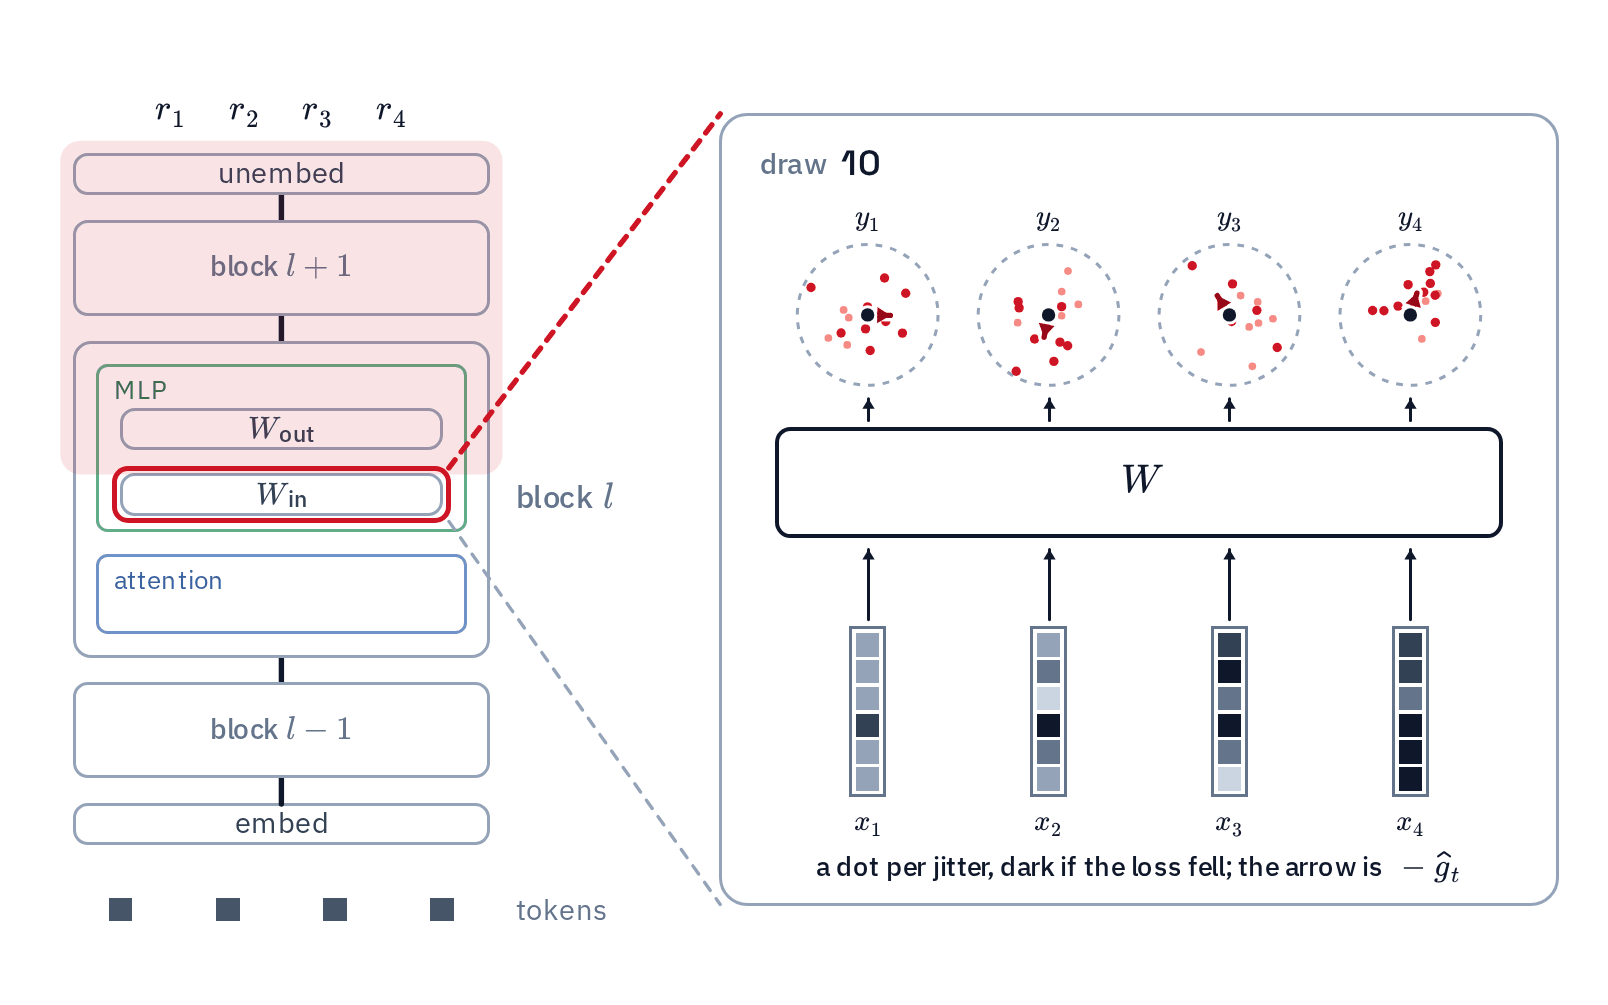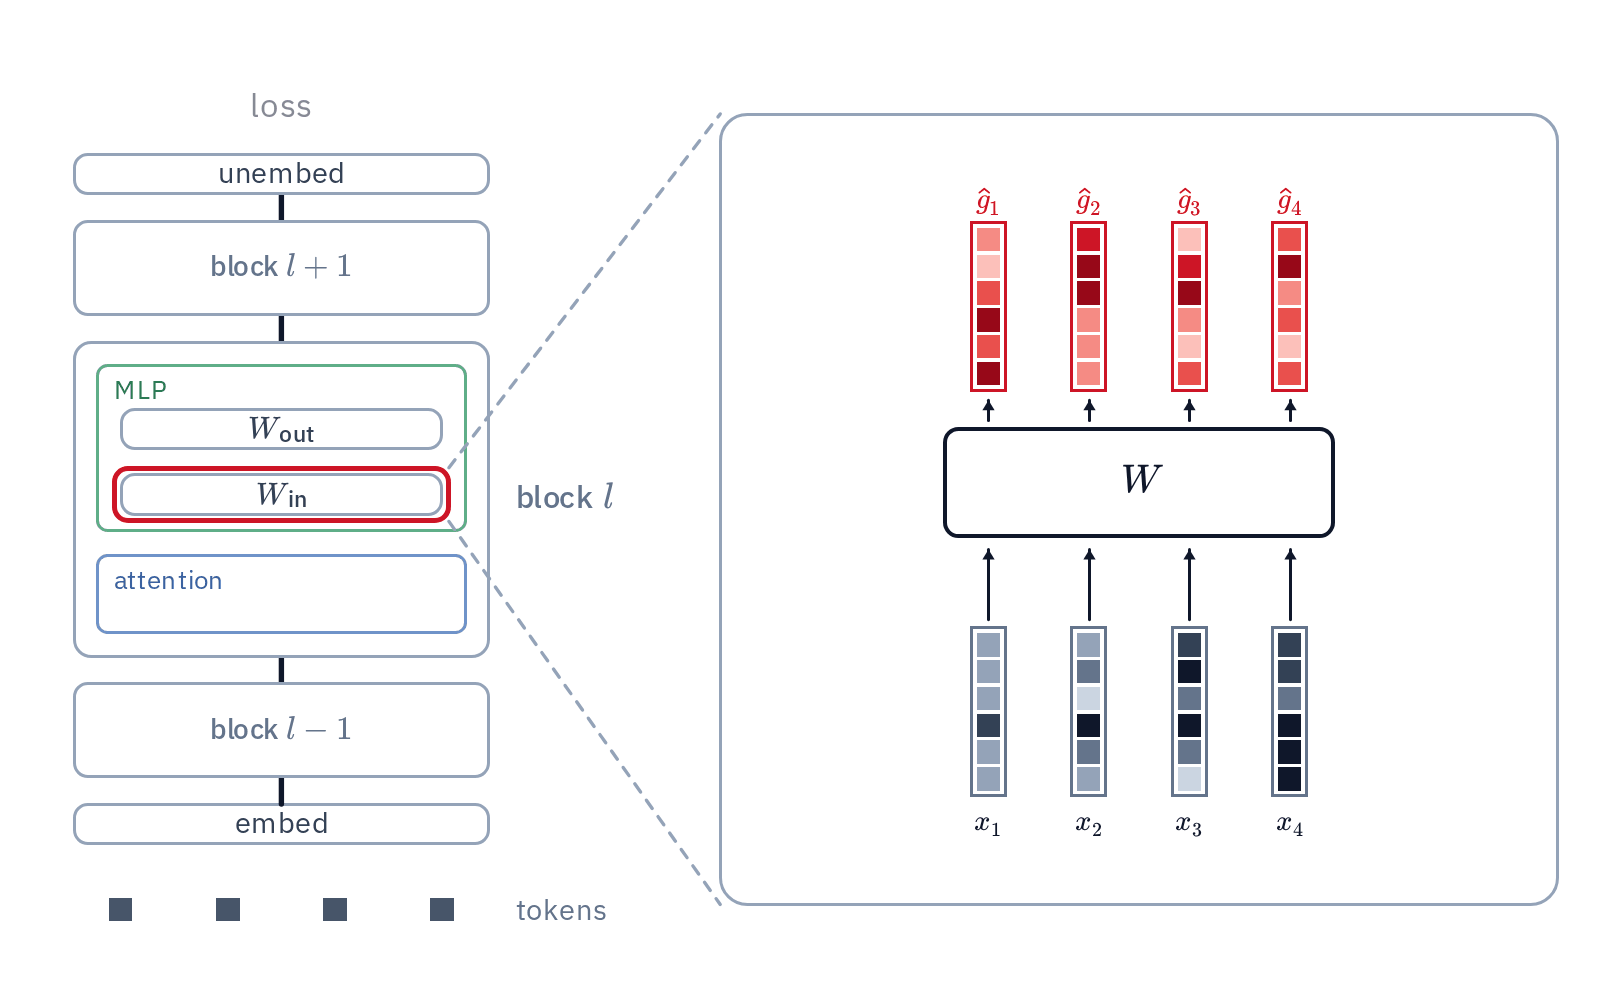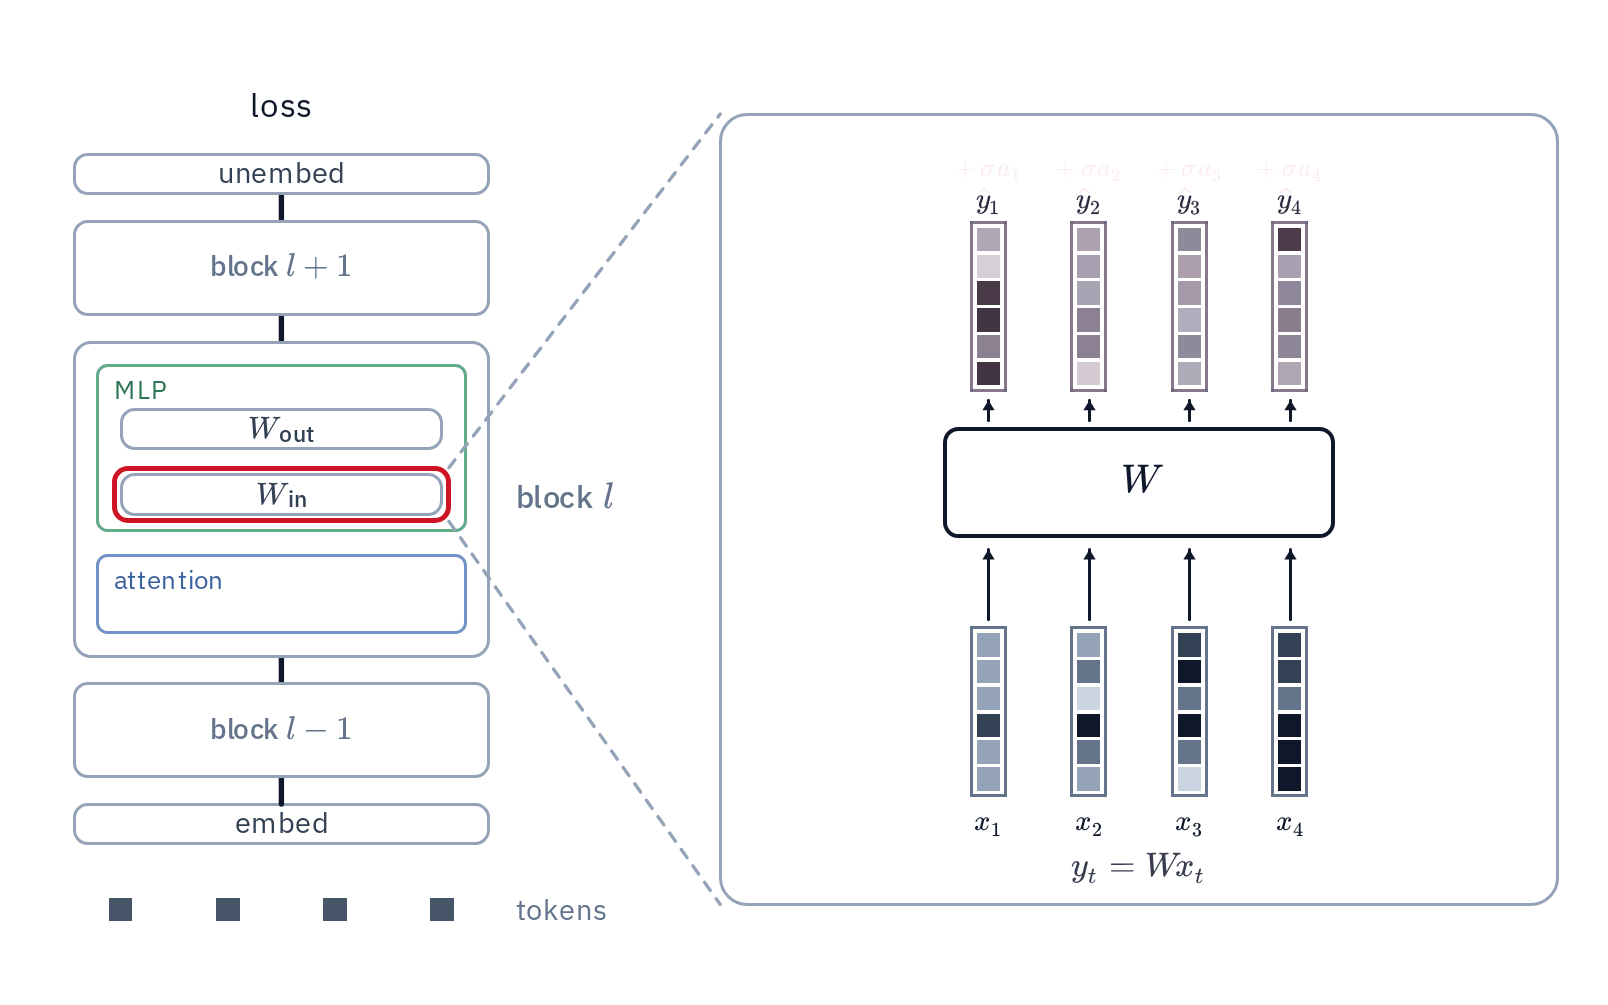
Dust는 0차(zeroth-order) 최적화 알고리즘이다. 가중치가 아니라 활성값(activation)에 가우시안 노이즈를 더하고, 각 교란이 손실을 얼마나 낮췄는지로 보상한 뒤, 집단(population) 전체에 걸쳐 보상 가중 노이즈를 평균 내어 그래디언트를 추정한다. 구체적으로는 각 선형 레이어의 출력에 토큰마다 독립적으로 노이즈를 더해 순전파를 한 번 돌리고, 그 토큰의 손실 변화로 노이즈를 보상한다. 이렇게 평균 낸 보상 가중 노이즈가 레이어 출력의 추정 오차가 되고, 이를 레이어 입력과 외적하면 가중치 그래디언트가 나온다. 흥미롭게도 역전파도 똑같은 입력과 외적을 만든다. 차이는 출력 오차를 연쇄법칙으로 얻느냐, 집단에서 얻느냐뿐이다. 어텐션 내부(쿼리·키·밸류 등)는 토큰 손실에 거의 잡히지 않아, 손실 대신 현재와 이후 토큰에 걸친 어텐션 출력의 추정 오차로 크레딧을 받는 변형을 쓴다.
가중치가 아닌 활성값을 택한 이유는 집단 크기 때문이다. 진화 전략(ES)의 병목은 언제나 집단 크기였다. 가중치를 교란하는 기존 ES는 구성원마다 교란된 가중치 사본과 별도 순전파가 필요하고, 저랭크 교란으로 사본 비용을 줄인 EGGROLL조차 각 구성원이 배치의 한 시퀀스에 묶여 집단 크기가 감당 가능한 순전파 수에 갇힌다. Dust는 가중치 공간을 아예 우회해 활성값을 토큰 단위로 교란하는 '가상 집단(virtual population)'으로 이 비용을 없앤다. 한 시퀀스에 토큰이 수천 개이므로 순전파 한 번이 시퀀스당 수천 명의 구성원을 평가하는 셈이고, 연구진은 이 방식이 가중치 공간 ES보다 최소 세 자릿수 더 큰 집단을 한 번의 순전파로 평가한다고 말한다. 활성값은 또한 기계적 해석가능성 연구가 '추론이 깃드는 공간'으로 지목한 곳이기도 해서, 학습을 잠재 추론에 대한 탐색으로 바꿀 여지를 남긴다. 다만 잔차 혼합 스칼라 $2L$개만은 예외적으로 평범한 가중치 공간 ES로 학습한다.
간섭을 줄이는 세 가지 장치
현실적으로 감당 가능한 집단 크기에서 가장 큰 비용은 간섭이다. 여러 레이어와 여러 토큰을 한 순전파 안에서 동시에 흔들면, 한 토큰의 노이즈를 보상해야 할 손실 변화에 다른 모든 교란의 효과가 섞여 든다. Dust는 이를 세 가지로 완화한다. 첫째, 레이어 유형별로 각자의 노이즈 스케일을 두고 서로 다른 순전파에서 흔든다. 이 순전파들은 깨끗한 순전파를 캐시해 두고 블록 $l$의 교란이 블록 $l$ 이후만 다시 돌리므로 전체 순전파보다 싸다. 둘째, 어텐션 내부는 따로 흔들어 어텐션 출력을 통해 보상한다. 셋째, 언어 모델 헤드는 캐시된 로짓 위에서 직접 흔들되 교차엔트로피와 어휘의 일부만 다시 계산해, 순전파의 극히 일부 비용으로 훨씬 큰 집단을 돌린다.
하이퍼파라미터, 즉 레이어 유형별 노이즈 스케일과 어텐션 내부의 크레딧 감쇠, 레이어별 집단 배분은 두 방식으로 조정한다. 하나는 각 설정을 작은 토큰 예산으로 실제 학습시켜 손실을 가장 많이 낮추는 쪽을 고르는 격자 탐색으로, 믿을 만하지만 비싸다. 다른 하나는 학습 없이 단일 배치에서 추정 그래디언트와 역전파 그래디언트의 코사인 유사도를 최대화하는 방식이다. 후자는 학습이 전혀 필요 없어 저렴하지만, 한 배치에서의 높은 코사인이 학습 후 손실 감소로 항상 이어지지는 않는다는 한계가 있다.
실무자 관점에서 분명히 해 둘 지점이 있다. 연구진 스스로 Dust가 오늘 당장 역전파를 대체할 만큼 연산 효율적이지 않다고 못 박는다. 목표는 가장 어려운 과제로 꼽은 트랜스포머 사전학습에서 역전파와 경쟁 가능한 탐색 기반 크레딧 할당의 토대를 세우는 것이지, 효율 경쟁이 아니다. 외부 프로그램을 루프에 끼운 신경망이나 시간축 역전파가 다루기 힘든, 여러 단계로 반복되는 트랜스포머처럼 이 방법이 새로 열어 줄 수 있는 모델들의 실제 학습도 후속 연구로 미뤄 두었다. 그래서 Dust는 당장 쓸 도구라기보다, 미분 가능성이라는 전제가 풀렸을 때 학습 알고리즘의 설계 공간이 어떻게 넓어지는지를 보여 주는 실험으로 읽는 편이 정확하다. 연산이 싸질수록 탐색이 구조를 이긴다는 가설에 관심 있는 이들이라면 눈여겨볼 만한 참조점이다.