생성형 AI가 이미지와 영상, 음성을 만들어내는 동안, 금융 시장 데이터를 '합성'하려는 시도는 상대적으로 드물었다. 퀀트 분야의 모델은 보통 호가 추가, 취소, 체결 같은 시장 이벤트의 흐름을 입력받아 특정 종목의 미래 가격을 점추정하는 데 집중한다. 제인스트리트의 2026년 여름 인턴 프로젝트에서 연구 인턴 Kavish는 여기서 한 걸음 더 나아갔다. 단순한 가격 예측이 아니라, 호가창 이벤트 자체를—심지어 그 이벤트가 거래소에 도착하는 시점까지 포함해—생성하는 모델을 자기회귀 확산(autoregressive diffusion) 방식으로 만들어보려 한 것이다. 이런 모델이 작동한다면 가격 예측은 물론이고, 훨씬 풍부한 질감의 시뮬레이션 롤아웃을 얻을 수 있다.
시장 데이터는 어떤 종류의 데이터인가
생성 모델을 설계하려면 먼저 데이터의 성격을 규정해야 한다. 시장 데이터는 영상처럼 연속적인가, 텍스트처럼 이산적인가? 둘 다의 성질을 지닌다는 점이 문제의 핵심이다. 호가창은 참여자들이 호가를 넣고 빼는 이산적인 행동의 연속으로 진화하지만, 가격처럼 카디널리티가 매우 높아 사실상 연속처럼 보이는 변수도 있다. 주문 도착 시각처럼 본질적으로 연속인 변수도 있다. 게다가 실제 분포는 뾰족하다. 한 틱만 가격을 개선하는 '페니잉'이 두 틱 개선보다 훨씬 흔하고, 주문은 정수 초 단위 같은 특정 시점 주변에 몰려서 도착한다.
Kavish는 미국 주식 4년치 데이터를 사용했다. 각 행에는 타임스탬프, 가격, 이벤트 종류(체결, 주문, 취소 등) 같은 정보가 담긴다. 모델은 다음 이벤트의 특징을 생성한 뒤 이를 스트림에 자기회귀적으로 덧붙인다. 구조는 Li 등의 논문을 따른 인코더–디퓨저 방식이다. 인과적 마스킹을 적용한 트랜스포머 인코더가 각 위치의 잠재 임베딩을 만들고, 작은 이벤트 종류 헤드가 다음 이벤트가 체결인지 최우선호가(BBO) 갱신인지를 2범주 확률로 출력한다. 가격이나 경과 시간 같은 연속 목표값은 해당 잠재값과 실제 이벤트 종류에 AdaLN 방식으로 조건화된 확산 헤드가 생성한다.
DDPM이 아니라 플로우 매칭
기술적으로 의미 있는 발견 하나는 확산 모델의 정석으로 여겨지는 DDPM이 오히려 발산했다는 점이다. DDPM은 샘플에 더해진 노이즈를 예측하는데, 노이즈 수준이 높을 때는 예측의 작은 오차가 깨끗한 추정값의 큰 오차로 증폭된다. Improved DDPM이 권장하는 1,000스텝 코사인 스케줄에 DDIM 추론을 결합한 초기 구성은 불안정했고, 7개 연속 목표값 모두에서 값의 88~95%가 평균에서 표준편차 8배 이상 벗어나는 폭주가 일어났다. 샘플링 스텝을 늘리거나 확률성을 더해 가우시안으로 정규화하면 완화되지만, Kavish는 노이즈와 데이터 사이를 선형 보간해 속도를 예측하는 플로우 매칭(정류 플로우)이 별도 조정 없이도 잘 작동한다는 것을 확인하고 그쪽으로 전환했다. 궤적이 거의 직선이라 적은 스텝으로도 정확히 적분되기 때문이다.
프로젝트의 대부분은 더 근본적인 문제와 씨름하는 데 쓰였다. 영상은 한 프레임의 스냅샷도 연속이고 프레임 간 변화도 연속이라 확산 모델에 잘 맞는다. 반면 시장 데이터는 스냅샷은 연속이지만 그 진화는 시장 미시구조에 지배되어 매우 이산적이다. 주문 시각은 정규분포가 아니라 0초, 반응 가능한 최단 시간, 정수 초 주변에 점질량이 몰린 덩어리 형태이고, 가격도 호가 중간값이나 현재 매수·매도호가 근처에 뭉쳐 날카로운 불연속을 만든다.
이산성을 어디까지 집어넣을 것인가
범주 예측에도 불균형이 있었다. 전체 이벤트의 8%만 체결이고 나머지는 BBO 변동이라, 범주 헤드가 체결을 과대 예측했다. Kavish는 BBO 변동을 '크기만 변함', '매도호가 상승', '매수호가 하락' 같은 흔한 클래스로 쪼갰다. 이렇게 하면 경과 시간 0처럼 특정 특징의 뾰족한 불연속(원자)을 별도 클래스로 빼낼 수 있다는 부수적 이점도 있었다. 결과적으로 20개 클래스의 범주 헤드와 더 단순해진 확산 목표값—예컨대 '0이 아닌 시간 간격의 크기'나 '매수호가 변동의 크기'(방향은 범주가 담당)—을 얻었다. 주변 분포는 뚜렷이 개선됐지만, 모든 특징의 모든 불연속을 수작업으로 범주화하는 방식은 거래소 식별자 같은 고카디널리티 변수가 많은 실제 데이터에서는 클래스 수가 폭발해 확장되기 어렵다.
그래서 Kavish는 '원자 평활화(atom smoothing)'라는 대안을 고안했다. 뾰족한 실제 분포를 일단 매끄럽게 편 뒤, 불연속을 만들지 않으면서 그 지점의 확률 질량을 다시 살려내는 방식이다. 이때 변수의 표현 방식 선택이 중요하다. 어떤 표현에서는 날카로운 스파이크가 다른 표현에서는 완만해지기 때문에, 평활화할 스파이크를 제대로 드러내는 표현을 골라야 한다. 플로우 매칭과 원자 평활화를 결합한 모델은 꽤 잘 작동했다. 10,240개의 실제 맥락 이벤트를 조건으로 다음 한 이벤트를 뽑아 실제 발생 이벤트와 비교하는 1스텝 설정에서, 목표값별 주변 분포와의 차이를 총변동(TV) 발산으로 측정했다. 주변 분포 정렬만으로는 특징 간 결합 관계나 이전 맥락과의 시간적 일관성을 잡지 못하므로, 모델 생성값과 실제 이벤트를 구별하는 분류기도 따로 학습시켰고, 평활화에 최적화된 표현이 훨씬 사실적인 샘플을 만들어냈다.
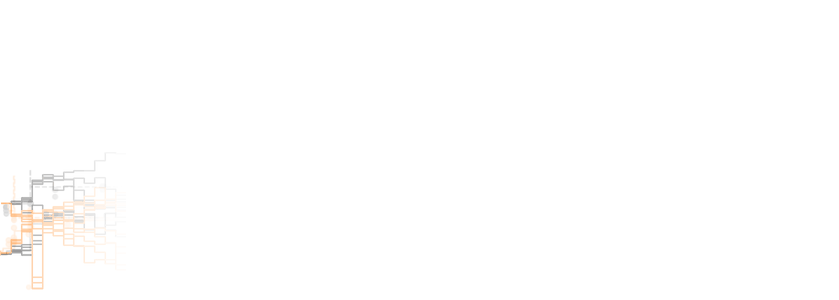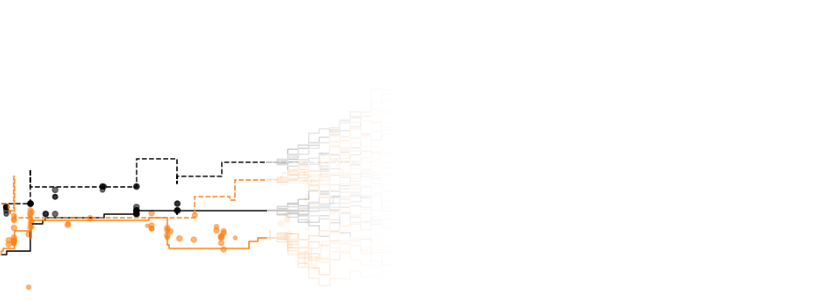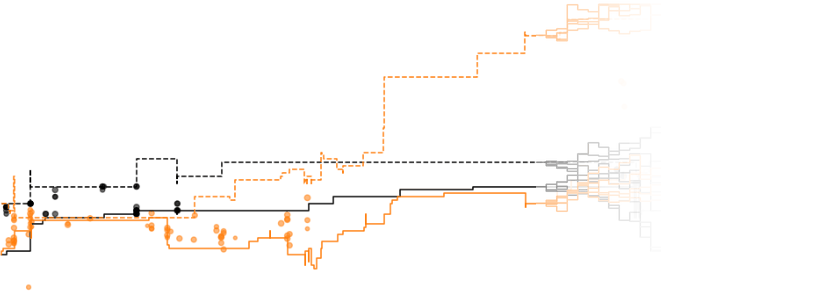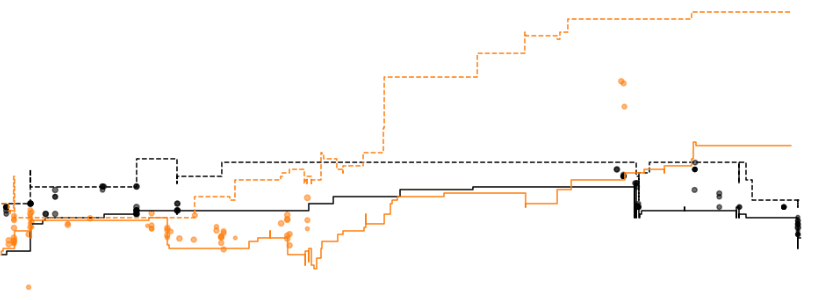
최종 목표인 자기회귀 롤아웃에서는 예측이 미래로 갈수록 자연스럽게 열화됐는데, 합성 롤아웃에서 CME US의 스프레드가 점점 벌어지는 모습이 관찰됐다. 얼마나 빨리 열화되는가는 후속 연구 과제로 남았다. Kavish의 모델은 아직 실전 생성기로 쓸 만큼 정확하지는 않다. 다만 이 프로젝트는 어떤 손잡이가 중요한지를 분명히 했다. 무엇을 범주로 예측하고 무엇을 확산으로 생성할지, 즉 이산성을 얼마나 집어넣을지, 그리고 특징 분포를 어떻게 표현하고 평활화할지가 관건이다. 호가창 이벤트를 '매도 잔량 10% 증가'라는 연속 공간과 '매수호가에 페니잉'이라는 이산 행동 공간에 동시에 존재하는 대상으로 보는 관점—이 혼합을 제대로 모델링하는 것이 시장 데이터 생성의 출발점이라는 통찰이 이번 실험의 실질적 수확이다.