무슨 일이 있었나요?
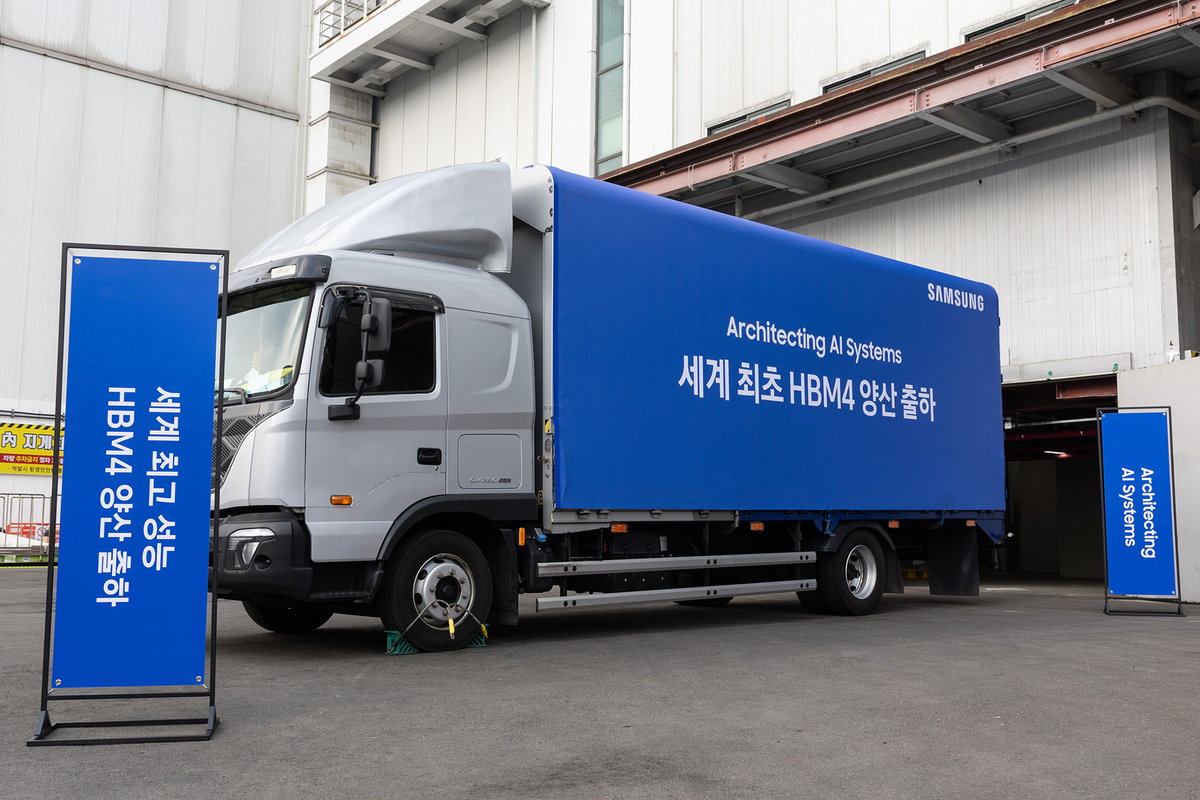
서울경제 영문판 보도에 따르면, 삼성전자가 내년 HBM4와 HBM4E 생산량을 올해보다 2배 이상 늘릴 계획이라고 해요. 업계 관계자를 인용한 기사라서 삼성이 공식 발표한 건 아니지만, 메모리 업계에서는 꽤 무게 있게 받아들이는 분위기예요.
여기서 HBM이 뭐냐면, High Bandwidth Memory의 약자로 '고대역폭 메모리'라고 불러요. 보통 우리가 쓰는 PC의 DRAM은 메인보드에 옆으로 길게 꽂혀 있잖아요? HBM은 DRAM 칩을 아파트처럼 여러 층으로 쌓아 올리고, 층 사이를 TSV(실리콘 관통 전극)라는 아주 작은 구멍으로 수직 연결한 메모리예요. 그리고 이걸 GPU 바로 옆에 붙여서 데이터를 엄청나게 넓은 통로로 주고받아요. 비유하자면 일반 DRAM이 2차선 도로라면 HBM은 수백 차선짜리 고속도로인 셈이죠.
왜 이게 AI 시대에 중요하냐면, 요즘 LLM은 파라미터가 수천억 개라서 GPU 연산이 아무리 빨라도 메모리에서 데이터를 가져오는 속도가 병목이 되거든요. 이걸 '메모리 월(memory wall)'이라고 부르는데, HBM이 바로 이 벽을 낮추는 핵심 부품이에요. 엔비디아 H100, B200, 그리고 차세대 루빈(Rubin) 같은 AI 가속기는 전부 HBM 없이는 돌아가지 않아요.
HBM4는 뭐가 달라졌나요?
HBM4는 HBM3E의 다음 세대 규격이에요. 가장 큰 변화는 인터페이스 폭이 1024비트에서 2048비트로 두 배가 됐다는 거예요. 도로 차선이 두 배로 늘어난 거니까 같은 클럭에서도 대역폭이 크게 뛰죠. 스택당 대역폭이 2TB/s 안팎까지 올라가고, 최대 16단(16-Hi)까지 쌓아서 스택 하나에 48GB 이상을 담을 수 있어요.
또 하나 큰 변화는 맨 아래 깔리는 '베이스 다이'예요. HBM3E까지는 베이스 다이도 메모리 공정으로 만들었는데, HBM4부터는 파운드리 로직 공정으로 만들어요. 쉽게 말하면 메모리 스택의 1층을 '똑똑한 컨트롤러'로 바꾼 거예요. 여기에 고객 맞춤 기능을 넣을 수도 있어서 '커스텀 HBM'이라는 말이 나오는 배경이기도 하죠. 삼성은 메모리와 파운드리를 둘 다 가지고 있어서 이 부분에서 유리하다고 스스로 강조해 왔어요.
HBM4E는 HBM4의 개선판(Extended)이에요. HBM3 다음에 HBM3E가 나왔던 것처럼, 같은 규격 위에서 속도와 용량을 더 끌어올린 버전이라고 이해하면 돼요. 내년에 HBM4가 본격 양산되고 HBM4E가 뒤따라오는 흐름이 될 거예요.
왜 '2배 이상'이라는 숫자가 의미 있을까요?
삼성이 HBM에서 마음이 급한 이유가 있어요. HBM3E 세대에서 SK하이닉스가 엔비디아 공급을 사실상 독점하다시피 했고, 삼성은 엔비디아 품질 인증(퀄 테스트)에서 오랫동안 고전했거든요. 한때 메모리 1위였던 삼성이 AI 메모리에서는 3위 마이크론에게도 쫓기는 상황이 됐죠.
그래서 삼성은 HBM4를 '설욕전'으로 잡고 있어요. HBM4에서는 1c 나노 DRAM(6세대 10나노급)과 자체 4나노 파운드리 베이스 다이를 조합해서 초기부터 승부를 걸겠다는 전략이었고, 올해 들어 주요 고객사 인증과 공급 관련 소식이 이어졌어요. 이번 증산 보도는 그 인증이 실제 대량 주문으로 이어지고 있다는 신호로 읽을 수 있어요. 메모리 회사가 생산량을 두 배로 늘린다는 건 이미 고객과 물량 약속이 어느 정도 잡혀 있다는 뜻이거든요. HBM은 범용 DRAM처럼 만들어놓고 파는 제품이 아니라, 고객 주문에 맞춰 만드는 주문 생산 제품에 가까워요.
업계 맥락: 3파전이 진짜 시작됩니다
HBM 시장은 사실상 SK하이닉스, 삼성전자, 마이크론 세 회사의 게임이에요. SK하이닉스는 HBM3E 성공을 발판으로 HBM4에서도 선두를 지키려 하고, 마이크론은 미국 회사라는 지정학적 이점과 전력 효율을 내세우고 있어요. 여기에 삼성이 물량으로 치고 들어오면 세 회사가 진짜 정면으로 붙는 첫 세대가 HBM4가 될 가능성이 커요.
수요 쪽을 보면 엔비디아뿐 아니라 AMD의 MI400 계열, 구글 TPU, 아마존 트레이니움, 그리고 브로드컴이나 마벨과 함께 만드는 각종 커스텀 ASIC까지 전부 HBM4를 기다리고 있어요. 공급이 늘어난다고 가격이 확 떨어지진 않을 거예요. 오히려 지금은 '얼마나 많이 확보하느냐'가 AI 인프라 경쟁의 핵심이라서, 증산 뉴스는 곧 'AI 칩이 더 많이 나온다'는 뜻으로 받아들이면 돼요.
한국 개발자에게 주는 시사점
'메모리 회사 증산이 나랑 무슨 상관이지?' 싶을 수 있는데, 생각보다 가까운 이야기예요.
첫째, GPU 구하기 전쟁이 조금은 나아질 수 있어요. 클라우드에서 H100이나 B200 인스턴스 잡기 힘들었던 기억 있으시죠? HBM 공급이 AI 가속기 생산량을 직접 제약해왔기 때문에, HBM이 풀리면 GPU 인스턴스 가격과 가용성에도 영향을 줘요.
둘째, 메모리 대역폭이 곧 추론 성능이라는 점을 이해하면 모델 최적화 감이 좋아져요. LLM 추론은 대부분 '메모리 바운드'예요. 그래서 KV 캐시 양자화, 페이지드 어텐션, 스펙큘레이티브 디코딩 같은 기법들이 전부 메모리 트래픽을 줄이는 방향으로 발전하고 있죠. HBM4로 대역폭이 두 배가 되면 같은 GPU에서 뽑을 수 있는 초당 토큰 수가 크게 달라져요.
셋째, 반도체 도메인의 소프트웨어 수요가 계속 늘어요. HBM 같은 첨단 패키징은 수율 관리, 테스트 데이터 분석, 열 시뮬레이션 등 소프트웨어가 많이 필요한 영역이에요. 국내에 삼성과 SK하이닉스라는 두 거인이 있다는 건 이 도메인의 개발자 수요가 계속 있다는 얘기이기도 해요.
마무리
한 줄로 정리하면, '삼성이 HBM4에서 물량으로 반격에 나섰고, 이건 AI 가속기 공급 전체에 영향을 주는 뉴스'예요.
여러분은 어떻게 보세요? HBM 공급이 늘어나면 GPU 가격이 실제로 내려갈까요, 아니면 수요가 더 빨리 늘어서 체감이 안 될까요? 그리고 메모리 대역폭 병목 때문에 고생해 본 경험이 있다면 어떤 최적화가 효과 있었는지도 나눠주세요.
🔗 출처: Hacker News