웹사이트가 사람과 자동화 프로그램을 구분하기 위해 쓰는 봇 탐지 시스템은 그동안 스크립트로 조작되는 브라우저를 막는 데 초점이 맞춰져 있었다. 그러나 웹페이지를 스스로 해석하고 행동을 계획하며 인터페이스를 조작하는 AI 브라우징 에이전트가 등장하면서, 기존 탐지 방식이 과연 유효한지에 대한 의문이 커지고 있다. Proof of Human의 연구진은 1년 전 수행했던 봇 탐지 벤치마크를 다시 진행해, 상대 격차가 얼마나 벌어졌는지를 수치로 보여주었다.
1년 전과 달라진 실험 설계
이전 실험에서는 Proof of Human, 구글 reCAPTCHA v3, hCaptcha, Fingerprint Pro, Cloudflare Turnstile 다섯 개 시스템을 미리 정해진 작업을 수행하도록 프로그래밍된 자동 브라우저에 맞세웠다. 당시 탐지율은 33%에서 87%까지 넓게 분포했고, 기기 수준의 신호만 쓰는 시스템보다 행동 신호를 함께 활용하는 쪽이 대체로 나은 성적을 보였다.
이번에는 공격 측 구성을 넓혔다. 전통적인 스크립트 브라우저에 더해, 자동화 흔적을 숨기도록 설계된 스텔스 브라우저, 그리고 페이지를 탐색하며 작업을 자율적으로 끝내는 AI 에이전트까지 포함했다. 탐지 시스템은 Proof of Human, reCAPTCHA v3, hCaptcha, Cloudflare Turnstile, 그리고 새로 Cloudflare Bot Management가 들어갔다. 과제는 객관식과 주관식이 섞인 다섯 문항짜리 설문이었고, 다섯 종류의 공격자가 각각 20번씩 시도해 시스템당 최대 100개의 세션을 만들었다. 일부 시스템은 세션이 끝나기 전에 실패하거나 멈춰, 실제 평가 가능한 세션은 시스템별로 89~100개였다.
같은 공격, 전혀 다른 성적표
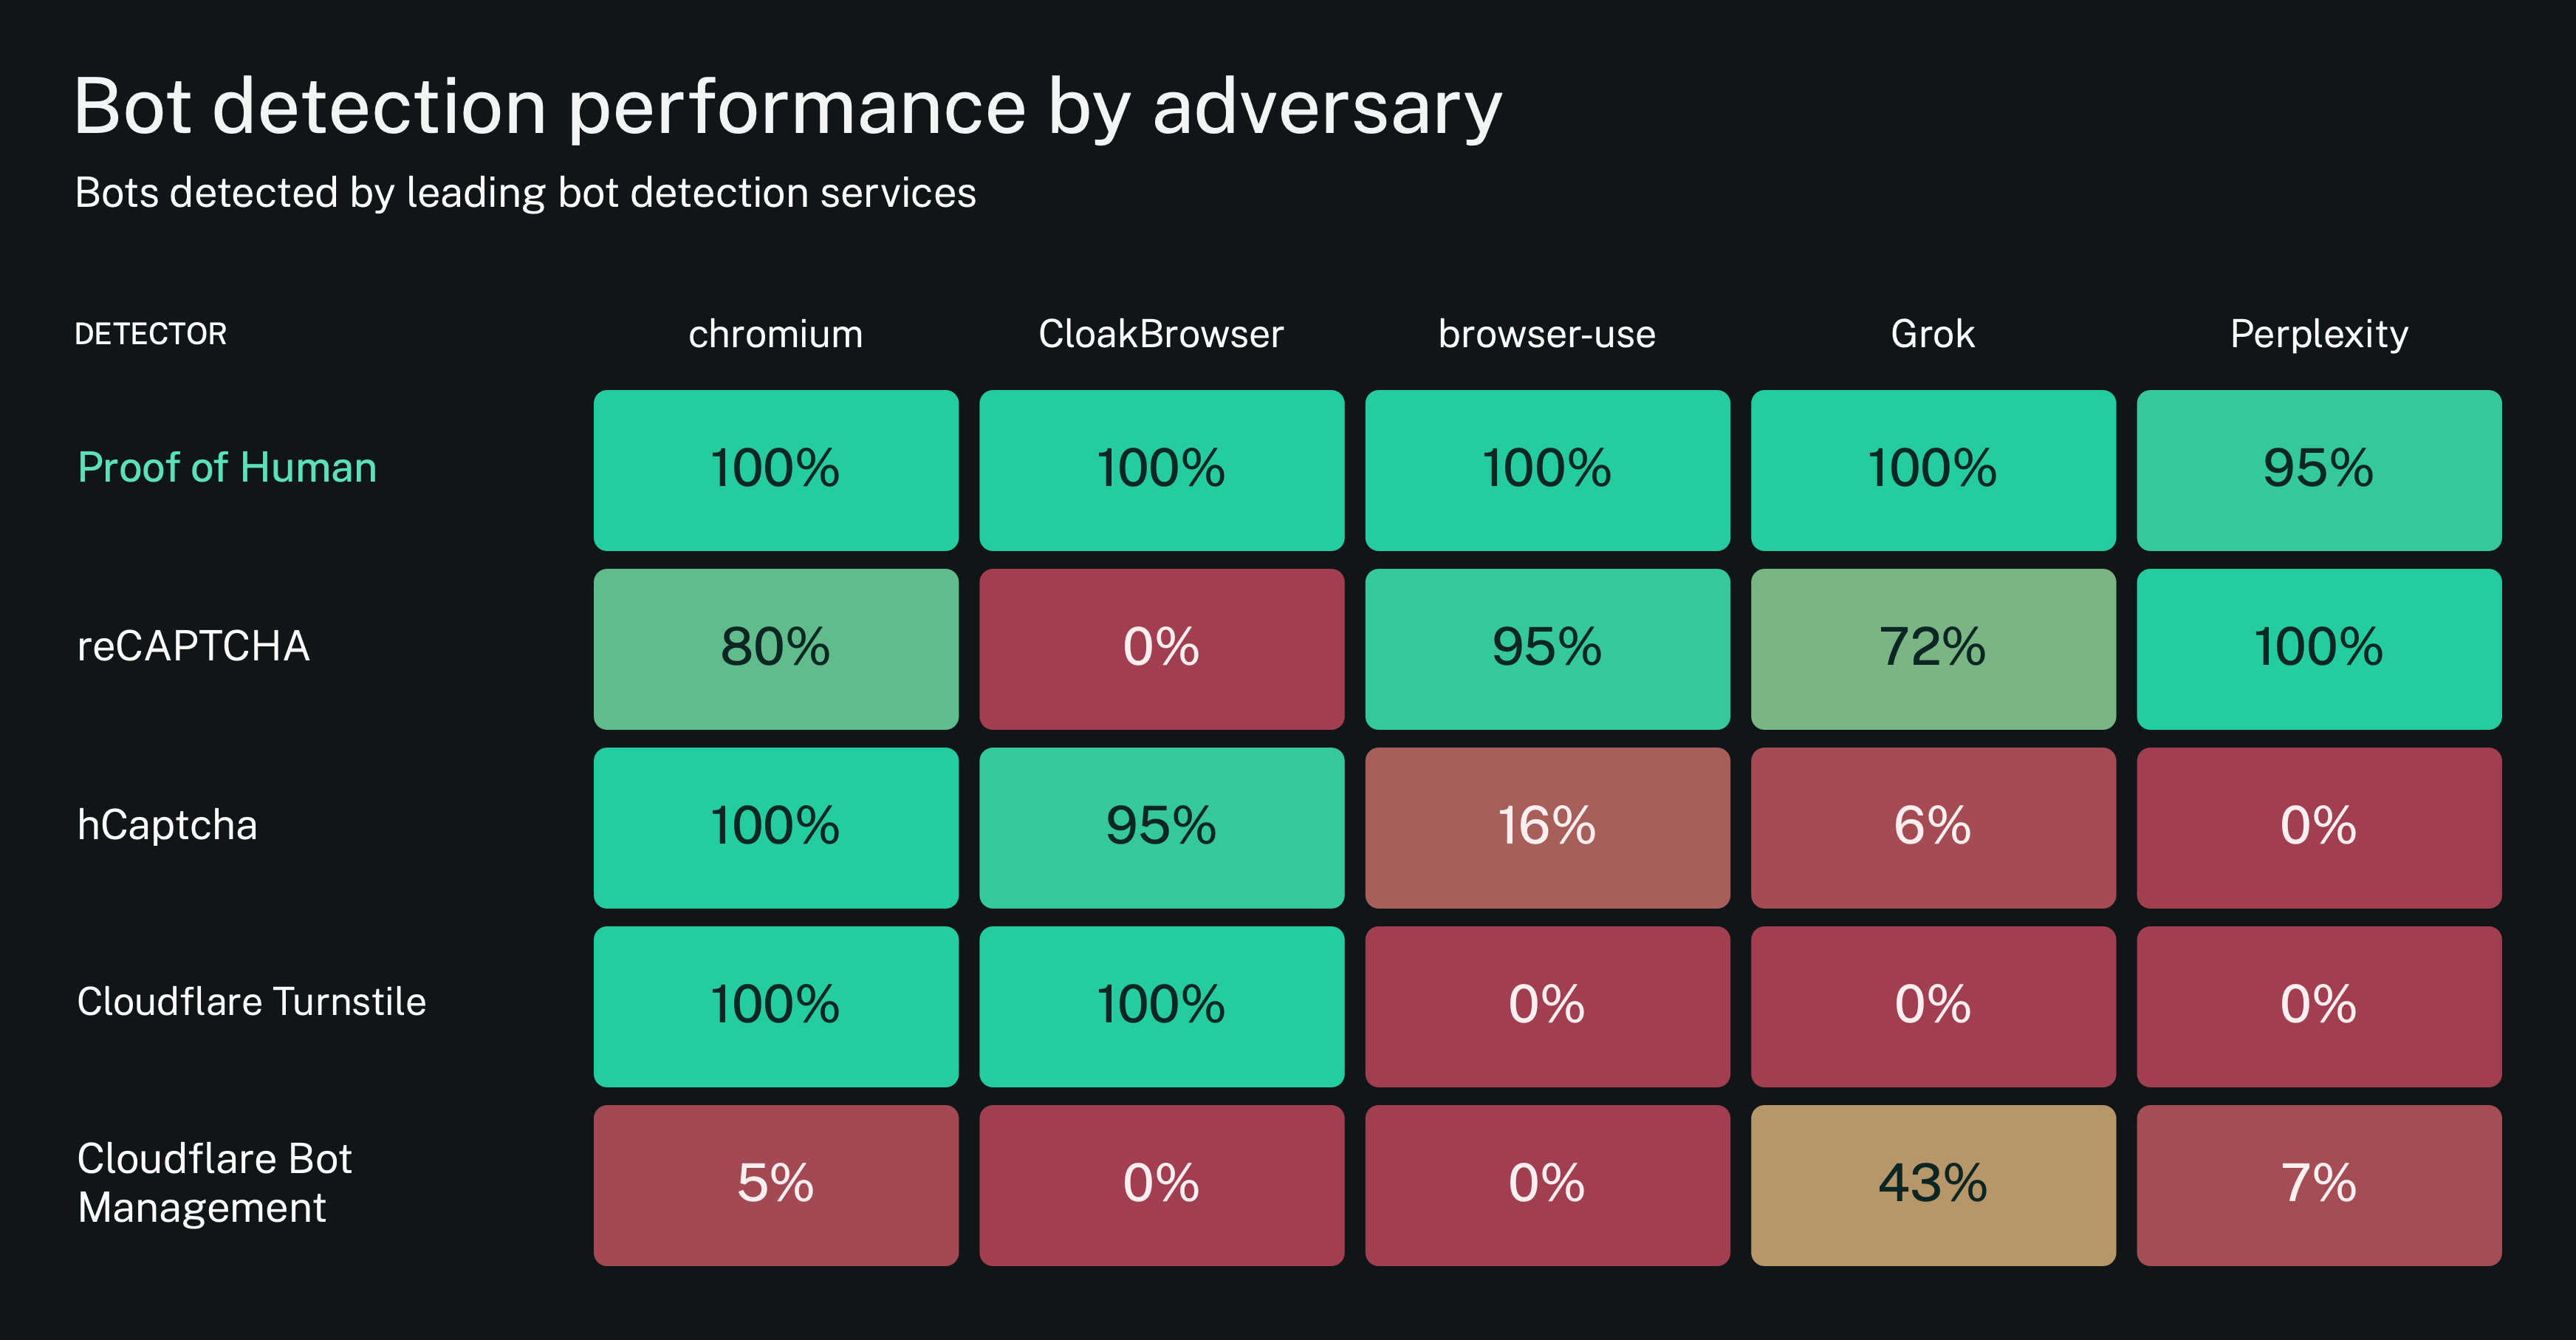
전체 공격자를 종합한 탐지율은 극단적으로 갈렸다. Proof of Human이 99%로 가장 높았고, reCAPTCHA v3가 69.4%, hCaptcha 44.3%, Cloudflare Turnstile 42.1%로 뒤를 이었으며, Cloudflare Bot Management는 9.1%에 그쳤다. 흥미로운 것은 종합 수치보다 공격자별 패턴이다. 가장 뚜렷한 경계선은 스크립트 브라우저와 AI 에이전트 사이에 그어졌다.
hCaptcha와 Cloudflare Turnstile은 스크립트로 조작된 Chromium과 스텔스 브라우저(CloakBrowser) 세션은 거의 전부 잡아냈지만, AI 에이전트 세션은 대부분 놓쳤다. reCAPTCHA v3는 정반대였다. 에이전트 세션은 대체로 식별했으나 CloakBrowser는 단 하나도 걸러내지 못했다. Cloudflare Bot Management는 어떤 공격자에 대해서도 거의 탐지하지 못했고, Proof of Human만 전반적으로 95% 이상을 잡아냈다. 즉 하나의 탐지 시스템이 특정 유형에만 강하고 다른 유형에는 거의 무력한, 비대칭적인 방어 구조가 드러난 것이다.
실무자가 읽어야 할 함의
이 결과가 시사하는 바는 명확하다. 자동화의 전형적 흔적을 포착하는 기존 신호는 스크립트 브라우저에는 여전히 유효하지만, 실제 브라우저 환경을 지능적으로 다루는 AI 에이전트 앞에서는 신뢰도가 떨어진다. 특히 시각 정보를 해석할 수 있는 에이전트에게는 사용자에게 상호작용을 요구하는 챌린지형 방어가 제한적인 보호막밖에 되지 못한다. 캡차 이미지를 사람처럼 읽고 풀어버리기 때문이다. 브라우저 수준의 지표가 점점 쉽게 회피되면서, 세션 전반에 걸친 사용자의 행동 방식이 사람과 자동화를 가르는 더 중요한 단서로 떠오르고 있다.
따라서 한 가지 탐지 솔루션에 전적으로 의존하는 설계는 위험하다. reCAPTCHA가 에이전트를 걸러도 스텔스 브라우저를 통과시키고, hCaptcha는 그 반대인 상황에서, 서로 보완되는 신호를 다층으로 결합하거나 행동 기반 분석을 더하는 접근이 현실적이다. 결제·가입·설문처럼 자동화 악용에 취약한 지점이라면 자사 트래픽에 어떤 공격 유형이 실제로 유입되는지부터 점검할 필요가 있다.
다만 해석에는 신중함이 요구된다. 대부분의 탐지 시스템이 내부 로직을 공개하지 않는 블랙박스여서, 각 결과가 정확히 어떤 신호 때문에 나왔는지 단정하기 어렵다. 벤치마크 자체도 한계를 안고 있다. 트래픽 규모가 작고, 사람 참가자를 포함하지 않아 정상 사용자를 봇으로 오인하는 거짓 양성률은 측정되지 않았다. 탐지율이 높다는 것이 곧 서비스에 적합하다는 뜻은 아니며, 실제 환경에서는 과도한 차단이 사용자 이탈로 이어질 수 있다. 무엇보다 이 실험을 수행하고 가장 높은 점수를 받은 Proof of Human이 바로 벤치마크를 설계한 회사라는 점은 결과를 참고할 때 감안해야 할 대목이다. 연구진은 향후 더 큰 규모의 트래픽, 사람 참가자를 통한 거짓 양성 측정, 더 복잡한 과제와 새로운 에이전트를 포함한 후속 실험이 필요하다고 밝혔는데, 이는 현재 결과가 방향성을 보여줄 뿐 결론은 아니라는 점을 스스로 인정한 것이기도 하다.