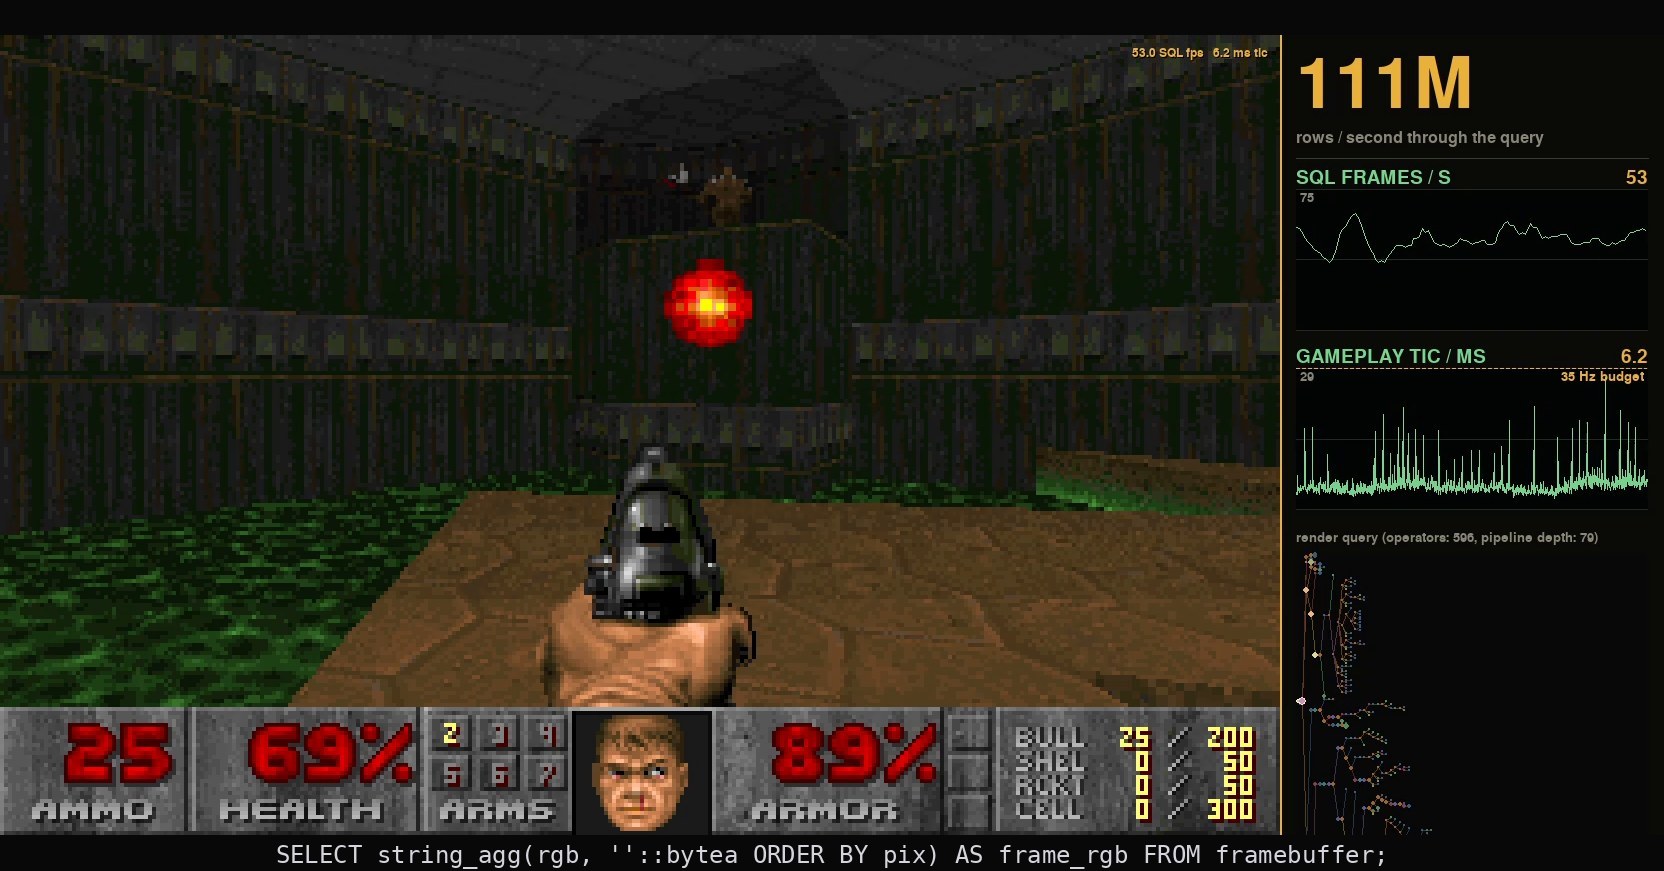
게임 엔진과 데이터베이스는 보통 정반대의 세계로 여겨진다. 전자는 매 프레임 상태를 바꾸는 절차적 루프의 집합이고, 후자는 집합(set) 단위로 데이터를 다루는 선언형 시스템이다. 그런데 CedarDB 팀은 1993년 원작 둠(Doom)의 게임 로직과 렌더러를 통째로 SQL로 옮겨 데이터베이스 안에서 구동하는 실험을 공개했다. 게임 루프는 원작과 동일한 35 FPS로 돌고, 렌더러는 320x200 해상도의 완전한 프레임 버퍼를 노트북에서 최대 60Hz까지 만들어 낸다. 파이썬은 타이밍 제어, 키보드 입력 읽기, 돌려받은 비트맵 표시만 담당한다. 데스매치 멀티플레이어(4인)까지 동작하며, 셰어웨어 1화 에피소드 기준으로 실제 플레이가 가능하다.
이 프로젝트는 지난해 공개됐던 DOOMQL의 후속작 성격이다. 당시 버전은 30 FPS로 둠 비슷한 아스키 아트를 그려 호응을 얻었지만, 레이캐스팅 방식이라 사실상 울펜슈타인 3D에 더 가깝다는 지적을 받았다. 원작 둠은 레이캐스팅이 아니라 BSP 트리를 사용한다. 깊이 순서를 저렴하게 계산할 수 있어 텍스처, 임의 각도의 벽, 서로 다른 바닥 높이를 감당할 수 있었던 것이 핵심이다. 이번 SQLDoom은 바로 그 BSP 기반의 진짜 둠을 재현했다는 점에서 의미가 다르다.
왜 SQL로 옮기기가 생각보다 자연스러운가
흥미롭게도 둠의 WAD 파일 포맷 자체가 이미 상당히 관계형이다. 두 개의 VERTEX는 LINEDEF로 연결되고, LINEDEF는 두 개의 SIDEDEF를 가지며, SIDEDEF는 SECTOR의 경계를 이루고 그 안에 THING이 배치되는 식이다. 이 구조를 데이터베이스로 변환하는 작업은 약 1,000줄의 파이썬으로 충분했고, 둠 1 전체를 불러오는 데 노트북 기준 18초가 걸린다고 한다. 게임 로직과 렌더링 경로는 의도적으로 분리돼 있다. 게임 로직은 35Hz 고정 루프로 돌아 원작의 모든 상수가 그대로 유효하고, 렌더러는 게임 상태 테이블의 순수 함수로 설계돼 클라이언트가 원하는 순간에 새 프레임을 요청할 수 있다. 틱(tic) 사이의 카메라 위치는 보간으로 메운다.
틱 처리처럼 본질적으로 절차적인 부분은 PL/pgSQL과 유사한 CedarDB의 스크립트 언어 cedarscript로 작성했다. 파이썬 드라이버가 1/35초마다 doom_run_game_tic 함수를 호출하면, 그 안에서 일괄 SQL 문이 실행된다. 예컨대 몬스터 AI의 상태 머신은 적의 체력이 최대 체력의 음수값 아래로 떨어지고 특정 프레임 조건이 맞을 때 'xdeath' 상태로 전환해 적이 터지는 식으로, CASE WHEN 구문만으로 표현된다. 가장 느린 틱은 E4M1에서 열린 문으로 46마리의 깨어난 몬스터가 한꺼번에 몰려드는 장면으로 10.45밀리초, 즉 28.6밀리초 예산의 약 37%를 썼다. 깨어난 몬스터가 6마리인 전형적 틱은 평균 2.15밀리초로 예산의 8% 수준이라 여유가 충분하다.
반복문 없이 짜는 게임 로직
실무적으로 가장 눈여겨볼 지점은 사고방식의 전환이다. 적을 하나씩 순회하는 대신 UPDATE ... WHERE 한 줄을 쓰면 데이터베이스가 알아서 병렬로 조건에 맞는 대상을 갱신한다. 전체 게임 로직은 약 5,900줄의 SQL로, 같은 일을 하는 원작 C 코드 약 9,000줄보다 오히려 짧다. 글쓴이는 이 과정에서 ECS(엔티티 컴포넌트 시스템) 패턴이 비로소 이해됐다고 적었다. 각 컴포넌트가 하나의 테이블이 되고, 각 시스템은 관심 있는 테이블들을 엔티티를 조인 키로 묶는 UPDATE나 INSERT가 된다는 것이다. ECS가 결국 데이터 지역성과 반복 처리에 관한 패턴이라는 점을 떠올리면, 데이터 집약적 처리에 익숙한 SQL과의 대응은 자연스럽다.
렌더링은 더 극단적이다. 모든 프레임은 레벨 지오메트리와 게임 상태, 플레이어 위치를 입력받아 완전한 프레임 버퍼를 돌려주는 하나의 거대한 뷰다. 구현은 주석을 뺀 약 1,300줄의 SQL이 89개의 CTE에 걸쳐 있는 형태로, 하나의 쿼리치고는 상당히 복잡하다. 그럼에도 linux_doom의 렌더링 엔진이 약 3,300줄인 것과 비교하면 2.5배가량 적다. 깊이 정렬의 핵심인 BSP 트리 순회도 영리하게 바꿨다. 로드 시점에 트리의 모든 경로를 미리 계산해 앞(0)/뒤(1) 선택을 bigint에 패킹한 뒤 사전식으로 정렬하면, 재귀 하강 전체가 sum() ... ORDER BY 하나로 대체된다. 40비트면 어떤 맵이든 처리 가능한데, 가장 깊은 E4M8의 BSP 트리도 32단계에 불과하기 때문이다. 노드마다 자식들의 바운딩 박스가 정의돼 있어 시야 밖 서브트리는 같은 과정에서 컬링된다.
변이 가능한 상태 없이 2.5D를 그리는 법
둠은 3D처럼 보이지만 실제로는 벽이 완벽히 수직이고 천장이 바닥과 늘 평행한 2.5D다. 덕분에 벽은 화면 열(column)마다 연속된 픽셀 구간을 차지하므로 generate_series()로 행과 열을 펼쳐 앞에서 뒤로 하나씩 칠할 수 있고, 이 벽 렌더링에 평균 1.7밀리초가 든다. 문제는 바닥과 천장, 즉 비스플레인(visplane)이다. 원작은 ceilingclip과 floorclip 배열을 순서대로 변이시키는 플러드 필 방식인데, 반복문도 변이 가능한 상태도 없는 SQL에는 그대로 옮겨지지 않는다. 그래서 정렬과 정렬된 구간에 대한 집계를 '가난한 자의 반복문'으로 삼았다. 화면 열별로 가까운 것부터 먼 것까지 정렬된 패널 목록을 두고, UNBOUNDED PRECEDING부터 바로 앞 행까지를 참조하는 윈도 함수로 아직 칠해지지 않은 구간을 계산하는 방식이다. 바닥·천장·하늘을 합쳐 대략 3밀리초가 든다.
다만 이 실험에는 솔직한 한계도 드러난다. 벽과 비스플레인, 스프라이트 단계는 실제 픽셀을 그리는 것이 아니라 같은 위치에 서로 다른 깊이를 가진 (x, y, depth, color) 후보들을 쏟아낼 뿐이다. 원작은 고정소수점 연산과 치밀하게 설계된 그리기 순서로 겹침을 원천 차단해 Z-버퍼링 없이 occlusion을 해결했지만, SQLDoom은 그 고정소수점 산술을 구현하지 않아 벽·바닥·하늘·스프라이트가 겹칠 수 있다. 결국 어딘가에서 깊이를 기준으로 최종 픽셀을 골라내야 한다. 실무자 입장에서 이 프로젝트의 가치는 '둠을 데이터베이스에서 돌렸다'는 재미 그 자체보다, 절차적 알고리즘을 집합 기반 질의로 재구성할 때 윈도 함수와 정렬이 반복문과 변이 상태를 어디까지 대신할 수 있는지, 그리고 어디서부터 그 번역이 부자연스러워지는지를 구체적인 사례로 보여 준다는 데 있다.