같은 모델인데 왜 여기선 되고 저기선 안 될까
요즘 오픈 웨이트 모델을 직접 띄워서 에이전트를 만드는 팀이 많아요. 보안 때문에 외부 API를 못 쓰거나 비용을 줄이려고 Qwen이나 Llama 계열 모델을 vLLM으로 서빙하는 경우가 대표적이죠. 그런데 막상 붙여 보면 이상한 일이 생겨요. 모델 카드에는 함수 호출(tool call) 성능이 좋다고 적혀 있는데, 실제로 돌려 보면 JSON이 깨지거나, 도구를 불러야 할 때 그냥 텍스트로 답하거나, 인자 이름을 엉뚱하게 넣거든요.
클라우드 인프라 회사 Ubicloud가 바로 이 주제, vLLM에서 tool call 정확도를 고친 경험을 블로그에 정리했어요. 제목부터 '모델을 바꿨다'가 아니라 'vLLM 쪽에서 고쳤다'는 이야기라는 게 의미가 커요. 정확도 문제가 모델이 아니라 모델을 감싼 서빙 계층에서도 생긴다는 뜻이니까요. 이 글에서는 tool call이 내부에서 어떻게 처리되는지, 어디서 새기 쉬운지 차근차근 풀어볼게요.
tool call은 사실 '텍스트 파싱'이에요
LLM은 결국 토큰(글자 조각)을 하나씩 내놓는 기계예요. 모델이 함수를 호출한다는 것도 실제로는 약속된 형식의 텍스트를 생성하는 것뿐이거든요. 예를 들어 Hermes 스타일 모델이라면 <tool_call>{"name": "get_weather", "arguments": {"city": "Seoul"}}</tool_call> 같은 문자열을 만들어요.
vLLM이 이걸 OpenAI 호환 API의 tool_calls 필드로 돌려주려면 중간에서 두 가지 작업이 필요해요. 첫째는 채팅 템플릿(chat template)이에요. 우리가 보낸 messages와 tools 목록을, 모델이 학습할 때 본 형식 그대로 프롬프트 문자열로 바꿔주는 Jinja 템플릿이죠. 둘째는 툴 파서(tool parser)예요. 모델이 생성한 텍스트에서 툴 호출 부분을 찾아내 JSON으로 꺼내는 역할인데, --enable-auto-tool-choice --tool-call-parser hermes처럼 모델 계열에 맞는 파서를 지정해서 써요.
비유하자면 통역사가 두 명 있는 셈이에요. 한 명은 우리 말을 모델 말로, 다른 한 명은 모델 말을 우리 말로 옮기죠. 모델이 아무리 똑똑해도 통역사 한 명이 실수하면 대화가 엉망이 돼요.
정확도가 새는 지점들
가장 흔한 건 템플릿 불일치예요. 이전 턴의 도구 실행 결과(tool 역할 메시지)를 모델이 학습한 형식과 다르게 넣으면, 모델은 두 번째 호출부터 헷갈리기 시작해요. 단발성 테스트에선 멀쩡하다가 멀티턴 에이전트에서만 무너지는 이유가 이거예요.
다음은 파서의 취약함이에요. 정규식 기반 파서는 공백이나 줄바꿈 하나, 혹은 여러 호출을 한 번에 내는 병렬 호출 같은 변형을 놓치기 쉬워요. 모델은 제대로 불렀는데 파서가 못 읽어서 틀린 것처럼 보이는 거죠. 스트리밍도 까다로워요. 토큰이 조금씩 들어오는 동안 미완성 JSON을 점진적으로 파싱해야 하거든요. 같은 요청이 stream=true일 때만 다르게 나온다면 여기를 의심해 보세요.
그 밖에도 툴 호출 시작 표시가 특수 토큰인 모델에서 디코딩 중 특수 토큰을 지워버리는 경우, 생각 과정을 출력하는 추론 모델에서 reasoning 파서와 tool 파서가 엇갈리는 경우, 제작사 권장 temperature를 클라이언트에서 덮어써서 형식 오류가 늘어나는 경우도 자주 보여요.
형식 자체를 강제하는 방법
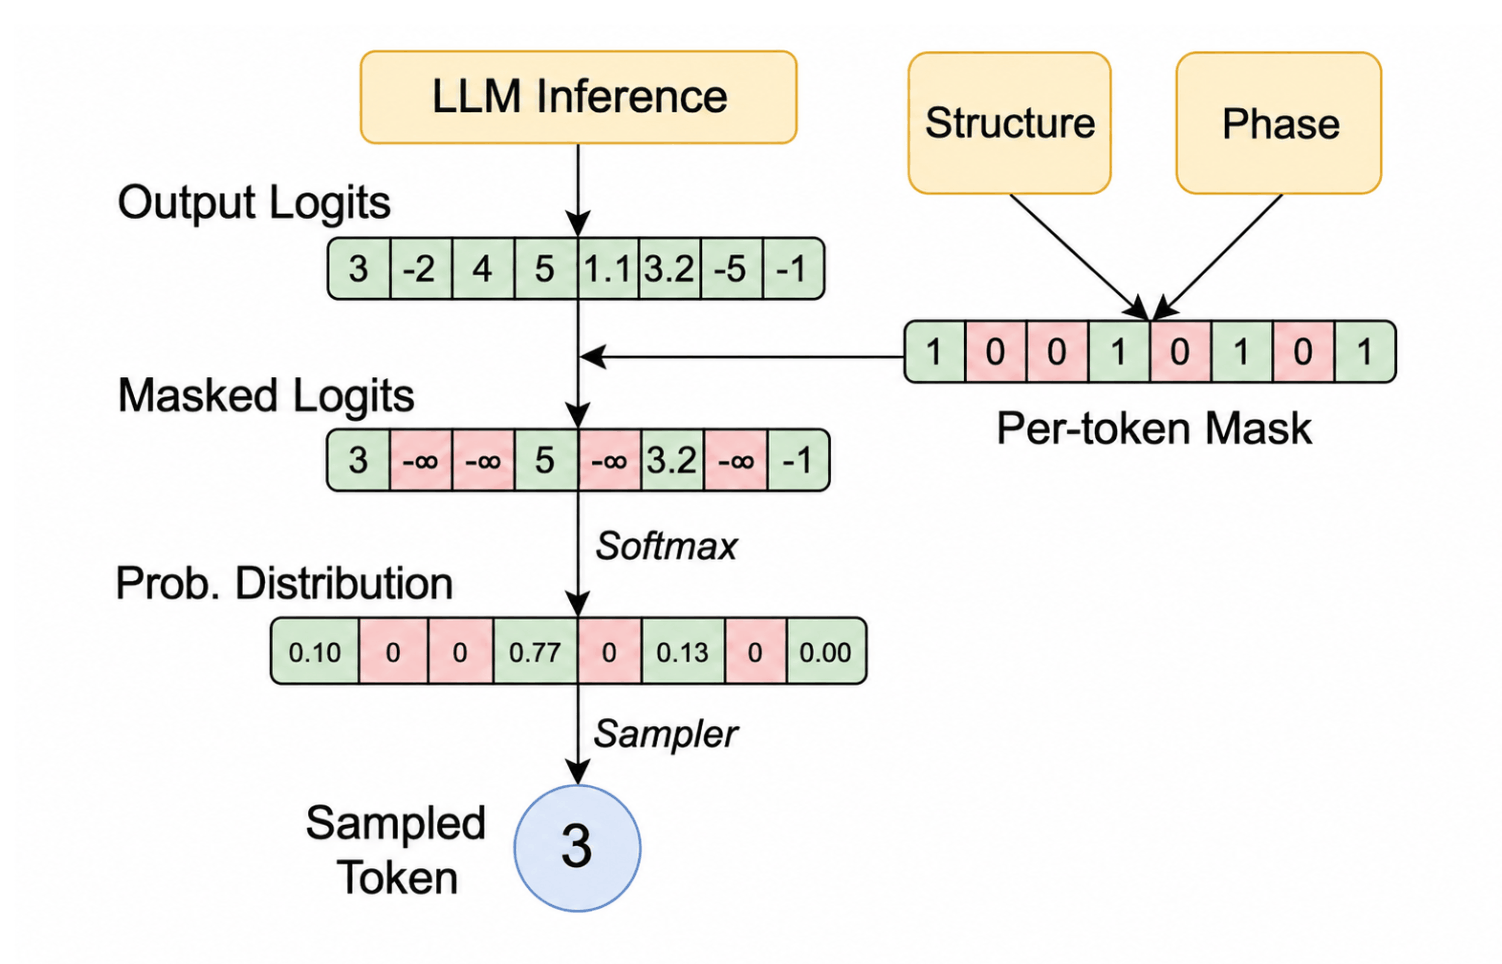
vLLM은 tool_choice를 required나 특정 함수로 지정하면 구조화 출력(guided decoding)으로 JSON 스키마에 맞는 토큰만 생성하게 해요. 이게 뭐냐면, 모델이 다음 토큰을 고를 때 스키마상 불가능한 토큰은 아예 후보에서 빼버리는 거예요. 문법이 틀린 JSON은 원천적으로 안 나오죠. 다만 어떤 도구를 고를지, 인자 값이 의미상 맞는지까지 보장하진 않고, 부를지 말지를 모델이 판단하는 auto 모드에는 쓰기 어렵다는 한계가 있어요.
업계 맥락: 같은 가중치, 다른 점수
이건 vLLM만의 문제가 아니에요. Moonshot AI는 Kimi K2를 공개한 뒤 여러 추론 제공업체의 tool call 정확도가 제각각이라는 걸 측정한 K2 Vendor Verifier를 내놨어요. 같은 가중치인데도 템플릿, 파서, 양자화 방식에 따라 결과가 벌어졌던 거죠. SGLang, llama.cpp, Ollama도 각자의 파서와 템플릿 처리 방식으로 비슷한 이슈를 계속 고치고 있고, OpenAI가 gpt-oss와 함께 harmony라는 전용 응답 포맷을 내놓은 것도 형식이 곧 성능의 일부라는 걸 보여줘요.
한국 개발자에게 주는 시사점
사내망에서 오픈 모델로 에이전트나 MCP 연동을 만드는 팀이라면 이렇게 점검해 보세요. 먼저 모델 계열에 맞는 파서와 템플릿을 쓰는지 확인하세요. 파인튜닝한 모델은 템플릿이 원본과 달라졌을 수 있어요. 그리고 모델의 원문 출력을 꼭 로그로 남기세요. 모델이 틀린 건지 파서가 못 읽은 건지 가르는 첫걸음이거든요. 실제 도구 정의로 작은 평가셋을 만들어 vLLM 버전을 올릴 때마다 돌려 보는 것도 좋아요. 파서 수정이 잦은 영역이라 버전마다 결과가 달라질 수 있어요. EXAONE이나 Kanana 같은 국산 모델을 쓸 때도 어떤 파서가 지원되는지부터 확인하는 게 순서예요.
마무리
한 줄 정리: tool call 정확도는 모델 성능 + 템플릿 + 파서 + 디코딩 설정의 합이에요. 모델을 갈아타기 전에 서빙 계층부터 의심해 보세요.
여러분은 오픈 모델에 툴 호출을 붙이면서 어떤 문제를 겪으셨나요? 파서 문제였는지 모델 문제였는지 어떻게 구분하셨는지 경험을 나눠 주세요.
🔗 출처: Hacker News