GPU가 노는 시간을 줄이려면 네트워크부터 봐야 해요
요즘 AI 학습 클러스터에서는 GPU 수천, 수만 장이 한 몸처럼 움직여요. GPU마다 계산한 결과를 서로 주고받으며 맞춰야 다음 단계로 넘어갈 수 있거든요. 이 통신이 조금만 늦어져도 한 장에 수천만 원짜리 GPU들이 멍하니 기다려야 해요. 그래서 AI 인프라 쪽에서는 '계산보다 통신이 병목'이라는 말이 자주 나와요.
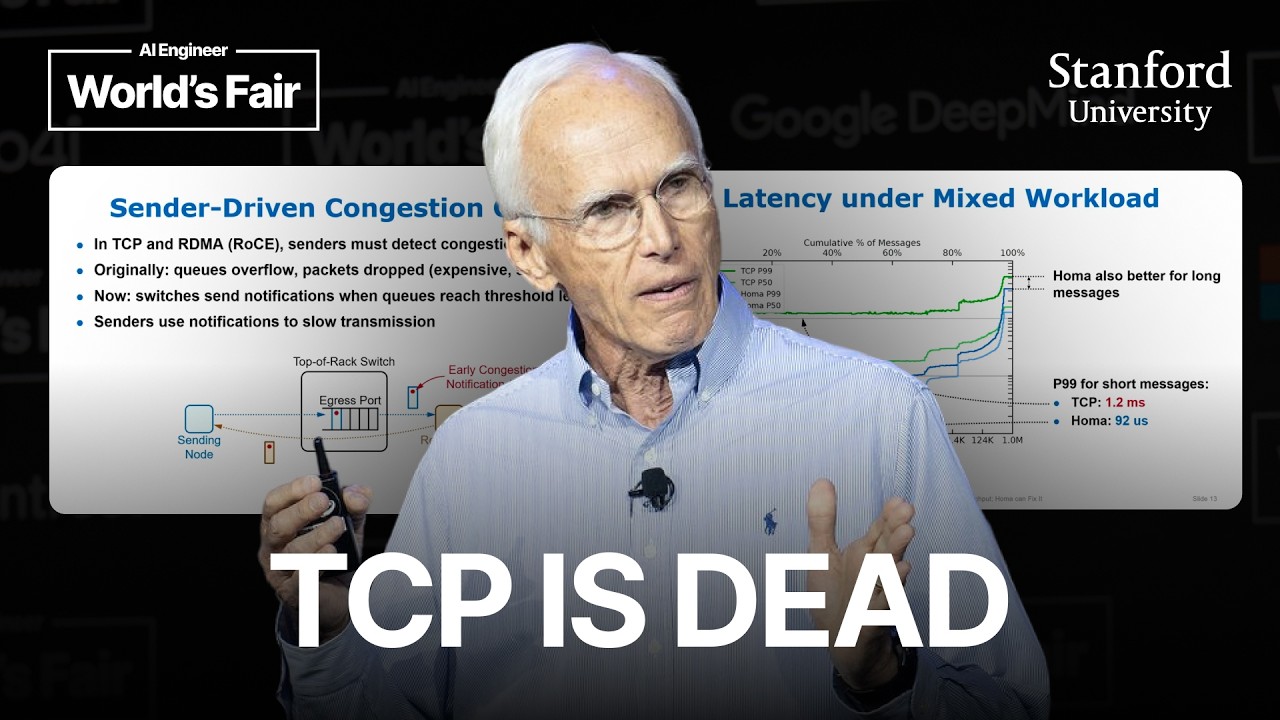
이번 영상이 파고드는 게 바로 이 지점이에요. 주인공은 스탠퍼드 존 오스터하우트(John Ousterhout) 교수 연구실이 개발해 온 전송 프로토콜 Homa예요. 2018년 SIGCOMM 학회에서 처음 발표됐어요. 오스터하우트 교수는 2022년에 'It's Time to Replace TCP in the Datacenter(이제 데이터센터에서 TCP를 바꿀 때다)'라는 도발적인 제목의 글로 이 주장을 더 밀어붙이기도 했죠. 영상은 이 이야기를 AI 클러스터로 확장해요.
TCP가 뭐가 문제길래?
TCP는 느리고 불안정한 인터넷에서 데이터를 순서대로, 빠짐없이 전달하려고 만든 프로토콜이에요. 그런데 서버끼리 수 마이크로초 거리에 붙어 있는 데이터센터에서는 몇 가지 설계가 오히려 발목을 잡아요.
첫째, '메시지'가 아니라 '바이트 스트림'을 다뤄요. TCP 입장에서 데이터는 끝없이 이어진 물줄기라서 '여기까지가 요청 하나'라는 경계를 몰라요. 그래서 한 연결 위로 큰 데이터가 흘러가는 중이면 뒤에 있는 작은 요청은 그게 끝날 때까지 기다려야 해요. 이걸 HOL(Head-of-Line) 블로킹이라고 불러요.
둘째, 연결 기반이에요. 상대마다 연결을 맺고 상태를 유지해야 해서, 노드가 수천 개면 그 관리만으로도 부담이 커요.
셋째, 혼잡 제어를 보내는 쪽이 주도해요. 송신자는 일단 보내 보고, 패킷이 유실되거나 지연이 늘어난 걸 감지한 뒤에야 속도를 줄여요. 그때는 이미 스위치 버퍼에 큐가 꽉 찬 상태죠. 여러 서버가 한 서버로 동시에 데이터를 몰아 보내는 인캐스트(incast) 상황에서는 특히 치명적이에요.
넷째, 대역폭을 '공평하게' 나눠요. 1KB 메시지와 1GB 메시지가 대역폭을 똑같이 나눠 쓰면 작은 메시지만 손해를 봐요. 우유 하나 사러 온 사람이 카트를 가득 채운 사람들 사이에서 똑같이 줄을 서는 셈이에요.
Homa는 어떻게 다르게 동작할까?
Homa는 이 네 가지를 정면으로 뒤집어요. 우선 메시지 단위의 비연결형(connectionless) 프로토콜이라서 RPC 요청과 응답을 하나하나 독립적으로 다뤄요. 큰 메시지가 작은 메시지를 막을 일이 없죠.
핵심은 수신자 주도(receiver-driven) 방식이에요. 송신자는 왕복 시간(RTT) 동안 보낼 수 있는 분량만 허락 없이 바로 보내요. 짧은 메시지는 대부분 여기서 전송이 끝나요. 그보다 긴 메시지는 수신자가 '그랜트(grant)'라는 허가 패킷을 보내 줘야 나머지를 보낼 수 있어요. 자기 쪽 링크가 얼마나 붐비는지는 수신자가 제일 잘 아니까 교통정리를 수신자에게 맡긴 거예요. 덕분에 큐가 쌓이기 전에 미리 조절할 수 있어요.
우선순위는 SRPT(Shortest Remaining Processing Time), 즉 '남은 양이 가장 적은 메시지 먼저' 원칙을 따라요. 마트로 치면 '소량 계산대'를 자동으로 운영하는 셈이죠. 이 우선순위는 일반 이더넷 스위치에 원래 있는 우선순위 큐(보통 8개)로 구현해서 특별한 하드웨어가 필요 없어요. 여기에 수신자가 여러 송신자에게 동시에 그랜트를 내주는 과할당(overcommitment)을 더해서 링크가 놀지 않게 해요.
연구팀이 낸 리눅스 커널 구현 논문에 따르면, 짧은 메시지의 꼬리 지연(tail latency, 가장 느린 상위 1% 요청의 지연)이 TCP보다 수 배에서 수십 배 낮았어요. 커널 모듈은 오픈소스로 공개돼 있고, 메인라인 편입을 위한 작업도 진행돼 왔어요.
업계는 이미 TCP 이후를 준비 중
'데이터센터에서는 TCP로 부족하다'는 생각이 Homa만의 것은 아니에요. 지금 AI 클러스터의 주류는 RDMA예요. CPU를 거치지 않고 네트워크 카드가 상대 서버 메모리에 데이터를 직접 써 넣는 기술인데요, InfiniBand와 이더넷 기반의 RoCE가 대표적이에요. 다만 RoCE는 패킷 유실을 막으려고 스위치가 흐름을 멈추는 PFC에 기대는데, 이게 혼잡을 네트워크 전체로 퍼뜨리는 부작용으로 악명이 높아요.
그래서 AMD, 브로드컴, 시스코, 인텔, 메타, 마이크로소프트 등이 모인 Ultra Ethernet Consortium(UEC)이 2025년에 1.0 사양을 내놨어요. 패킷을 여러 경로로 흩뿌리는 패킷 스프레잉, 수신자 기반 혼잡 제어 같은 아이디어가 들어 있어요. 구글은 Falcon, AWS는 SRD라는 자체 전송 계층을 쓰고 있고요. 'TCP 이후'를 둘러싼 경쟁에서 Homa는 그 원칙을 가장 깔끔하게 정리한 학계의 설계라고 볼 수 있어요.
물론 한계도 있어요. API가 TCP 소켓과 달라서 애플리케이션을 고쳐야 하고, 하드웨어 오프로드가 없으면 CPU 부담이 생겨요. 게다가 AI 학습의 all-reduce 같은 집합 통신은 큰 메시지가 대부분이라 '짧은 메시지 우대'가 얼마나 효과를 낼지는 워크로드마다 따져 봐야 해요. 'TCP의 종말'은 아직 선언에 가깝다고 보는 게 맞을 거예요.
한국 개발자에게는 어떤 의미일까?
당장 TCP를 Homa로 바꿀 일은 드물겠지만 챙겨 갈 건 분명히 있어요. 먼저 꼬리 지연과 HOL 블로킹은 일상 업무와 바로 이어져요. gRPC 호출 하나가 느려져 전체 응답이 밀리는 문제나 HTTP/3(QUIC)가 등장한 이유도 뿌리가 같거든요. QUIC이 인터넷에서 HOL 문제를 풀었다면, Homa는 데이터센터에서 더 과감하게 판을 바꾼 셈이에요.
국내에서도 GPU 클러스터 구축이 활발한 만큼, 인프라 엔지니어라면 InfiniBand냐 RoCE냐, UEC 장비를 기다리느냐 같은 결정을 마주하게 될 거예요. Homa의 설계 원칙을 알고 있으면 선택지마다 트레이드오프가 훨씬 선명하게 보여요. 분산 시스템을 공부하는 분께는 '왜 이렇게 설계했는가'를 친절하게 풀어 주는 Homa 논문 자체가 좋은 교재고요.
마무리
한 줄 정리: Homa는 '보내는 쪽이 눈치 보며 보내는' TCP 대신 '받는 쪽이 교통정리하는' 메시지 기반 전송으로 데이터센터의 꼬리 지연을 줄이려는 시도예요.
여러분 서비스에서는 평균 지연과 꼬리 지연 중 어느 쪽이 더 골치 아픈가요? 데이터센터 내부 통신이 결국 TCP를 떠날지, 아니면 TCP가 이번에도 버텨낼지 의견이 궁금해요.
🔗 출처: Hacker News