AI가 알고리즘을 개선했다는 뉴스, 또 나왔어요
최근 몇 년 동안 AI가 오래된 알고리즘을 더 빠르게 만들었다는 소식이 꾸준히 나오고 있어요. 2022년 딥마인드의 AlphaTensor는 행렬 곱셈에 필요한 곱셈 횟수를 줄이는 방법을 찾았고, 2023년 AlphaDev가 개선한 짧은 배열 정렬 루틴은 LLVM 표준 라이브러리에 들어갔어요. 2025년 AlphaEvolve는 4×4 복소수 행렬을 곱셈 48번으로 곱하는 방법을 내놓았고요.
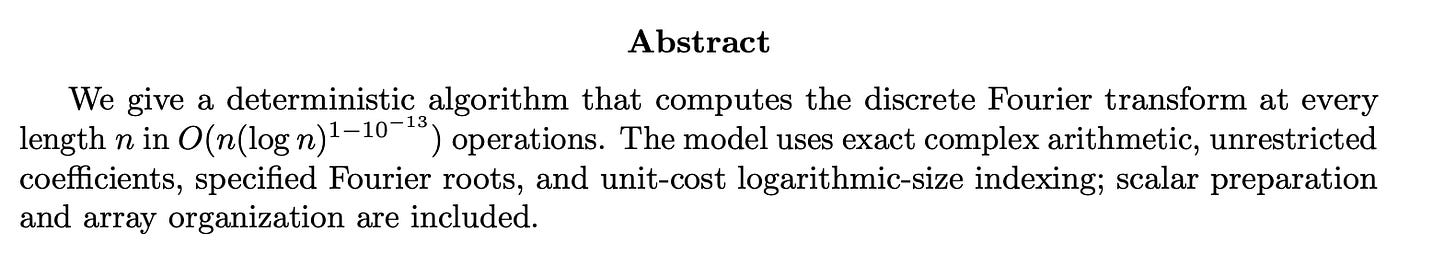
이번엔 OpenAI예요. OpenAI가 푸리에 변환을 더 빠르게 계산하는 방법을 찾았다고 주장했고, UC 버클리의 벤 레시트(Ben Recht) 교수가 자기 블로그 argmin에 그 주장 뒤에 있는 수학을 직접 살펴보는 글을 썼어요. 이 소식을 제대로 이해하려면 FFT가 뭔지, 그리고 여기서 말하는 ‘더 빠르다’가 정확히 무슨 뜻인지부터 알아야 해요.
푸리에 변환이 뭐냐면
푸리에 변환은 복잡한 신호를 여러 주파수의 단순한 파동으로 나누는 수학 도구예요. 스무디 한 잔을 맛보고 바나나가 몇 %, 딸기가 몇 % 들어갔는지 알아내는 것과 비슷해요. 음악 앱의 이퀄라이저, 이미지 처리, 5G 통신의 OFDM 변조, 아주 큰 수의 곱셈, 딥러닝의 합성곱 연산까지 정말 여기저기서 쓰여요.
길이가 n인 데이터를 정의대로 계산하면 연산이 n²번 정도 필요해요. 1965년 쿨리(Cooley)와 튜키(Tukey)가 이걸 n log n 수준으로 줄인 FFT(고속 푸리에 변환)를 발표했는데요, 비슷한 아이디어는 1805년경 가우스가 발표하지 않은 노트에도 있었다고 해요. 핵심은 큰 문제를 절반 크기 문제 두 개로 나누고, 그걸 또 나누는 분할 정복이에요. n이 100만이면 n²은 1조, n log n은 약 2천만이니까 차이가 엄청나죠.
이미 빠른데, 뭘 더 빠르게 한다는 걸까
여기가 포인트예요. n log n이라는 큰 틀은 60년 가까이 그대로예요. 그래서 그 뒤의 경쟁은 주로 앞에 붙는 상수, 그러니까 실수 덧셈과 곱셈을 정확히 몇 번 하느냐를 두고 벌어졌어요.
- 기본적인 radix-2 FFT는 실수 연산이 대략 5n log₂n번 필요해요.
- 1968년 처음 나온 split-radix 방식은 이걸 약 4n log₂n번으로 줄였어요.
- 2007년 존슨(Johnson)과 프리고(Frigo)가 수정한 split-radix로 약 (34/9)n log₂n번까지 낮췄는데, 기존보다 5% 남짓 줄어든 수준이에요.
연산 횟수가 줄면 진짜 빨라질까
함정이 하나 더 있어요. 연산 횟수가 줄었다고 실제 실행 시간도 줄어드는 건 아니에요. 요즘 CPU와 GPU에서는 계산보다 메모리에서 데이터를 가져오는 시간이 훨씬 비싸거든요. 캐시를 얼마나 잘 쓰는지, SIMD(한 번에 여러 데이터를 처리하는 명령어)에 잘 맞는 구조인지가 성능을 좌우해요. 앞에서 나온 존슨과 프리고는 유명한 FFT 라이브러리 FFTW를 만든 사람들이기도 해요. FFTW는 이론상 연산 수를 보는 대신, 실제 기계에서 여러 방법을 돌려보고 가장 빠른 걸 골라요. 연산 수가 가장 적다고 성능이 가장 좋은 건 아니라는 걸 누구보다 잘 아는 셈이죠.
그래서 이런 주장을 볼 때는 몇 가지 질문을 해보는 게 좋아요. 무엇을 셌나요(곱셈만? 전체 연산? 실제 시간?), 어떤 크기에서 측정했나요, 비교 대상이 교과서에 나오는 radix-2인가요 아니면 지금 알려진 최선의 방법인가요, 그리고 정말 새로운 수학인가요 아니면 이미 알려진 기법을 다시 찾아낸 건가요? 레시트 교수의 글은 이런 관점에서 주장에 담긴 수학을 하나씩 짚어보니까, 원문을 읽을 때 이 질문들을 옆에 두면 훨씬 잘 읽혀요.
한국 개발자에게 주는 시사점
실무에서는 간단해요. FFT가 필요하면 직접 짜지 말고 NumPy, FFTW, cuFFT 같은 검증된 라이브러리를 쓰세요. 이론적인 개선이 실제로 쓸모가 있다면 결국 이런 라이브러리에 들어가요. 신호 처리나 ML 인프라를 다룬다면 병목이 연산보다 메모리에 있는 경우가 많다는 감각도 꼭 챙겨두세요.
앞으로 AI가 발견했다는 알고리즘 뉴스는 점점 많아질 거예요. 그때마다 헤드라인에 휩쓸리지 말고 무엇을, 무엇과 비교해, 어떤 기준으로 쟀는지 물어보는 습관이 엔지니어에게 큰 무기가 돼요.
마무리
한 줄 정리: FFT는 이미 n log n이라 개선할 여지는 상수와 실제 하드웨어 성능에 있고, AI가 찾았다는 개선도 그 기준으로 따져봐야 해요.
여러분은 AI가 기존 알고리즘을 개선했다는 뉴스를 보면 무엇부터 확인하시나요? 연산 횟수 개선과 실제 속도 개선 중 어느 쪽이 더 의미 있는 성과라고 생각하세요?
🔗 출처: Hacker News