무슨 일이냐면
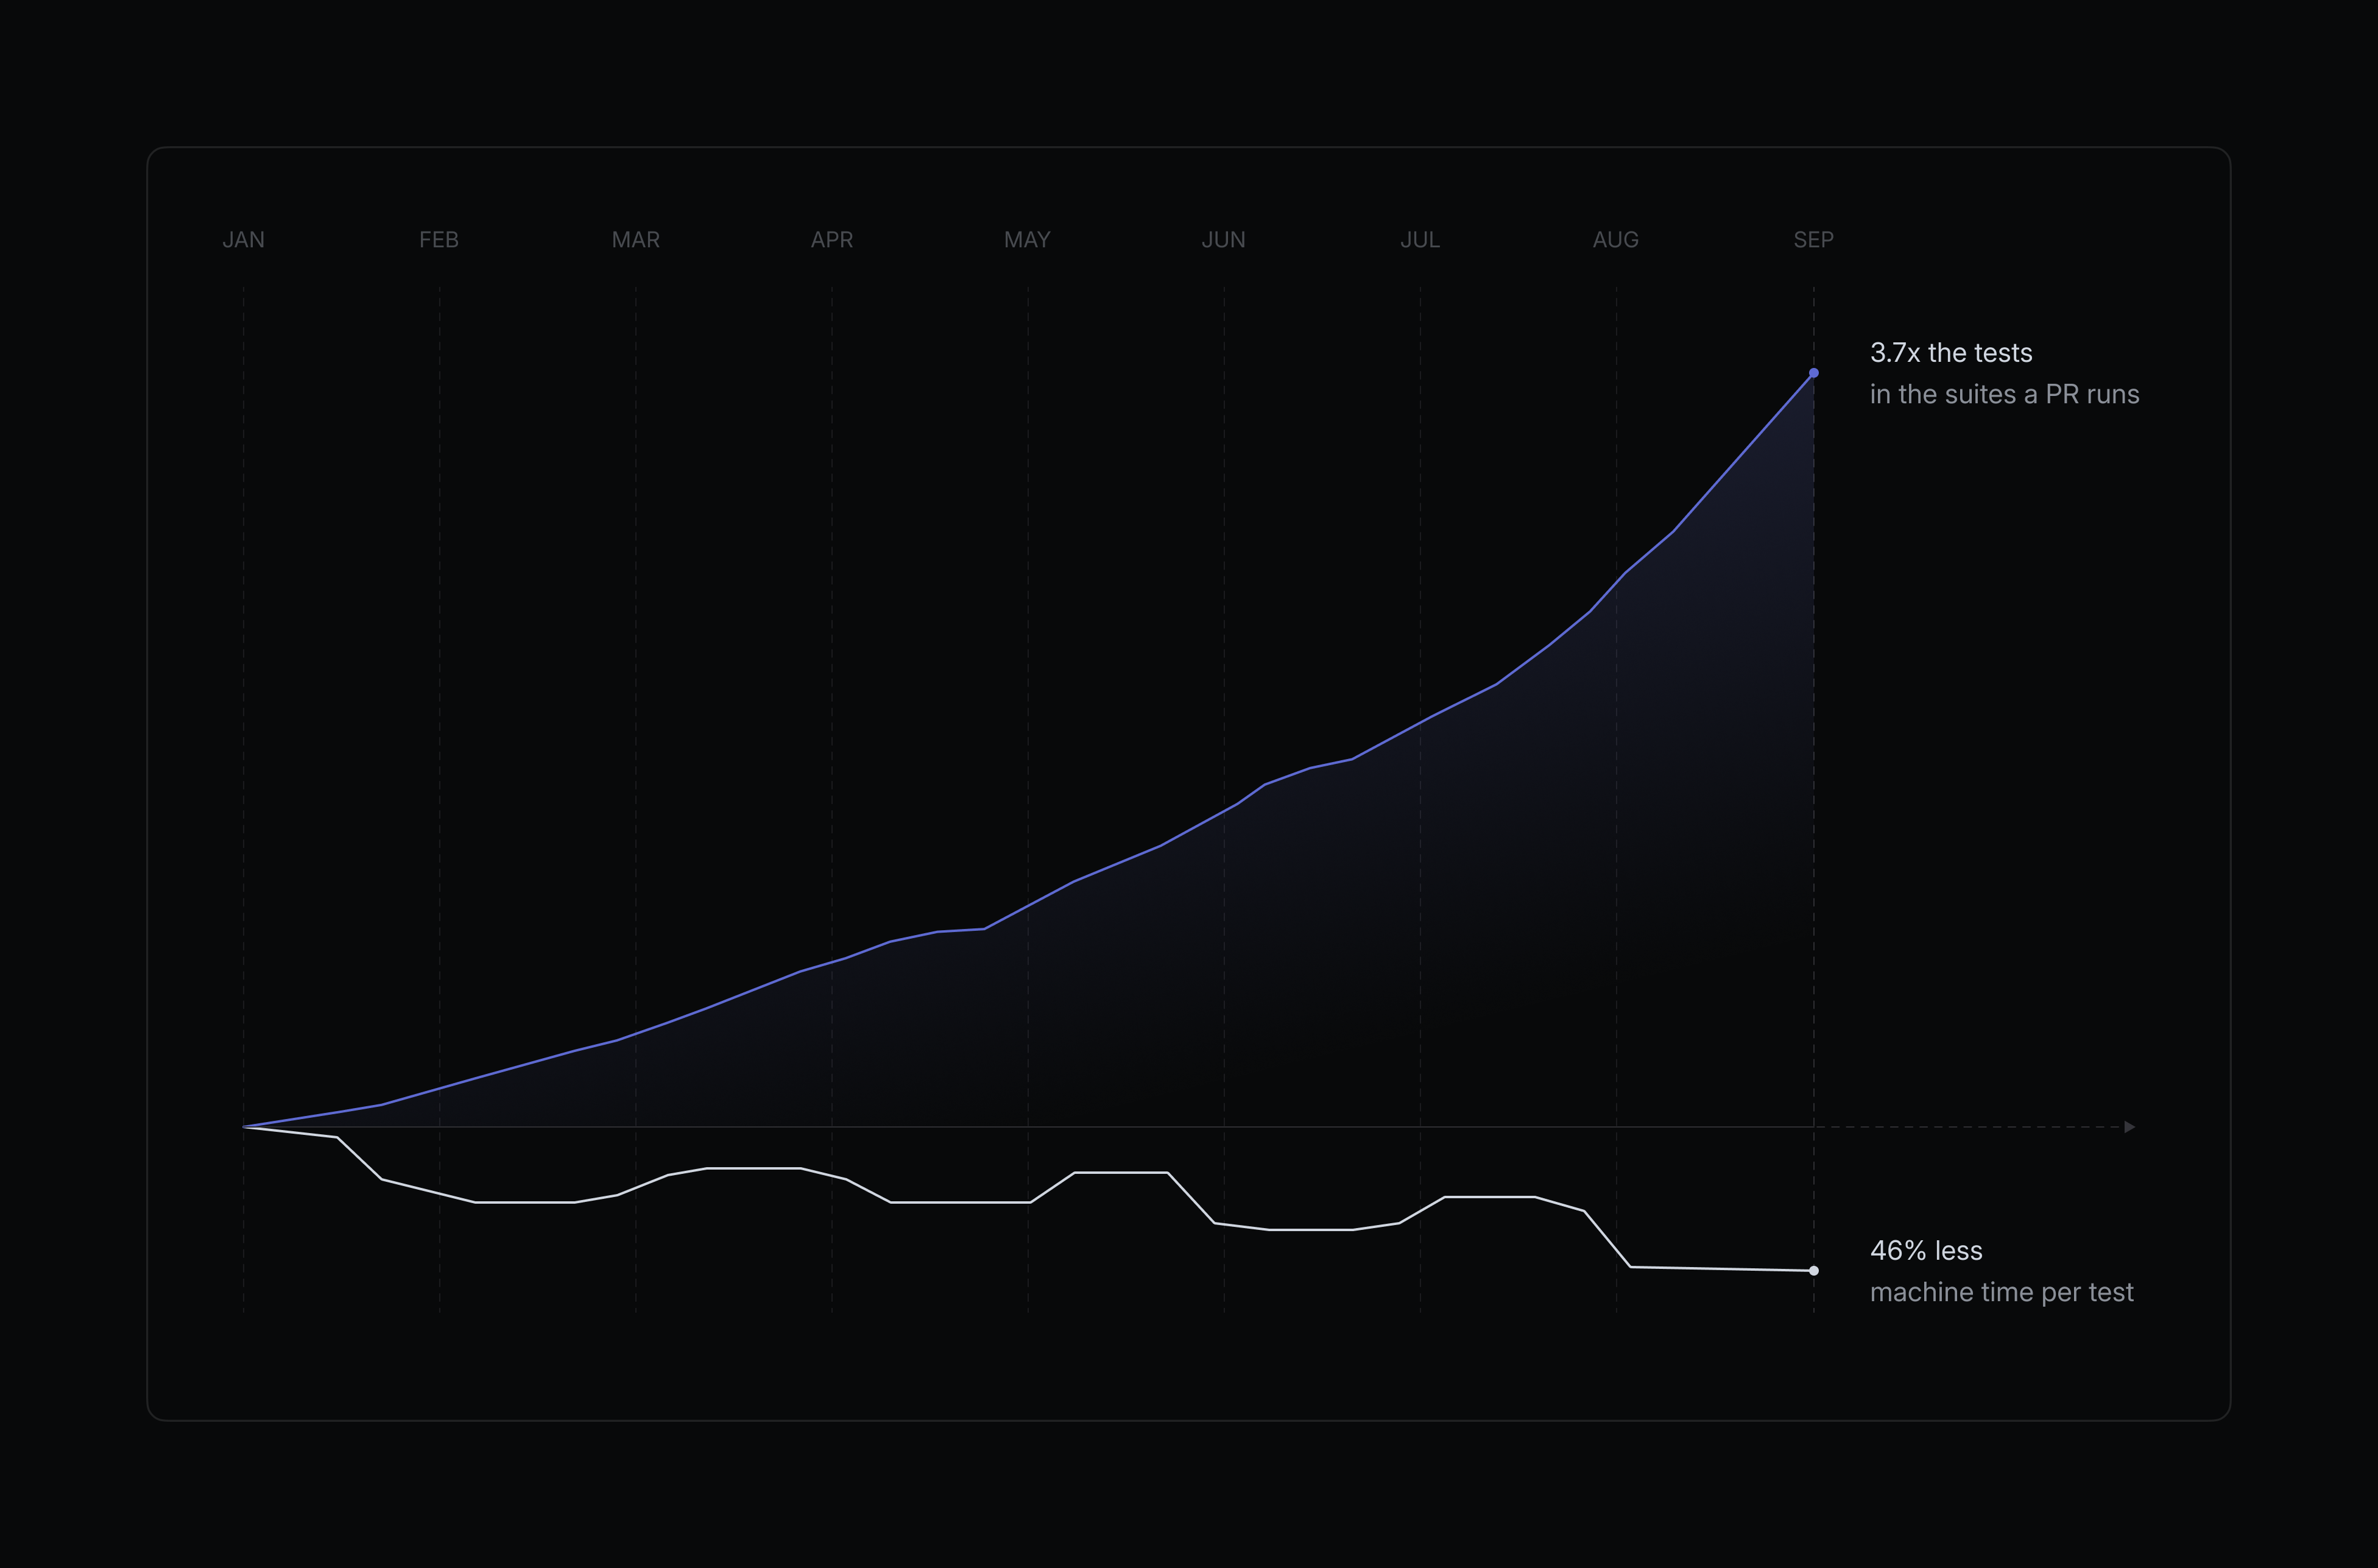
Linear는 이슈 트래커를 만드는 회사예요. 지라(Jira)의 대안으로 스타트업들 사이에서 인기가 많고, 제품 완성도와 엔지니어링 문화로 유명한 곳이죠. 그런 회사의 엔지니어링 블로그에 꽤 솔직한 글이 올라왔어요. 요지는 이거예요. AI 코딩 도구 덕분에 코드가 쏟아지기 시작했더니, CI가 병목이 돼서 통째로 뜯어고쳤다.
CI가 뭐냐면, Continuous Integration(지속적 통합)의 약자로, 개발자가 코드를 올릴 때마다 자동으로 빌드하고 테스트를 돌려서 “이거 합쳐도 되나?”를 검사해 주는 시스템이에요. GitHub Actions, Jenkins, CircleCI 같은 게 대표적이죠. 예전엔 있으면 좋은 도구 정도였다면, 지금은 배포 파이프라인의 심장이에요.
왜 갑자기 병목이 됐나
원리는 단순해요. CI에 들어가는 총 비용은 대략 “커밋 수 × 한 번 돌리는 데 걸리는 시간”이에요. 지금까지 이 식에서 커밋 수는 사람이 코드를 쓰는 속도로 제한돼 있었어요. 하루에 PR 두세 개면 많은 편이었으니까요.
그런데 Claude Code나 Cursor 같은 에이전트가 들어오면서 한 사람이 하루에 PR 열 개를 올리는 게 이상하지 않게 됐고, 에이전트는 한 PR 안에서도 “테스트 실패했네, 고쳐서 다시 푸시”를 몇 번씩 반복하거든요. 커밋 수가 몇 배로 뛰니까 CI 대기열이 밀리기 시작한 거예요.
여기서 대기열 이론이 등장해요. 이게 뭐냐면, 은행 창구를 생각하시면 돼요. 창구 사용률이 70%일 땐 대기 시간이 짧은데, 95%를 넘어가면 대기 시간이 폭발적으로 늘어나요. CI 러너(테스트를 실제로 실행하는 머신)도 똑같아서, 사용률이 한계에 가까워지면 “내 PR 테스트 시작까지 40분 대기” 같은 일이 벌어져요. 사람은 그 40분 동안 다른 일을 하다가 컨텍스트를 잃어버리고, 에이전트는 결과를 기다리며 토큰과 시간을 낭비하죠.
Linear가 손본 방향
이런 문제를 풀 때 쓰는 처방은 몇 가지로 정해져 있고, Linear의 접근도 그 범주 안에 있어요. 세부 수치는 원문을 보시길 권하고, 여기서는 각 처방이 왜 효과가 있는지 설명해 드릴게요.
바뀐 부분만 테스트하기. 모노레포(여러 프로젝트를 한 저장소에 두는 방식)에서 프론트엔드 버튼 색을 바꿨는데 백엔드 테스트까지 다 도는 건 낭비죠. Nx, Turborepo, Bazel 같은 도구는 변경된 파일이 영향을 주는 패키지만 골라서 테스트해요. 이것만으로 CI 시간이 절반 이하로 줄어드는 경우가 흔해요.
테스트 샤딩과 병렬화. 테스트 3,000개를 한 머신에서 30분 돌리는 대신, 10개 머신에 300개씩 나눠서 3분에 끝내는 거예요. 단, 테스트끼리 서로 의존하지 않아야 하고, 나누는 기준을 파일 수가 아니라 실행 시간으로 잡아야 효과가 나요.
캐시 제대로 쓰기. 의존성 설치, Docker 레이어, 빌드 산출물을 매번 새로 만들지 않고 원격 캐시에서 가져오는 거예요. 의외로 많은 팀이 CI 시간의 30~40%를 npm install에 쓰고 있어요.
빠른 검사와 느린 검사 나누기. 린트, 타입 체크, 유닛 테스트처럼 1~2분이면 끝나는 건 먼저 돌려서 빨리 피드백을 주고, E2E나 통합 테스트는 그 뒤에 돌리는 방식이에요. 에이전트가 “아, 타입 에러네” 하고 30초 만에 고칠 수 있게 되니까 전체 순환이 빨라져요.
머지 큐(merge queue). PR이 많아지면 “내 PR은 통과했는데 다른 PR이랑 합치니까 깨지는” 문제가 생겨요. 머지 큐는 PR들을 줄 세워서 합쳐질 순서대로 미리 테스트해 주는 장치인데, GitHub에도 내장돼 있어요.
불안정한 테스트 격리. 돌릴 때마다 결과가 다른 테스트(flaky test)는 CI 재시도를 유발해서 대기열을 두 배로 잡아먹어요. 이런 테스트를 자동으로 찾아서 격리하는 게 생각보다 큰 효과를 내요.
업계 맥락
이 문제는 Linear만의 것이 아니에요. 구글은 오래전부터 TAP이라는 시스템으로 변경 영향 분석 기반 테스트를 했고, 우버는 SubmitQueue라는 머지 큐를 논문으로 냈어요. 최근엔 Depot, Blacksmith, Namespace처럼 “GitHub Actions보다 2배 빠른 러너”를 파는 스타트업들이 잘나가고 있고요. AI 코딩이 이 시장을 키우고 있는 셈이에요.
더 큰 그림에서 보면, 개발 인프라 전체가 “사람 속도”에서 “기계 속도”로 재설계되고 있어요. 코드 생성이 빨라지면 리뷰, CI, 배포, 모니터링이 차례로 병목이 되거든요. Linear의 글은 그중 첫 번째 병목인 CI를 어떻게 넘겼는지에 대한 사례예요.
한국 개발자에게 주는 시사점
GitHub Actions나 젠킨스를 쓰는 국내 팀이라면, 먼저 측정부터 하세요. PR 올린 시점부터 CI 결과 나올 때까지 p50과 p95 시간을 재보면 지금 문제가 대기열인지, 실행 시간인지, 불안정한 테스트인지 바로 보여요. 그다음 캐시와 영향 범위 분석은 비용 거의 없이 적용할 수 있는 처방이에요.
비용 관점도 잊지 마세요. AI 코딩 도입 후 CI 분 단위 요금이 두세 배 뛰었다는 팀이 꽤 많아요. 에이전트가 푸시할 때마다 전체 테스트가 도는 구조라면, 요금 고지서가 먼저 병목을 알려줄 거예요.
마무리
한 줄 요약: AI가 코드 쓰는 속도를 올렸다면, CI도 그 속도에 맞춰 다시 설계해야 해요. 사람 기준으로 만든 파이프라인은 기계 속도를 못 버텨요.
여러분 팀은 AI 코딩 도입 후 CI 대기 시간이 어떻게 변했나요? 어떤 처방이 제일 효과가 있었는지 궁금해요.
🔗 출처: Hacker News