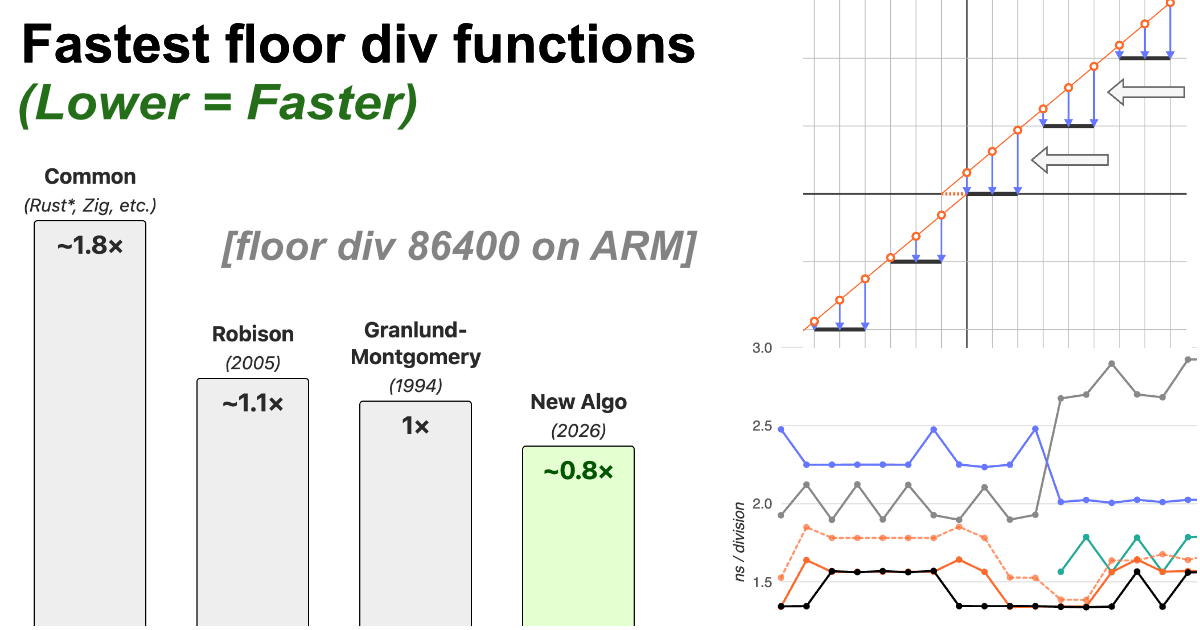
정수 나눗셈을 다룰 때 대부분의 개발자는 C, C++, 자바스크립트 같은 언어가 기본으로 제공하는 "/" 연산에 익숙하다. 그러나 이 기본 연산은 0을 향해 버림(truncation)하는 방식이어서, 반복적으로 순환하는 값을 다룰 때 종종 틀린 결과를 낸다. 반면 바닥 나눗셈(floor division)은 결과를 음의 무한대 방향으로 내림한다. 벤 조페(Ben Joffe)의 글은 이 바닥 나눗셈, 그중에서도 나누는 수(제수)가 컴파일 시점에 고정되어 있는 전체 범위(full-range) 바닥 나눗셈을 더 빠르게 계산하는 방법을 정리하고, 지금껏 문서화되지 않았던 새로운 접근을 제안한다. 저자는 이를 두고 "해커스 딜라이트(Hacker's Delight)에서 빠진 장"이라고 부른다.
왜 바닥 나눗셈이 문제인가
가장 흔한 예가 유닉스 타임스탬프를 날짜 수(rata-die)로 바꾸는 작업이다. 초 단위 타임스탬프를 하루의 초 수인 86400으로 나누면 되는데, 32비트로는 약 ±68년밖에 담지 못하므로 64비트를 쓴다. 문제는 버림 나눗셈을 쓰면 1970년 이전, 즉 음수 타임스탬프 대부분에서 잘못된 값이 나온다는 점이다. 음수이면서 86400으로 정확히 나누어떨어지는 경우에는 맞지만, 나머지가 음수일 때는 결과를 1만큼 보정해야 한다. 각도 회전, 타일 좌표처럼 주기적으로 반복되는 값을 추적할 때도 똑같은 함정이 반복된다. 이때 짝을 이루는 "%" 연산이 진짜 양수 나머지(modulus)를 돌려준다는 점도 바닥 나눗셈의 실용적 가치다. C++이나 자바스크립트의 "%"는 음수에서 가짜 나머지를 주기 때문이다.
내부적으로 컴파일러가 만들어내는 일반 나눗셈은 사실 "곱셈 후 시프트(mul-shift)"에 음수일 때 1을 더하는 보정으로 구현된다. 최상위 비트를 맨 아래로 내려(부호 비트 추출) 음수 여부를 판별하는 식이다. 다만 100으로 나누는 64비트 경우처럼, 매직 상수 M이 64비트를 모두 써서 음수가 되어버리는 "비협조적(uncooperative) 제수"에서는 상위 레지스터에 피제수를 더해 2의 64승만큼 어긋난 값을 바로잡는 추가 연산이 붙는다. 요점은 일반 나눗셈이 대략 곱셈 한 번에 2~3 사이클 정도의 비용이라는 것이다.
기존 해법과 그 한계
저자는 "빠른 바닥 나눗셈"을 검색했을 때 마주치는 현실을 신랄하게 짚는다. 흔히 나오는 AI 요약은 "가장 빠른 분기 없는 방법"이라고 주장하지만, 실제로는 30년 넘게 알려진 더 빠른 기법을 외면한 평범한 루틴을 제시한다. 그나마 이 코드가 자바의 Math.floorDiv, 파이썬 numpy, Zig, 루비 등 다수 라이브러리가 쓰는 방식과 사실상 같다. 해커스 딜라이트 2판 역시 "모듈러스와 바닥 나눗셈에 대한 적용 가능성"이라는 절을 두고 있으나 구체적 해법은 내놓지 않는다. 스택오버플로의 유명한 질문 글도 상위 답변 대부분이 같은 기법을 반복할 뿐이었고, 7년이 지나서야 ufoguy라는 사용자가 나머지 연산 없이 나눗셈 한 번으로 끝내는, 분기 없는 더 빠른 방법을 올렸다. 저자의 벤치마크에서 이 방식은 대부분 기기에서 약 50% 높은 처리량을 보였다. 다만 음의 제수를 처리하지 못한다는 한계가 지적됐고, 이 일반 사례는 이미 1994년 그란룬드·몽고메리의 논문 "Division by Invariant Integers using Multiplication"에서 깔끔하게 해결되어 있었다.
이 논문의 기법으로 비영(非零) 상수 제수를 받는 유연한 템플릿 함수를 만들 수 있다. 논문은 완전히 분기 없는 버전도 제시하지만, 저자는 상수 나눗셈이라면 분기가 있는 쪽을 선호한다. 분기 조건이 컴파일 시점에 결정되어 반드시 단순화되고, 컴파일러가 (x < 0) 같은 반복 비교를 알아서 재사용하기 때문이다. 실제로 완전 분기 제거 버전은 MSVC가 잘 단순화하지 못하는 경우가 있다.
새로운 접근과 실무적 의미
여기서 끝이 아니다. 앞 단계의 나눗셈은 잘해야 곱셈-시프트에 5~6 사이클이 붙는다. 그란룬드·몽고메리에게는 양의 제수에만 명시된 또 하나의 기법이 있는데, 핵심은 입력을 x ^ s 연산으로 비음수 영역으로 옮기는 것이다. 음수는 -1-x가 되어 -0.5를 기준으로 반사되며, 그 결과 피연산자 a가 부호 없는 데다 0..2^63-1의 절반 범위만 가지게 된다. 덕분에 비협조적 제수에서도 곱셈-시프트가 모든 경우에 성립한다. 이렇게 하면 곱셈-시프트에 3 사이클 수준으로 줄어든다. ARM에서는 시프트가 XOR과 융합되어 이론상 2 사이클까지 가능하지만, 실제 테스트 기기에서는 사이클 계산만큼의 체감 이득이 나오지 않았다고 한다. 이 기법을 실제로 쓰는 라이브러리로는 PyPy가 유일하게 확인됐는데, 그마저 음의 제수에서는 div/mod 방식으로 되돌아간다.
또 하나 주목할 논문은 2005년 아치 D. 로비슨의 "N-Bit Unsigned Division Via N-Bit Multiply-Add"다. 주로 부호 없는 나눗셈을 다루지만 4.3절이 바닥 나눗셈을 다루며, 분기나 삼항 연산 없이 상당수 경우에 단순한 곱셈-덧셈-시프트로 끝난다. ARM에서는 단일 융합 곱셈-누산(multiply-accumulate) 뒤 우측 시프트로 컴파일되고, ARM32에서도 smlal 명령으로 64비트 에뮬레이션 없이 처리된다. x86-64는 mul, add, shift로 무난하며, 32비트 x86에서는 하위 레지스터 덧셈 뒤 캐리를 상위에 더하는 adc가 붙어 조금 덜 깔끔하지만 치명적이지는 않다.
실무적으로 이 글의 가치는 분명하다. 86400 같은 고정 제수로 나누는 연산은 타임스탬프 변환, 각도·좌표 정규화처럼 흔하면서도 성능에 민감한 자리에 숨어 있다. 저자는 제수와 비트 폭을 지정하면 복사해 쓸 수 있는 함수 생성기와, 미세 아키텍처 튜닝을 담은 재사용 C++ 템플릿, 그리고 -32768부터 32767까지 65535개 제수를 경계 테스트와 함께 검증하는 단일 C++ 파일을 함께 제공한다. 기법 자체가 매우 단순해 누군가 이미 했을 법한데도 문서화된 곳을 찾지 못했다는 저자의 말은, 역설적으로 이 영역이 오랫동안 방치되어 있었음을 보여준다. 다만 이 모든 이점은 제수가 컴파일 시점에 알려진 경우에 한정된다. 런타임에 제수가 정해지는 경우에 대해서는 저자 스스로 조사하지 않았다고 밝히므로, 적용 전 자신의 사용 맥락이 상수 제수인지부터 확인하는 것이 먼저다.