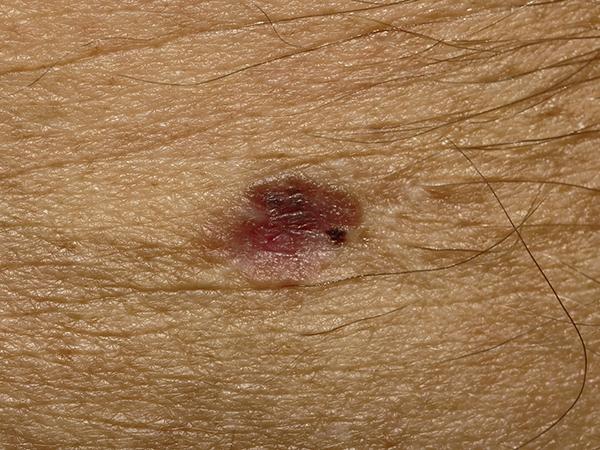
무슨 일이 있었냐면요
요즘 AI 얘기가 나오면 다들 GPT, Gemini, Claude 같은 최신 대형 언어 모델(LLM)부터 꺼내잖아요. 이미지도 보고, 코드도 짜고, 논문도 요약해 주니까 '이제 웬만한 건 LLM 하나면 되겠다'는 분위기거든요. 그런데 피부암 진단처럼 아주 구체적인 문제에서는 얘기가 좀 다르다는 연구 결과가 나왔어요. 거의 10년 전 기술인 CNN 기반 피부 병변 분류 모델이 최신 프론티어 LLM들보다 피부암을 더 정확하게 가려냈다고 해요.
이게 흥미로운 건 '최신이면 무조건 최고'라는 우리 직관을 정면으로 건드리기 때문이에요. 모델 크기도 학습 비용도 비교가 안 되는데, 오래되고 작은 모델이 이겼으니까요. 그래서 이 결과는 '어떤 문제에 어떤 도구를 쓸지'를 다시 생각해 보게 만들어요.
CNN이 뭐고, 왜 이걸 잘하냐면요
CNN(합성곱 신경망)은 이미지를 작은 조각 단위로 훑어보면서 패턴을 찾는 신경망이에요. 돋보기를 들고 사진 위를 한 칸씩 옮기면서 '여기 경계선이 있네, 여기 색이 얼룩덜룩하네' 하고 메모하는 모습을 떠올리면 돼요. 층을 깊게 쌓을수록 앞쪽 층은 선이나 점 같은 단순한 특징을 잡고, 뒤쪽 층은 비대칭적인 테두리나 불규칙한 색소 분포처럼 복잡한 특징을 잡아내요. 피부과 의사들이 흑색종을 볼 때 확인하는 단서와도 꽤 닮았어요.
2010년대 중반에는 피부과 전문의 수준으로 피부 병변을 분류하는 CNN 연구가 많이 나왔는데요. 이런 모델은 '양성/악성' 라벨이 붙은 피부 병변 사진 수만~수십만 장으로 딱 그 한 가지 일만 학습했어요. 대표적인 공개 데이터셋이 ISIC(국제 피부 영상 협력) 아카이브고요. 한 우물만 판 전문가 모델인 셈이에요.
LLM은 왜 밀렸을까요
멀티모달 LLM도 이미지를 이해하지만, 기본적으로는 인터넷 규모의 텍스트와 이미지를 두루 학습한 제너럴리스트예요. 고양이 사진, 차트, 손글씨, 밈까지 다 아는 대신 피부 병변 사진의 미세한 색소 패턴 차이는 상대적으로 적게 봤을 가능성이 크죠. 그 밖에도 이유를 몇 가지 짐작해 볼 수 있어요.
먼저 이미지 처리 방식이에요. LLM은 이미지를 작은 패치 단위 토큰으로 압축해서 받아들이는데, 이 과정에서 진단에 중요한 아주 작은 디테일이 뭉개질 수 있거든요.
다음은 확신도 보정(calibration) 문제예요. 이게 뭐냐면, 모델이 '80% 확신해요'라고 했을 때 실제로도 80% 정도 맞느냐는 거예요. CNN은 확률값을 숫자로 바로 내놓아서 기준선(임계값)을 조절하기 쉬운데, LLM은 말로 답하다 보니 틀린 답도 자신 있게 들릴 수 있어요.
마지막으로 의료에서는 민감도(sensitivity)가 정말 중요해요. 암을 암이 아니라고 놓치는 실수(위음성)가 훨씬 치명적이라서, 놓치지 않는 쪽으로 임계값을 조정할 수 있는 구조가 큰 장점이 되거든요.
업계 맥락: 스페셜리스트 vs 제너럴리스트
사실 이런 일은 처음이 아니에요. 표 형태의 데이터에서는 지금도 XGBoost 같은 그래디언트 부스팅 모델이 딥러닝보다 나은 경우가 많고, 제조 현장의 불량 검출이나 특정 문서 분류에서도 작은 전용 모델이 LLM보다 빠르고 정확할 때가 흔해요. 그래서 빅테크도 범용 모델에 의료 데이터를 추가로 학습시킨 의료 특화 LLM을 계속 연구하고 있고요.
규제 관점도 있어요. 의료기기로 허가받는 AI는 보통 입력과 출력이 명확한 좁은 모델이에요. 같은 입력에 늘 같은 결과가 나와야 검증할 수 있거든요. LLM은 답이 매번 조금씩 달라질 수 있고, 버전이 바뀌면 동작도 달라지니까 이런 검증 절차와 잘 맞지 않아요. 국내에서도 의료 영상 AI 기업들이 특정 질환에 집중한 전용 모델로 인허가를 받아 온 것도 같은 이유예요.
한국 개발자에게 주는 시사점
실무에서 가져갈 교훈은 꽤 분명해요.
- 문제 정의가 먼저예요. 해야 할 일이 좁고 라벨 데이터가 있다면, 'LLM 붙이면 되겠지'보다 작은 전용 모델이 더 정확하고 싸고 빠를 수 있어요.
- 비용·속도·개인정보까지 따져 보세요. CNN은 모바일이나 엣지 기기에서도 돌아가고 API 호출 비용도 없어요. 의료 데이터처럼 민감한 정보를 외부 API로 보내지 않아도 된다는 점도 국내 개인정보보호 규정을 생각하면 큰 장점이에요.
- 둘을 섞는 방법도 있어요. 판단은 전용 모델이 하고, LLM은 결과 설명이나 리포트 작성, 사용자 응대를 맡는 구조가 현실적이에요.
- 직접 벤치마크를 만들어 보세요. 우리 도메인 데이터로 두 방식을 나란히 비교해 보면, 뭐가 나은지 생각보다 금방 보여요.
마무리
한 줄 정리: 범용 AI가 강력해진 건 맞지만, 좁고 중요한 문제에서는 여전히 그 문제 하나만 파고든 모델이 이길 수 있어요.
여러분은 프로젝트에서 LLM 대신 작은 전용 모델을 써서 더 좋은 결과를 낸 경험이 있나요? 그리고 의료처럼 실수가 치명적인 분야에서 LLM을 어디까지 써도 된다고 보시는지 궁금해요.
🔗 출처: Hacker News