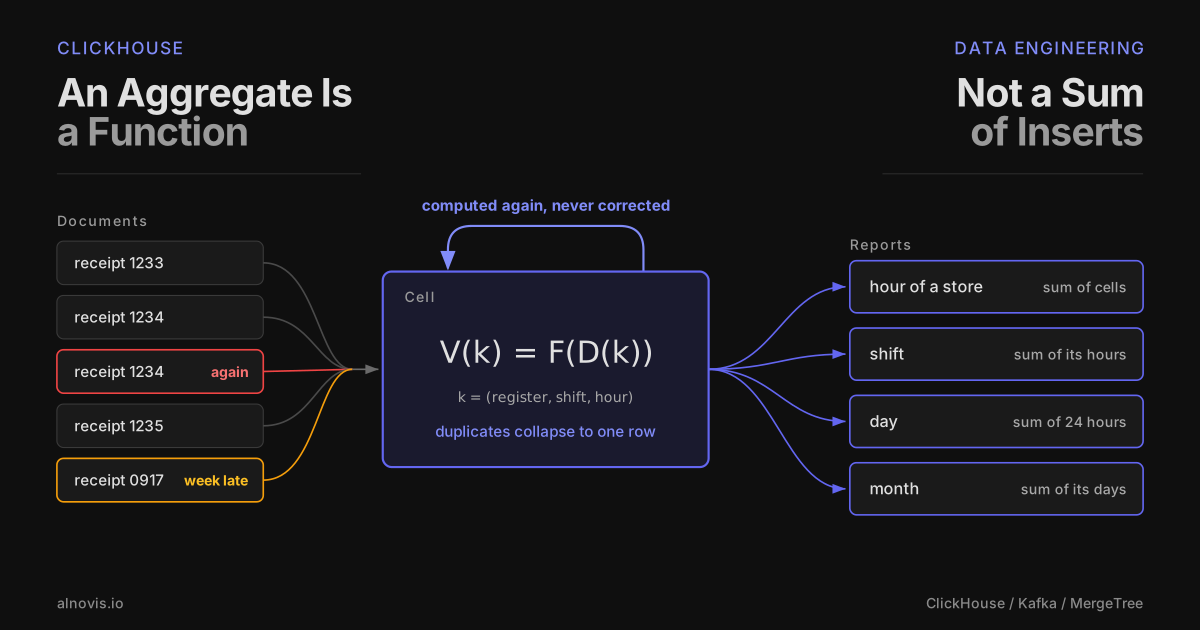
판매 시점 데이터를 다루는 시스템에서 '리포트 집계'는 흔해 보이는 작업이다. 행을 넣고, GROUP BY로 더하면 끝날 것 같다. 그러나 alnovis.io가 공개한 사례는 이 평범한 문제를 ClickHouse 위에서 안정적으로 풀기까지 네 번의 설계 교체가 필요했다고 전한다. 이 시스템은 모든 금전등록기에서 올라온 영수증을 Kafka로 받아 ClickHouse에 문서(document) 형태로 저장하고, 그 위에 교대조별·시간별·일별 매출, 가맹점이 영수증에 붙인 커스텀 필드별 매출 같은 리포트를 얹는다. 문제를 어렵게 만든 것은 데이터 양이 아니라 스트림의 성질이었다. 영수증은 중복 재전송될 수 있고, 지각 도착할 수 있으며, 리포트에는 수 초(대화형)에서 30초(수백 대 등록기 집계) 이내라는 지연 예산이 걸려 있었다.
네 번의 실패가 알려준 것
첫 버전은 교과서적인 방식이었다. 삽입 시점에 머티리얼라이즈드 뷰로 부분합을 SummingMergeTree에 쌓고, 백그라운드 머지가 행을 접어 미리 합산된 값을 읽는다. 빠르지만 재전송된 영수증이 합을 한 번 더 더해버리고, 두 숫자가 더해진 뒤에는 그중 어느 하나만 다시 빼낼 방법이 없다. 집계가 '어떤 문서가 기여했는지'를 기록하지 않기 때문이다. 두 번째 버전은 주기적으로 최근 교대조·시간대의 합계를 문서에서 다시 계산해 중복을 문서 키로 접었다. 정확했지만, 레지스터와 문서 키로 정렬된 넓은 문서 테이블을 날짜로 필터링해야 했다. ClickHouse에서 날짜로 정렬되지 않은 테이블의 날짜 필터는 파티션은 잘라도 그래뉼은 잘라내지 못한다. 한 번의 패스가 50만 8천 행을 쓰려고 4,600만 행을 읽었고, 결국 쿼리 메모리 한도에 걸려 반복 실패했다.
세 번째는 삽입 시점 합산으로 돌아가되 중복을 원천 차단하려 했다. 키 조회를 ClickHouse 딕셔너리로 구현해 이미 본 키인지 확인하는 방식이다. 그러나 딕셔너리는 메모리에 상주하고 키 하나가 테스트 클러스터에서 161바이트였다. 한 달치 전체 레지스터 키는 프로덕션에 올라가지 못했고, 딕셔너리 로드가 실패하자 모든 삽입이 실패하면서 중복 제거 장치 자체가 중복을 만들어냈다. 네 번째는 저장된 집계를 포기하고 읽기 시점에 문서에서 전부 계산해 GROUP BY로 중복을 접었다. 동기화가 깨질 상태가 없으니 정확했지만, 600개 교대조 리포트가 약 35억 행을 읽어 어떤 튜닝으로도 고칠 수 없이 느렸다.
ClickHouse는 행 수가 아니라 배치를 읽는다
세 번의 프로덕션 실패 중 어느 것도 '집계를 저장한 것' 자체가 원인이 아니었다는 점이 핵심이다. MergeTree 테이블은 파트로, 파트는 기본 8,192행짜리 그래뉼로 나뉜다. 기본 인덱스는 성겨서 그래뉼의 첫 키만 저장한다. 쿼리가 읽는 양은 '필요한 행 수'보다 '행이 어떻게 배치됐는가'에 훨씬 크게 좌우된다. 원하는 행이 테이블 곳곳에 흩어져 있으면 그 주변 그래뉼을 통째로 읽어야 한다. 읽기 시점 계산 버전에서 좁은 소매 테이블이 시간 우선으로 정렬돼 있었고, 한 시간 안에 수천 대 등록기의 영수증이 뒤섞여 있어 150개 등록기 리포트가 한 달치 거의 모든 그래뉼을 건드렸다. '읽은 행 수' 상한이라는 자체 합격 기준조차 지킬 수 없었는데, 경계 그래뉼에는 늘 남의 행이 섞여 있기 때문이다.
유지한 설계: 셀은 문서의 함수다
그래서 질문이 바뀌었다. 집계를 저장하면서도, 키를 기억하지 않고 중복을 견디고, 문서 테이블 전체를 읽지 않고 재계산할 수 있는가. 유지한 설계에서 집계는 삽입된 값의 누적 합이 아니라 문서들의 함수다. 가장 작은 집계 단위인 '셀'을 두되, 문서와 셀의 연결은 어디에도 저장하지 않고 문서의 세 컬럼에서 계산한다. 셀 값은 문서가 그대로 남아 있고 규칙이 같으므로 언제든 다시 계산할 수 있으며, 재계산은 ReplacingMergeTree에서 재계산 시각으로 버전이 매겨진 새 행으로 쓰여 옛 행을 밀어낸다. 모든 측정값은 합·카운트·최소·최대이고 모든 문서가 정확히 한 셀에 속하므로, 어떤 셀 집합에 대한 리포트든 중복 없이 값들의 결합으로 얻어진다. 새 리포트는 새 테이블이 아니라 같은 셀에 대한 새 쿼리일 뿐이다. 시·일·교대조를 셀에서 조립한 결과가 209개 측정값 모두에서 문서 직접 계산과 일치함을 확인했다고 한다.
실무로 옮긴 ClickHouse 역학
설계의 성패는 대부분 ClickHouse 세부에 달려 있었다. 재계산은 넓은 문서 테이블을 절대 읽지 않는다. 머티리얼라이즈드 뷰가 측정값에 필요한 컬럼만 담은 좁은 테이블로 복사하되 (레지스터, 문서번호) 순으로 정렬한다. 레지스터는 발행 순서대로 문서 번호를 매기므로 한 레지스터·한 시간의 문서가 모든 파트에서 붙어 앉고, 셀 조회는 짧은 범위 스캔이 된다. 가장 밀집한 셀(5천여 문서)도 20그래뉼을 읽어 7ms에 끝났고, 넓은 테이블 대비 30~37배 적게 읽었다. 또 다른 뷰는 같은 삽입에서 '이 셀은 재계산이 필요하다'는 더티 마크만 쓴다. 다만 이것은 트랜잭션이 아니다. 소스 테이블과 뷰가 차례로 쓰이기에, 문서가 저장된 뒤 뷰가 실패하면 오류가 나고 컨슈머가 배치를 재시도한다. 복제 테이블의 삽입 중복 제거가 이 재시도와 어떻게 맞물리는지는 아직 검증하지 못했다는 한계도 저자는 솔직히 적어둔다.
진행 상황 추적에서는 '처리 커서'를 두지 않고 데이터 자체에서 두 시각을 비교한다. 커서는 쓰기와 원자적으로 이동해야 하고 재시도·병렬·재시작에 취약하지만, 시각 비교는 그런 영향을 받지 않아 하루짜리 장애 뒤에도 다음 패스가 마크 이후 셀을 모두 찾아낸다. 60초 중첩은 삽입 일부가 조금씩 다른 시점에 보이는 현상을 흡수하고, 대가는 가끔의 추가 재계산이다. 셀 버전을 '문서 최신 쓰기 시각'이 아니라 '재계산 쿼리 시작 시각'으로 둔 것도 중요하다. 나중 스냅샷은 같은 노드에서 늘 최소한 같은 수의 문서를 보므로 항상 올바른 버전이 된다. 단 이 '최소한 같다'는 성질은 노드 간에는 성립하지 않으며, 이것이 설계 전체에서 가장 약한 지점이라고 저자는 명시한다.
한국 실무자에게 남는 교훈
이 패턴은 영수증에 국한되지 않는다. 모든 이벤트가 자기 셀 키를 계산할 재료를 품고 있고, 재전송돼도 그 키가 변하지 않으며, 측정값이 더해지거나 최소한 병합 가능하다면, 집계는 누적 합이 아니라 이벤트의 함수가 될 수 있다. 결국 교훈은 두 갈래다. 하나는 '중복과 지각을 견디려면 집계가 어떤 문서에서 나왔는지 다시 계산 가능해야 한다'는 모델링 원칙이고, 다른 하나는 'ClickHouse에서 비용은 읽을 행 수가 아니라 행의 물리적 배치가 결정한다'는 운영 현실이다. 데이터를 조회 단위에 맞춰 정렬해 한 단위를 몇 그래뉼로 줄이는 것, 넓은 테이블 대신 측정값 컬럼만 담은 좁은 테이블을 따로 두는 것, argMax를 컬럼마다 쌓는 대신 튜플 하나로 묶는 것 같은 선택이 그 배치를 만든다. 저자의 테스트 클러스터가 6코어 한 대 수준으로 작다는 점, 복제 환경에서의 버전 단조성과 삽입 중복 제거 상호작용이 미검증이라는 점은 그대로 받아들일 때의 한계로 염두에 둘 만하다.