"지구상 모든 사람에게 웹서버 한 대씩"이라는 농담 같은 목표에서 출발한 실험이 있다. 10GB 램과 1개의 CPU 코어만 가진 VM 한 대에서 웹서버 1500만 개를 돌려보겠다는 것이다. 발상 자체는 과장된 유머지만, 이 과정을 따라가다 보면 평소 라이브러리 뒤에 가려져 있던 운영체제·네트워크 스택의 비용 구조가 적나라하게 드러난다. 실무자에게 이 글이 읽을 가치가 있는 이유도 거기에 있다.
먼저 부딪히는 벽: 포트와 메모리
출발점은 단순하다. C로 소켓을 열고(listen), 연결을 받고(accept), 데이터를 읽어 "OK"를 돌려주고 닫는 루프다. 다섯 개 남짓한 시스템콜만으로 초당 약 6만 5천 요청(RPS)이 나온다. 그러나 서버 수를 늘리자마자 두 가지 한계가 드러난다. 첫째는 포트다. 포트 번호는 16비트(u16)라 최대 6만 5천 개뿐이고, 이는 TCP 표준에서 비롯된 제약이라 커널 소스를 수정해도 일반 클라이언트가 접속하지 못한다. 서버가 (프로토콜, IP, 포트) 튜플로 식별된다는 점을 역이용하면 길이 보인다. TCP와 UDP가 같은 포트를 쓸 수 있고, 서로 다른 IP를 여러 개 확보하면 주소 공간이 늘어난다.
여기서 등장하는 기법이 AnyIP다. 많은 VPS·전용서버 사업자가 IPv6 서브넷 하나를 통째로 내주는데, 로컬 라우팅에 /64 서브넷을 등록하면 사실상 무한에 가까운 주소로 수신할 수 있다. IPv4로 같은 일을 하려면 1500만 개 주소를 가진 서브넷 구매에 약 2억 5천만 달러가 든다는 점이 대비되며, 왜 IPv6가 현실적 해법인지 보여준다.
진짜 병목은 커널이 쥐고 있는 메모리
주소 문제를 풀어도 메모리가 남는다. 프로세스 하나당 약 1.5MB를 쓰면 1500만 개는 20TB가 필요해 10GB 예산을 한참 넘는다. 해법은 수백만 개의 프로세스 대신, 하나의 프로세스 안에서 모든 게스트를 돌리는 전용 런타임이다. V8이 한 프로세스에서 수많은 게스트를 실행하듯, LFI 기반 샌드박싱으로 메모리를 격리하고 모든 시스템콜을 호스트 핸들러 호출로 치환한 뒤, 자체 유저랜드 스케줄러로 게스트를 전환한다. 루프 안에서 보존해야 할 상태가 서버·클라이언트 파일 디스크립터 두 개뿐이라, 게스트당 16바이트, 비트 패킹을 쓰면 8바이트까지 줄일 수 있다는 계산이 나온다.
그런데도 벽이 또 있다. 처음에 "시스템콜 다섯 개"라고 했지만 socket 호출 자체가 간과됐다. 소켓은 활성·수신 대기·유휴 상태와 무관하게 약 3300바이트를 할당하기 때문에, 이 구조만으로도 10GB VM은 OOM에 빠진다. 커널의 메모리 소비는 램이 넉넉하던 시절의 설계가 그대로 남아 있는 결과다.
커널을 비켜 가는 세 갈래 길
문제를 풀 수 없다면 추상화 계층이 잘못된 것이라는 공학적 직관이 OSI 모델로 이어진다. HTTP(응용)에서 TCP/IP(전송)로 내려왔다면, 그 아래 네트워크·데이터링크 계층으로 더 내려가 제어권을 쥐면 된다. TCP/IP는 상태를 가지지만 하위 계층은 무상태라 직접 IP 패킷이나 이더넷 프레임을 만들어 보내도 막는 것이 없다. 관건은 TCP/IP 스택을 직접 구현하는 일인데, 임베디드 분야에는 이미 수많은 사례가 있다. 극단적으로는 애덤 둔켈스의 Miniweb이 TCP/IP와 HTTP 서버를 합쳐 28바이트로 동작한다. 여기서는 Rust로 작성된 smoltcp를 택한다.
다만 smoltcp는 영리한 파서일 뿐 입출력은 하지 않는다. 네트워크 카드와 통신하는 방식이 세 가지인데, 앞의 두 가지는 smoltcp가 기본 제공한다. 세 번째가 DPDK다. 지연 시간이 극도로 중요한 영역에서는 시스템콜 하나가 치명적이다. 시스템콜 자체가 약 500나노초, 커널에서 유저 공간으로의 복사가 버퍼 크기에 따라 1000나노초가량 들기 때문이다. 고빈도 트레이딩에서 400Gbps 회선을 포화시키면 초당 6억 패킷, 패킷당 약 1.7나노초를 처리해야 하는 세계임을 떠올리면 그 무게감이 체감된다. DPDK는 메모리 맵 버퍼로 하드웨어와 직접 주고받아 시스템콜을 없애고, 패킷 폭주 시 인터럽트가 CPU를 끝없이 가로채는 라이브락도 피한다. 대가는 분명하다. 전체 CPU 코어 하나를 점유하는 busy loop가 돌고, 드라이버가 장치를 독점하면서 그 장치가 OS에서 사라진다. SSH로 켰다면 그 세션마저 끊긴다.
그 대안이 AF_XDP다. 커널이 장치와 인터럽트를 계속 소유하되, 새 패킷이 올 때 간단한 eBPF 필터가 유저 공간 버퍼로 직행시킬지 평소대로 처리할지 결정한다. 덕분에 SSH가 살아 있고 관리가 쉽다. SO_PREFER_BUSY_POLL 모드를 쓰면 인터럽트 없는 busy loop로 DPDK에 근접하지만, 커널을 완전히 우회하는 DPDK가 여전히 앞선다. smoltcp에서 둘을 지원하려면 Device 트레이트의 세 메서드만 구현하거나, rust-dpdk-net·xsk-rs 같은 기존 크레이트를 쓰면 된다.
결과와 현실적 함의
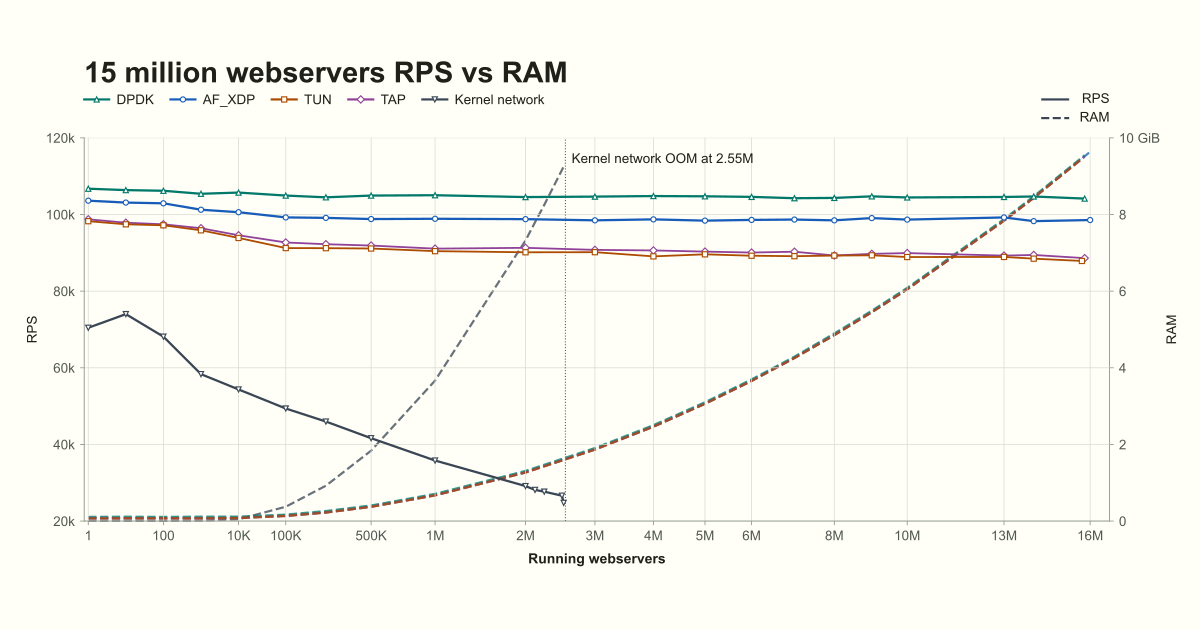
벤치마크는 메시지가 분명하다. 커널 기본 스택은 약 250만 서버 지점에서 램을 모두 소진하고 RPS도 떨어진다. 반면 smoltcp는 유휴 서버당 620바이트, 활성 서버당 1킬로바이트 수준으로 메모리 증가가 완만해 1600만 서버까지 도달한다. DPDK가 가장 강력하고 AF_XDP가 바로 뒤를 잇는다. 핵심은 1500만이라는 숫자 자체가 아니다. 네트워크 스택을 유저랜드로 옮기면 메모리 사용을 직접 통제하고 성능을 끌어올릴 수 있으며, 전용 런타임과 결합하면 게스트 실행을 더 빠르게 만들 수 있다는 점이다. 물론 이는 범용 서버가 아니라 극한 밀집도를 노린 특수 설계이며, 커널 우회에는 장치 독점·운영 복잡성이라는 뚜렷한 비용이 따른다. 그럼에도 "풀리지 않으면 추상화 계층을 바꿔라"는 교훈과, 평소 당연하게 여기던 시스템콜·소켓 할당의 실제 단가를 되짚게 한다는 점에서 충분히 들여다볼 만한 실험이다.