들어가며: '그 모델, 우리 장비로는 못 돌려요'의 시대가 흔들리고 있어요
요즘 나오는 오픈 웨이트 모델들, 스펙 보면 좀 아찔하죠. GLM-5.2가 7,440억 파라미터, Kimi K3는 무려 2.8조 파라미터예요. 이런 모델을 돌리려면 보통 H100 같은 고가 GPU를 여러 장 묶은 서버가 필요하다고 알려져 있었거든요. 그래서 '오픈 모델이면 뭐해, 어차피 못 돌리는데'라는 자조가 개발자들 사이에 꽤 퍼져 있었어요.
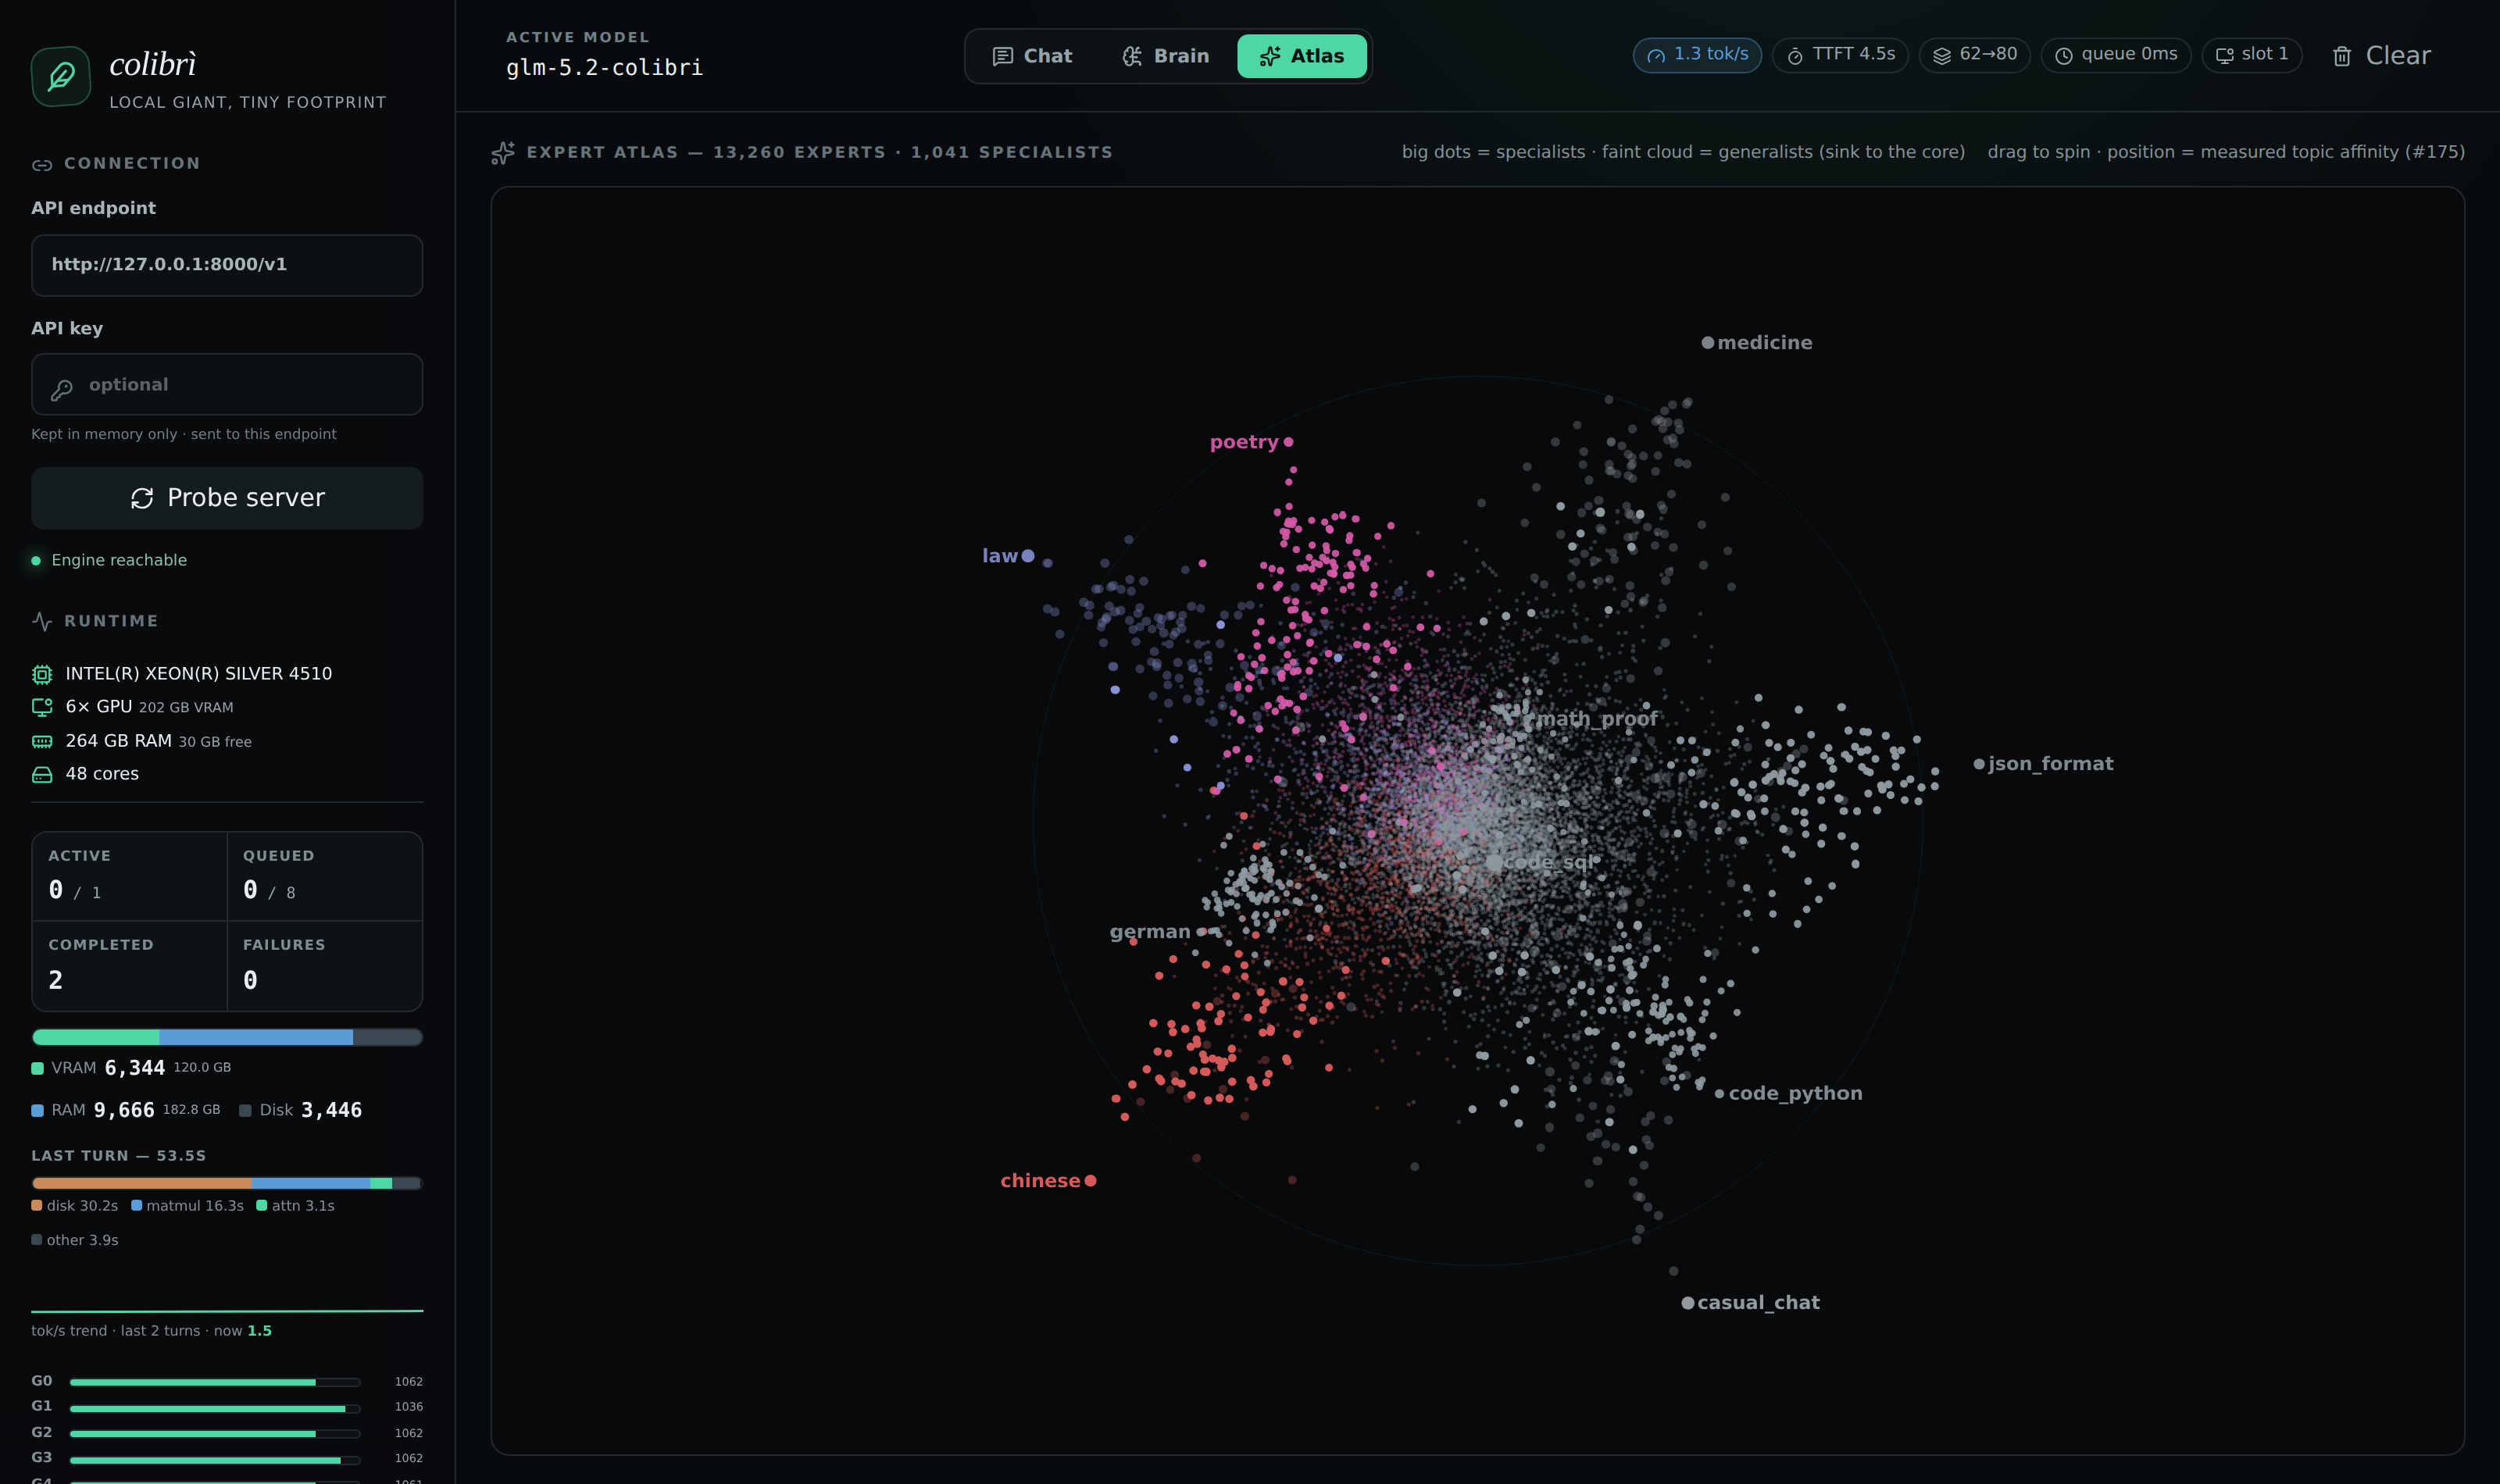
그런데 Colibrì(콜리브리, 이탈리아어로 벌새라는 뜻이에요)라는 프로젝트가 이 전제를 정면으로 흔들고 있어요. 주장은 단순해요. '당신이 이미 가진 하드웨어로 프론티어급 MoE 모델을 돌릴 수 있다.' 순수 C로 작성됐고, 외부 의존성이 하나도 없고, 모델의 무거운 부분은 디스크에서 그때그때 읽어온다는 거예요.
README에 실린 실행 예시가 인상적인데요. 7,440억 파라미터 GLM-5.2를 int4로 양자화해서 CPU 스트리밍 모드로 띄웠더니 32초 만에 준비 완료, 메모리 상주량은 9.9GB였다고 해요. 물론 속도에 대한 보장은 없다는 걸 프로젝트 스스로 명시하고 있지만, 이게 어떤 원리로 가능한 건지, 그리고 우리한테 어떤 의미인지 차근차근 풀어볼게요.
기술 분석: MoE라는 구조가 만들어준 틈새
먼저 MoE가 뭔지부터
MoE는 Mixture of Experts, 우리말로 '전문가 혼합'이에요. 이게 뭐냐면, 하나의 거대한 신경망이 모든 계산을 다 하는 게 아니라, 여러 개의 작은 '전문가' 네트워크로 쪼개놓고 입력 토큰마다 그중 몇 개만 골라서 쓰는 구조예요.
비유하자면 이래요. 큰 종합병원에 의사가 100명 있다고 해볼게요. 환자 한 명이 오면 100명이 다 진료하는 게 아니라, 접수처(이걸 라우터라고 불러요)에서 '이 분은 정형외과랑 재활의학과만 가시면 돼요' 하고 2~3명한테만 보내는 거죠. 병원 전체 규모는 엄청나지만, 환자 한 명당 실제로 일하는 의사는 소수예요.
Qwen3.6이 '35B-A3B'라고 표기되는 게 바로 이 뜻이에요. 전체 파라미터는 350억인데, 토큰 하나를 처리할 때 실제로 활성화되는(Active) 파라미터는 30억뿐이라는 거죠. 7,440억짜리 GLM-5.2도 마찬가지로, 매 토큰마다 실제로 쓰이는 전문가는 전체의 극히 일부예요.
그럼 안 쓰는 전문가는 어디에 두면 될까?
여기서 Colibrì의 핵심 아이디어가 나와요. 기존 추론 엔진들은 '모델 전체를 VRAM(GPU 메모리)에 올려야 한다'는 전제로 설계됐어요. 그러니까 744B 모델이면 int4 양자화를 해도 370GB 정도가 필요하고, 이건 소비자용 하드웨어로는 꿈도 못 꾸는 크기죠.
Colibrì는 이렇게 생각해요. '어차피 토큰 하나 처리할 때 전문가 몇 개만 쓰는데, 나머지를 왜 비싼 VRAM에 올려놓고 있어야 해?' 그래서 VRAM, RAM, 그리고 SSD 같은 스토리지를 하나의 계층적 메모리로 취급해요. 프로젝트에서는 이걸 'AI 메모리 멀티티어링'이라고 부르는데요.
컴퓨터 구조 수업 들으신 분이라면 CPU 캐시 계층이 떠오를 거예요. L1 캐시는 아주 빠르지만 작고, L2, L3로 갈수록 느리지만 커지고, 그 뒤에 RAM이 있잖아요. 자주 쓰는 데이터는 위쪽 빠른 층에, 가끔 쓰는 데이터는 아래쪽 큰 층에 두는 식이죠. Colibrì는 이 개념을 모델 가중치에 그대로 적용한 거예요.
- VRAM: 항상 쓰이는 어텐션 레이어, 라우터, 그리고 자주 호출되는 전문가
- RAM: 그 다음으로 자주 쓰이는 전문가들
- 스토리지(SSD): 나머지 전문가 전부. 필요할 때 스트리밍으로 읽어옴
- SSD: PCIe 4.0 이상 NVMe가 사실상 필수예요. SATA SSD면 실용성이 크게 떨어질 거예요.
- RAM: 많을수록 좋아요. RAM이 크면 캐시되는 전문가가 많아져서 디스크 접근이 줄어요.
- 디스크 용량: 돌리려는 모델의 양자화된 크기를 먼저 확인하세요. 744B int4면 약 370GB예요.
- GPU: 있으면 좋지만 필수는 아니에요. 저장소의 GPU_BACKENDS.md 문서에서 지원 백엔드를 확인하세요.
이렇게 하면 '상주 메모리 9.9GB'가 어떻게 나오는지 이해가 돼요. 744B 모델 전체가 메모리에 있는 게 아니라, 진짜 필요한 뼈대와 캐시된 일부 전문가만 올라가 있고, 나머지는 디스크에서 그때그때 가져오는 거죠.
순수 C, 의존성 제로라는 선택
이 프로젝트는 순수 C로 작성됐고 엔진 자체에는 외부 라이브러리 의존성이 없어요. 그리고 재미있는 게, 지원하는 모델 패밀리마다 C 파일 하나씩이라는 점이에요. GLM용 파일 하나, DeepSeek용 파일 하나, 이런 식으로요.
이게 왜 중요하냐면요. 파이썬 기반 추론 스택을 써보신 분은 아실 텐데, PyTorch 버전, CUDA 버전, transformers 버전이 서로 안 맞아서 환경 세팅에만 반나절 날리는 일이 흔하잖아요. Colibrì는 make 한 번 치면 빌드되는 구조를 지향하고 있어요. Nix flake 파일도 들어있어서 재현 가능한 빌드 환경까지 챙기고 있고요.
'모델당 C 파일 하나'라는 설계는 llama.cpp 계열과는 좀 다른 철학이에요. 범용 그래프 실행기를 만들어서 모든 모델을 태우는 대신, 모델 하나하나에 최적화된 코드를 따로 쓰는 거죠. 유지보수 비용은 올라가지만, 각 모델의 특성(전문가 개수, 라우팅 방식, n-gram 헤드 같은 특이 구조)에 딱 맞는 최적화가 가능해져요.
'속도는 보장 안 하지만, 의미는 절대 안 바꾼다'
README에서 제가 가장 눈여겨본 대목이 이거예요. 프로젝트는 스스로를 '공격적인 시스템 아이디어를 실험하는 연구 플랫폼'이라고 정의하면서 두 가지 원칙을 밝혀요.
1. 속도에 대한 SLA는 없다. 빠른 메모리가 부족하면 느려질 수 있다.
2. 의미론에 대한 보장은 절대적이다. 기본 정책은 모델의 정밀도나 라우터의 동작을 몰래 바꾸지 않는다.
이게 뭐냐면, '메모리가 모자라니까 전문가를 4개 쓸 걸 2개만 쓸게요' 같은 꼼수를 안 쓴다는 뜻이에요. 그런 식으로 하면 속도는 빨라지겠지만, 그건 더 이상 원래 모델이 아니거든요. 느려지더라도 원래 모델이 내놓을 답을 그대로 내놓는다, 이게 원칙이에요.
연구 플랫폼으로서는 모델 포맷, 메모리 계층, 스토리지 I/O, 전문가 배치, 스케줄링, 커널, 추측 디코딩(speculation), CPU/GPU 오버랩까지 추론 성능에 영향을 주는 모든 층을 실험 대상으로 삼고 있어요. 그리고 실험은 '재현 가능한 end-to-end 측정으로 자기 자리를 증명해야 한다'고 못박고 있어요.
지원 모델 로스터
현재 아홉 개 패밀리를 지원해요.
| 모델 | 전체 파라미터 | 특징 |
|---|---|---|
| GLM-5.2 / 5.3 | 744B | 텍스트 |
| GLM-5.3-Flash | 321B | 비전 지원 |
| Inkling | 975B | 텍스트 |
| Kimi K3 | 2.8T | 현재 최대 |
| DeepSeek V4 Flash | 284B | 텍스트 |
| DeepSeek V4.1 Flash | 552B | 비전 지원 |
| Qwen3.8-Flash-Next | 125B + 51B n-gram | n-gram 헤드 포함 |
| Qwen3.6 | 35B-A3B | 소형 MoE |
| OLMoE | 7B | 입문용 |
프론트엔드는 전부 동일해요. 터미널 채팅은 coli chat, API 서버는 coli serve, 웹 대시보드는 coli web. 모델이 뭐든 같은 명령어로 쓸 수 있어요.
업계 맥락: llama.cpp, vLLM, 그리고 Colibrì
llama.cpp와의 관계
'CPU에서 큰 모델 돌리기'라고 하면 대부분 llama.cpp를 떠올리실 거예요. llama.cpp도 mmap을 통해 모델을 메모리에 다 안 올리고 쓰는 게 가능하고, 일부 레이어를 GPU에 오프로드하는 기능도 있어요.
차이를 비유로 설명하면 이래요. llama.cpp는 '만능 공구함'이에요. 수백 가지 모델을 GGUF라는 공통 포맷으로 변환해서 하나의 실행기로 돌려요. 범용성이 최고고, 생태계도 압도적이에요. 반면 Colibrì는 '특정 모델을 위한 맞춤 정비소'예요. 처음부터 초거대 MoE 모델의 전문가 스트리밍을 목표로 설계됐고, 모델별로 코드를 따로 써요. 그래서 지원 모델 수는 적지만, 744B~2.8T급 모델을 소비자 하드웨어에서 돌린다는 한 가지 목표에는 훨씬 깊이 파고들 수 있어요.
llama.cpp의 mmap이 '운영체제한테 페이지 관리를 맡기는' 수동적 방식이라면, Colibrì는 어떤 전문가를 VRAM에, 어떤 걸 RAM에, 어떤 걸 디스크에 둘지를 엔진이 능동적으로 결정하고 스케줄링하는 방식이라고 이해하시면 돼요.
vLLM, SGLang과의 관계
vLLM이나 SGLang은 완전히 다른 리그예요. 이들은 GPU 클러스터에서 최대 처리량을 뽑아내는 게 목표예요. 수백 명이 동시에 요청을 보내는 서비스 환경을 위한 도구죠. 비유하자면 vLLM은 고속도로 요금소를 수십 개 만들어서 차를 최대한 많이 통과시키는 시스템이고, Colibrì는 '우리 동네 골목길로도 대형 트럭이 지나갈 수 있게 만드는' 프로젝트예요. 목표 자체가 달라요.
Colibrì의 한계
솔직하게 짚어야 할 부분이 있어요. 디스크에서 전문가를 스트리밍한다는 건, 결국 SSD 대역폭이 병목이 된다는 뜻이에요. NVMe SSD가 아무리 빨라도 VRAM보다는 수십 배 느리거든요. 그래서 토큰 생성 속도가 초당 몇 토큰 수준에 머물 가능성이 높아요. 프로젝트가 '속도 SLA 없음'을 명시하는 이유가 바로 이거예요.
또 '소비자 하드웨어'라는 말도 잘 봐야 해요. 2.8T 모델을 int4로 양자화해도 1.4TB가 넘어요. 이걸 디스크에 저장할 공간부터 있어야 하고, 빠른 NVMe SSD가 있어야 그나마 쓸 만한 속도가 나올 거예요. 라즈베리파이에서 돌린다는 얘기가 아니라, '고사양 워크스테이션이나 맥 스튜디오급 장비면 가능하다'는 얘기에 가까워요.
한국 개발자에게 주는 시사점
시나리오 1: 사내 데이터로 프론티어 모델 평가하기
금융, 의료, 공공 분야에서 일하시는 분들은 데이터를 외부 API로 못 보내는 경우가 많잖아요. 그런데 '우리 문서로 GLM-5.2나 DeepSeek V4.1이 얼마나 잘하는지 테스트해보고 싶다'는 요구는 계속 있고요. 이럴 때 H100 서버 견적부터 내는 대신, 팀에 있는 RAM 128GB 워크스테이션에 NVMe 4TB 붙여서 Colibrì로 돌려보는 게 현실적인 첫 단계가 될 수 있어요. 느려도 배치로 밤새 돌리면 평가 데이터셋 하나쯤은 처리할 수 있으니까요.
시나리오 2: 추론 시스템 공부하기
이 프로젝트의 진짜 가치는 어쩌면 '교재'로서일지도 몰라요. 순수 C로 작성돼 있고, 모델당 파일 하나니까, 특정 모델의 추론 과정 전체를 파일 하나에서 따라갈 수 있거든요. 어텐션 계산이 어떻게 되는지, 라우터가 전문가를 어떻게 고르는지, 양자화된 가중치를 어떻게 역양자화해서 곱하는지가 다 한곳에 있어요. OLMoE 7B용 파일부터 읽어보시면 MoE 추론의 뼈대를 익히기 좋을 거예요.
시나리오 3: 로컬 에이전트 백엔드
coli serve로 API 서버를 띄울 수 있으니까, 기존에 OpenAI 호환 API를 쓰던 에이전트 코드를 로컬 프론티어 모델로 붙여볼 수 있어요. 실시간 채팅에는 느리겠지만, 코드 리뷰나 문서 요약처럼 몇 분 기다려도 되는 작업이라면 충분히 실용적일 수 있어요.
도입 전 체크리스트
학습 로드맵
1. MoE 구조의 기본 개념 익히기 (Switch Transformer, Mixtral 논문의 개요 정도면 충분해요)
2. llama.cpp로 GGUF 모델 한 번 돌려보면서 양자화와 오프로딩 감 잡기
3. Colibrì로 OLMoE 7B 띄워보고, 해당 C 파일 읽어보기
4. RAM 용량을 바꿔가면서 상주 메모리와 속도 변화 직접 측정해보기
5. 관심 있으면 CONTRIBUTING.md 읽고 벤치마크 재현으로 기여해보기
마무리
Colibrì가 던지는 메시지는 '하드웨어 부족은 소프트웨어로 상당 부분 우회할 수 있다'는 거예요. GPU가 귀하고 비싼 상황이 당분간 계속될 텐데, 스토리지-RAM-VRAM을 하나의 계층으로 보는 접근은 앞으로 다른 엔진들에도 영향을 줄 가능성이 커요. 'MoE 전문가 오프로딩'은 이미 여러 연구에서 다루던 주제인데, 이걸 프론티어급 모델에서 실제로 동작하는 코드로 보여줬다는 점이 의미 있어요.
동시에 한계도 분명해요. 속도는 보장이 안 되고, 초거대 모델은 디스크 공간부터 만만치 않아요. 하지만 '아예 못 돌린다'와 '느리지만 돌아간다' 사이의 간극은 생각보다 커요. 후자가 되는 순간, 평가도 해보고, 프롬프트도 다듬어보고, 파인튜닝할 가치가 있는지 판단도 해볼 수 있으니까요.
여러분은 어떠세요? 지금 팀에서 '모델은 좋은데 장비가 없어서' 포기한 실험이 있으신가요? 아니면 이미 llama.cpp나 다른 도구로 오프로딩을 써보셨다면, 실제 속도가 어느 정도였는지 경험을 공유해주시면 다른 분들께 큰 도움이 될 것 같아요.
🔗 출처: GitHub