무슨 프로젝트인가요
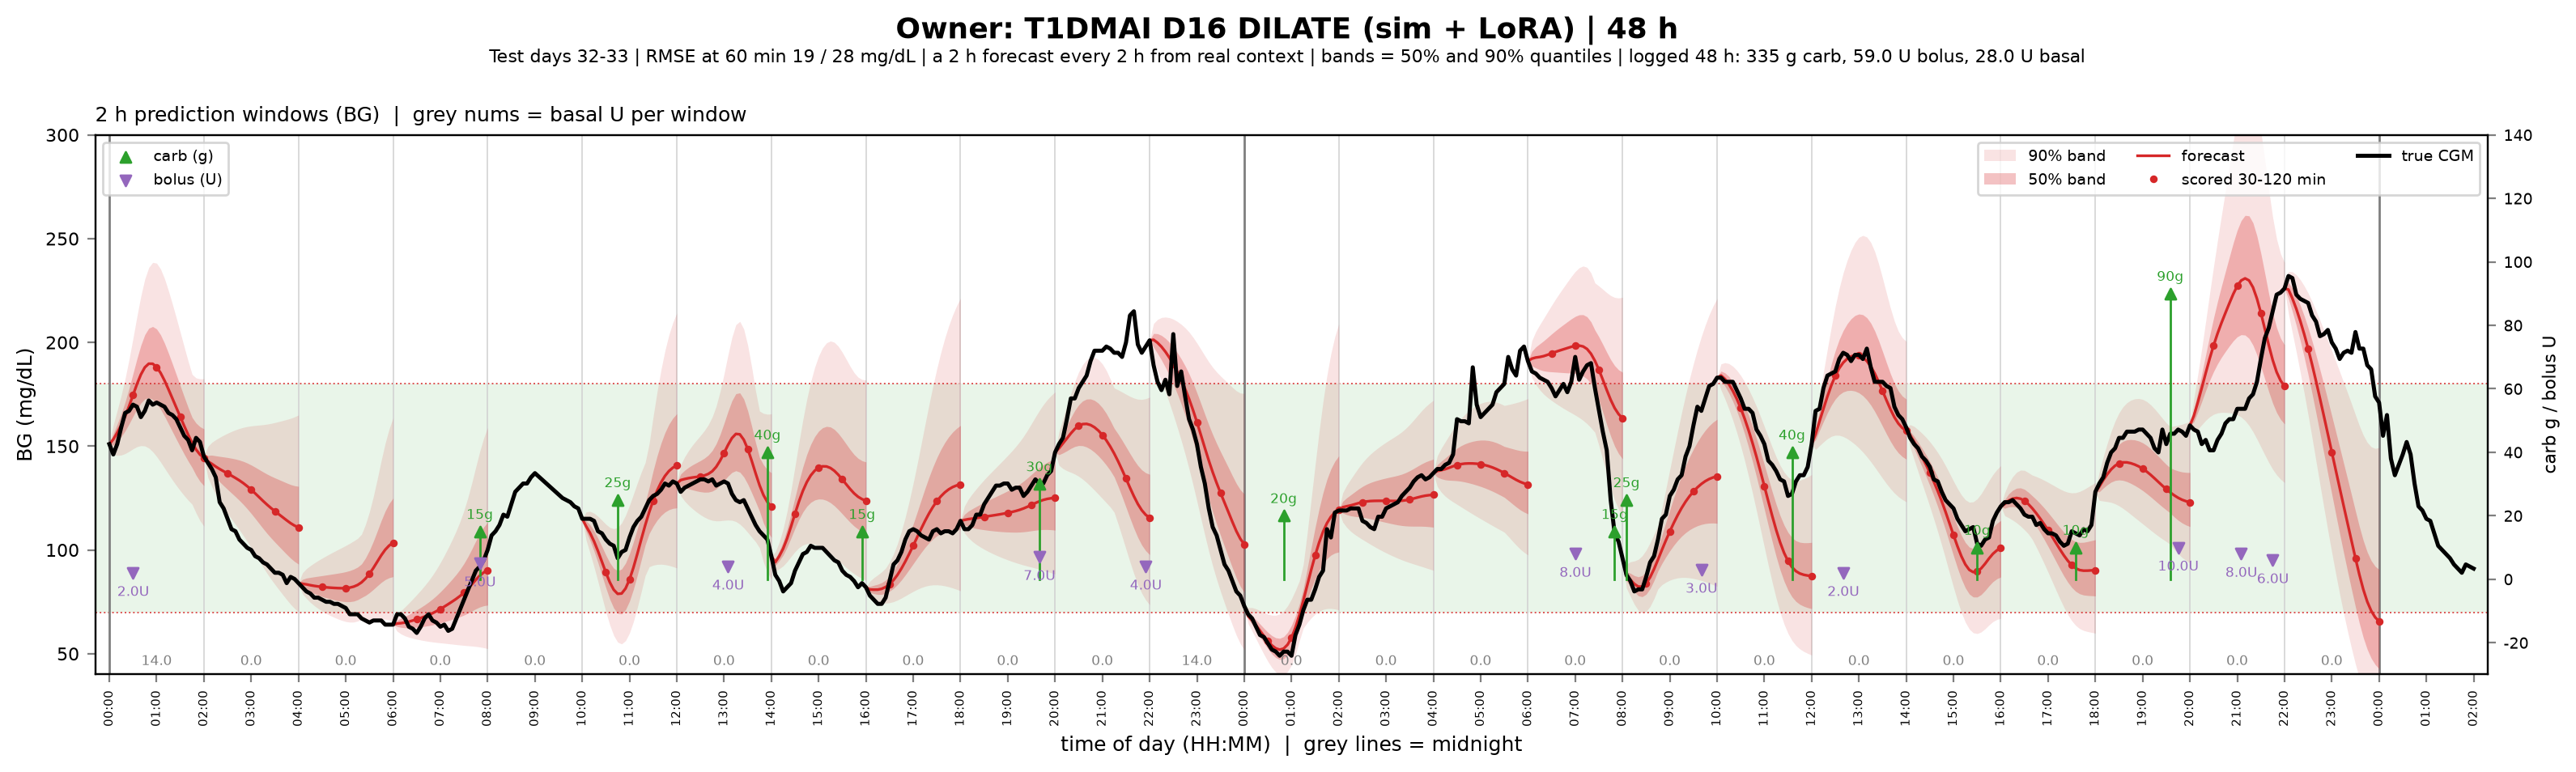
자기 자신의 혈당 데이터로 혈당 예측 모델을 무려 15개나 학습시켜 비교해 본 개인 프로젝트가 깃허브에 공개됐어요. 저장소 이름은 T1DMAI인데요, T1DM은 'Type 1 Diabetes Mellitus', 그러니까 1형 당뇨병의 약자예요. 여기에 AI를 붙인 이름이죠.
1형 당뇨는 췌장이 인슐린을 거의 만들지 못해서 평생 인슐린을 직접 주입해야 하는 질환이에요. 문제는 인슐린을 '얼마나, 언제' 넣을지를 매번 스스로 판단해야 한다는 거예요. 너무 많이 넣으면 저혈당으로 쓰러질 수 있고, 적게 넣으면 고혈당이 이어지거든요. 그래서 “30분 뒤, 1시간 뒤 내 혈당이 어떻게 될까?”를 미리 아는 건 이분들에게 편의 기능이 아니라 안전장치에 가까워요.
혈당 예측, 이게 뭐냐면
요즘 1형 당뇨 환자분들은 연속혈당측정기(CGM)를 많이 써요. 이게 뭐냐면, 팔이나 배에 동전만 한 센서를 붙여두면 보통 1~5분마다 혈당 값을 자동으로 기록해 주는 기기예요. 5분 간격이라면 하루에 288개, 1년이면 10만 개가 넘는 데이터가 쌓이죠. 개발자 눈에는 이게 그대로 시계열 데이터로 보일 수밖에 없어요.
혈당 예측은 결국 '지난 몇 시간의 혈당 곡선과 인슐린·식사 기록을 보고, 앞으로 30~60분의 값을 맞히는 문제'예요. 서버 트래픽이나 수요 예측과 구조가 똑같아요. 다만 틀렸을 때의 대가가 다르죠. 그래서 이 분야에서는 평균 오차(RMSE) 말고도 클라크 오차 격자(Clarke Error Grid)라는 평가 방식을 함께 써요. 예측이 틀리더라도 '치료 결정에 위험한 방향으로 틀렸는지'를 구역별로 따져보는 방법이에요.
왜 15개나 돌렸을까
모델을 하나만 만들면 그게 잘하는 건지 알 수가 없거든요. 그래서 이런 실험은 보통 아주 단순한 기준선부터 차례로 쌓아 올려요. '조금 뒤의 혈당은 지금과 같다'고 찍는 지속성(persistence) 모델, ARIMA 같은 고전 통계 모델, XGBoost·LightGBM 같은 트리 기반 모델, 그리고 LSTM·GRU·TCN·트랜스포머 같은 딥러닝 모델 순서로요. 이번 저장소가 어떤 15개를 골랐고 각각 성적이 어땠는지는 저장소 문서에서 직접 확인해 보시는 걸 추천해요.
미리 알고 보면 좋은 교훈이 하나 있어요. 이 분야에서는 짧은 예측 구간일수록 단순한 모델이 생각보다 강하다는 사실이 반복해서 확인돼 왔어요. 혈당은 5분 사이에 급변하지 않으니까 '직전 값 그대로'만 찍어도 꽤 맞거든요. 복잡한 모델의 진짜 실력은 60분 이상 먼 미래나, 식사·운동 직후처럼 곡선이 꺾이는 구간에서 드러나요. 참고로 연구용 벤치마크인 OhioT1DM 데이터셋에서 연구들이 보고하는 오차는 30분 예측이 대략 20mg/dL 안팎, 60분 예측이 30mg/dL대예요. 이 숫자를 기억해 두면 개인 프로젝트의 결과를 볼 때 감을 잡기 좋아요.
남의 데이터가 아니라 '내 데이터'라는 점
의료 ML은 보통 여러 환자의 데이터를 모아 누구에게나 통하는 모델을 만들려고 해요. 그런데 혈당 반응은 사람마다 정말 달라요. 같은 밥 한 공기를 먹어도 오르는 폭이 다르고, 인슐린이 듣는 속도도 다르거든요. 그래서 한 사람의 데이터로 그 사람만을 위한 모델을 만드는 n-of-1 접근이 꽤 설득력이 있어요.
대신 함정도 있어요. 시계열은 데이터를 무작위로 섞어서 학습용과 검증용으로 나누면 안 돼요. 바로 옆 시점의 값이 양쪽에 다 들어가서 성능이 부풀려지는 데이터 누수가 생기거든요. 반드시 시간 순서대로 잘라서 과거로 학습하고 미래로 검증해야 해요. 센서 교체 직후의 불안정한 값이나, 잘 때 센서가 눌려서 생기는 가짜 저혈당 같은 노이즈도 걸러줘야 하고요. 이런 프로젝트를 볼 때는 모델 종류보다 검증 설계를 먼저 살펴보는 게 좋아요.
업계에서는 어디쯤일까
사실 환자 커뮤니티는 이 문제를 오래전부터 직접 풀어왔어요. '#WeAreNotWaiting(우리는 기다리지 않는다)'라는 구호 아래 Nightscout(혈당 데이터를 내 서버로 모으는 오픈소스), OpenAPS·Loop·AndroidAPS(인슐린 펌프를 자동으로 조절하는 오픈소스 시스템) 같은 프로젝트가 나왔죠. 다만 이쪽의 주력은 딥러닝이 아니라, 인슐린과 탄수화물이 몸에 흡수되는 곡선을 수식으로 계산하는 생리학 모델이에요. 예측이 엇나가도 이유를 추적할 수 있어서예요.
상용 제품도 비슷해요. 덱스콤 CGM의 저혈당 임박 알림이나 메드트로닉·탠덤의 자동 인슐린 조절 펌프는 모두 예측을 쓰지만, 규제 승인을 받은 보수적인 알고리즘이에요. 개인이 학습시킨 모델은 그 사이에서 '내 패턴을 더 잘 아는 보조 지표' 자리를 노리는 셈이고요.
한국 개발자에게 주는 시사점
한국도 1형 당뇨 환자의 CGM에 건강보험 지원이 적용되고 있고, 아이센스의 '케어센스 에어' 같은 국산 CGM과 카카오헬스케어의 '파스타' 같은 혈당 관리 앱이 나오면서 개인 혈당 데이터가 빠르게 쌓이고 있어요.
실무 관점에서는 두 가지를 챙겨갈 만해요. 하나는 시계열 ML 연습 주제로 아주 좋다는 거예요. 기준선 세우기, 시간순 검증, 예측 구간별 평가 같은 기본기를 한 번에 익힐 수 있고, 연구용 데이터셋(OhioT1DM)이나 오픈소스 시뮬레이터(simglucose)로 본인 데이터 없이도 시작할 수 있어요. 다른 하나는 선을 지키는 감각이에요. 예측값으로 인슐린 용량을 정하기 시작하면 그건 의료기기 소프트웨어의 영역이고, 한국에서는 식약처 허가 대상이에요. 나 혼자 하는 실험과 남에게 배포하는 서비스는 완전히 다른 이야기라는 걸 꼭 기억해야 해요.
마무리
한 줄로 정리하면, 가장 절실한 사용자가 직접 해본 모델 비교 실험이에요. 화려한 모델 이름보다 '기준선보다 얼마나 나아졌나'를 정직하게 따져보는 태도가 핵심이고요.
여러분은 스마트워치나 수면 기록처럼 내 몸에서 나온 데이터로 모델을 만들어 본 적 있으세요? 만든다면 그 예측을 어디까지 믿고 행동하실 건가요?
🔗 출처: Hacker News