무슨 일이 있었나요
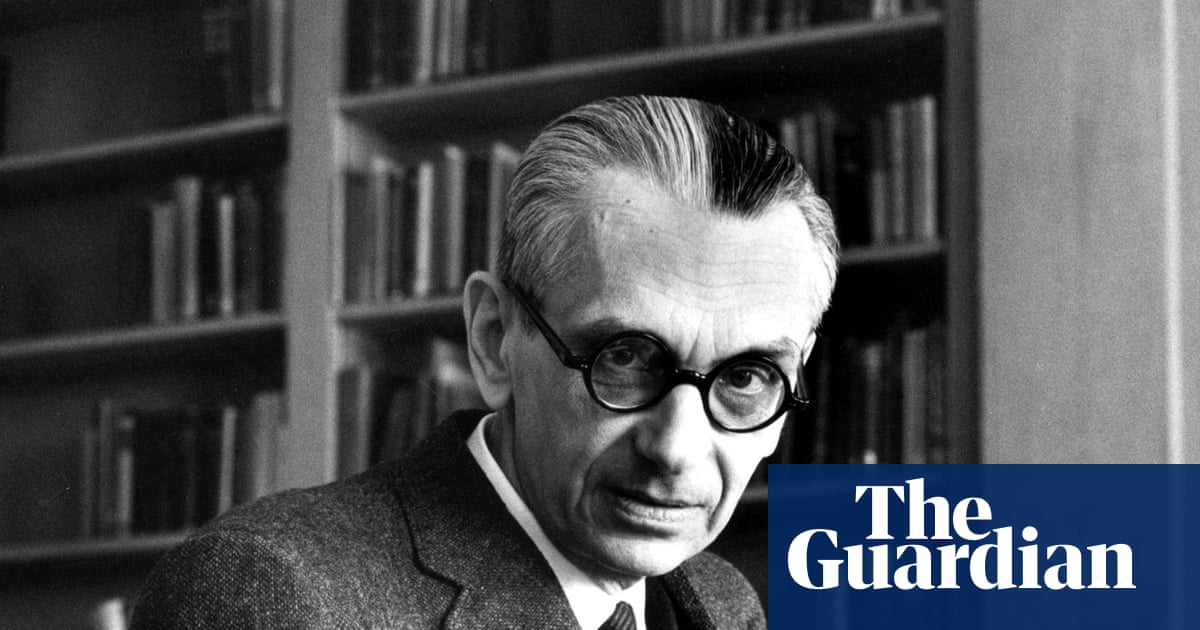
20세기 최고의 논리학자로 꼽히는 쿠르트 괴델, 이름은 한 번쯤 들어보셨을 거예요. 그 괴델이 남긴 노트가 AI의 도움으로 읽히기 시작했다는 소식이 영국 가디언을 통해 전해졌어요. 더 놀라운 건 그 안에 증명까지 끝낸 정리가 수백 개 담겨 있다고 알려졌다는 점이에요.
'유명한 수학자 노트를 여태 아무도 안 읽었다고?' 싶으실 텐데요, 안 읽은 게 아니라 못 읽은 거예요. 괴델은 평생 노트를 가벨스베르거 속기라는, 지금은 거의 아무도 쓰지 않는 독일어 속기법으로 적었거든요. 글씨는 멀쩡히 남아 있는데 읽을 줄 아는 사람이 손에 꼽을 정도라, 수십 년 동안 사실상 잠겨 있었던 셈이에요.
괴델은 누구고, 왜 하필 속기였을까요
괴델은 1931년, 20대 중반의 나이에 불완전성 정리를 발표한 사람이에요. 이게 뭐냐면, '산술을 다룰 만큼 강력하고 모순이 없는 수학 체계에는, 참인데도 그 체계 안에서는 증명할 수 없는 명제가 반드시 있다'는 내용이에요. 개발자에게 익숙한 말로 바꾸면 튜링의 정지 문제(어떤 프로그램이 끝날지 미리 판별해주는 만능 프로그램은 만들 수 없다)와 사촌쯤 되는 결과예요.
그런데 괴델은 지독한 완벽주의자라 발표를 극도로 꺼렸어요. 생전에 낸 논문은 많지 않은데 노트는 수천 쪽을 남겼죠. 유명한 일화가 하나 있어요. 1956년 괴델이 폰 노이만에게 보낸 편지에는 오늘날 P 대 NP 문제라고 부르는 질문이 사실상 그대로 들어 있었는데, 이 편지가 널리 알려진 건 1980년대 후반이에요. 발표되지 않은 종이 속에 시대를 앞선 생각이 숨어 있던 전례가 이미 있는 거예요.
가벨스베르거 속기는 19세기 독일에서 만들어져 독일어권 학교에서 널리 가르치던 속기법이에요. 1920년대에 통일 속기법으로 대체되면서 빠르게 잊혔고요. 모음을 대부분 따로 적지 않고 자음 획의 위치나 굵기로 암시하는 데다, 쓰는 사람마다 자기만의 줄임말을 섞기 때문에 독일어 원어민도 읽지 못해요. 그래서 지금까지는 이 속기를 따로 익힌 극소수 연구자가 한 권씩 손으로 옮겨 적어 왔고, 그렇게 책으로 나온 분량은 전체에 비하면 일부에 불과해요.
AI는 이걸 어떻게 읽을까요
이런 작업에 쓰이는 기술을 보통 HTR(Handwritten Text Recognition, 손글씨 인식)이라고 불러요. 인쇄물을 읽는 OCR의 손글씨 버전이라고 생각하시면 돼요. 일반적인 흐름은 이래요. 페이지 이미지를 줄 단위로 잘라내고, 이미지 인코더(CNN이나 비전 트랜스포머)가 획의 모양을 벡터로 바꾼 다음, 디코더가 그걸 글자 시퀀스로 풀어내요. 마지막에는 언어 모델이 '문맥상 이 단어가 더 자연스럽다'며 교정을 거들고요.
속기는 여기에 난도가 한 단계 더 붙어요. 획 하나가 음절이나 단어 전체를 뜻하다 보니, 글자 인식이라기보다 번역에 가까운 문제가 되거든요. 학습 데이터도 골치예요. 가벨스베르거 속기 데이터가 인터넷에 널려 있을 리 없잖아요. 이럴 때 흔히 쓰는 방법이 사람이 이미 풀어놓은 페이지를 정답지 삼아 모델을 미세조정(fine-tuning) 하는 거예요. 연구자들이 수십 년간 손으로 쌓은 전사본이 그대로 라벨 데이터가 되는 셈이라, 앞 세대의 수작업이 AI의 발판이 되는 구조예요.
조심할 점도 분명해요. 수학 노트는 기호 하나만 틀려도 뜻이 완전히 달라져요. 언어 모델이 그럴듯하게 메꿔 넣은 부분이 섞이면, 괴델이 쓰지 않은 정리가 괴델의 이름으로 돌아다닐 수도 있고요. 그래서 '수백 개'라는 숫자도 전문가 검증과 정식 출간을 거치기 전까지는 조심스럽게 받아들이는 게 맞아요. AI가 초벌을 뽑고 사람이 검수하는 구조가 여전히 핵심이에요.
비슷한 시도들과 비교해 보면
AI로 '못 읽던 글'을 읽어낸 사례는 최근 몇 년 사이 꽤 쌓였어요. 베수비오 챌린지에서는 화산 폭발로 숯덩이가 된 헤르쿨라네움 두루마리의 CT 스캔 데이터에서 머신러닝으로 잉크 흔적을 찾아 글자를 복원했어요. 딥마인드의 Ithaca와 Aeneas는 깨지고 닳은 그리스어·라틴어 비문의 빈칸을 채우고 연대를 추정하고요.
괴델 노트는 결이 조금 달라요. 베수비오는 잉크가 눈에 보이지 않는 물리적 문제였고, 비문 복원은 글자가 떨어져 나간 손상 문제였어요. 반면 괴델 노트는 글씨는 선명한데 그 부호 체계를 아는 사람이 사라진 지식 단절 문제예요. 게다가 내용이 수학이라는 점이 결정적이에요. 수학 증명은 옳고 그름을 기계적으로 따질 수 있거든요. 그래서 풀어낸 증명을 Lean 같은 증명 보조기(증명의 각 단계를 컴퓨터가 검사해주는 도구)로 옮겨 검증하는 흐름과 자연스럽게 만날 수 있어요. AI가 읽고, 형식화하고, 증명 검사기가 확인하는 파이프라인이 수학사 연구까지 들어오는 그림이죠.
한국 개발자에게는 어떤 의미일까요
먼 나라 수학자 이야기 같지만 구조는 우리 주변 문제와 똑같아요. 초서로 흘려 쓴 한문 고문서, 사람 손으로는 완역에 수십 년이 걸린다는 승정원일기, 가까이는 병원 수기 차트나 오래된 계약서와 도면까지, '글씨는 있는데 읽을 사람이 부족한 문서'는 어디에나 있거든요.
실무에서 가져갈 만한 건 세 가지예요. 첫째, 소량의 전문가 라벨과 미세조정 조합이 생각보다 강력하다는 점이에요. Hugging Face에 공개된 TrOCR 같은 모델로 직접 실험해볼 수 있어요. 둘째, 인식률 못지않게 검수 화면이 중요해요. 원본 이미지와 인식 결과를 나란히 놓고, 모델이 자신 없어 하는 부분을 표시해줘야 전문가의 시간을 아낄 수 있어요. 셋째, 평가 지표를 먼저 정해야 해요. 문서 인식에서는 CER(문자 오류율, 전체 글자 중 틀린 글자의 비율)을 기본으로 쓰는데, 수식이나 고유명사처럼 틀리면 치명적인 부분은 따로 떼어서 측정하는 게 좋아요.
마무리
한 줄로 정리하면, 이번 소식의 핵심은 'AI가 새 수학을 발견했다'가 아니라 '사람이 이미 해놓고도 읽지 못해 묻혀 있던 지식으로 가는 길이 열리고 있다'는 거예요.
여러분 주변에는 어떤 '읽히지 못한 문서'가 있나요? 그리고 AI가 풀어낸 증명을 우리는 어디까지 '괴델의 것'이라고 믿을 수 있을까요? 검증의 기준에 대한 생각을 댓글로 나눠주세요.
이 글은 보도의 핵심 내용과 괴델 유고에 대해 알려진 배경을 바탕으로 정리했어요. 어떤 모델이 쓰였는지, 정리가 정확히 몇 개인지 같은 세부 사항은 원문 기사에서 확인해 보세요.
🔗 출처: Hacker News