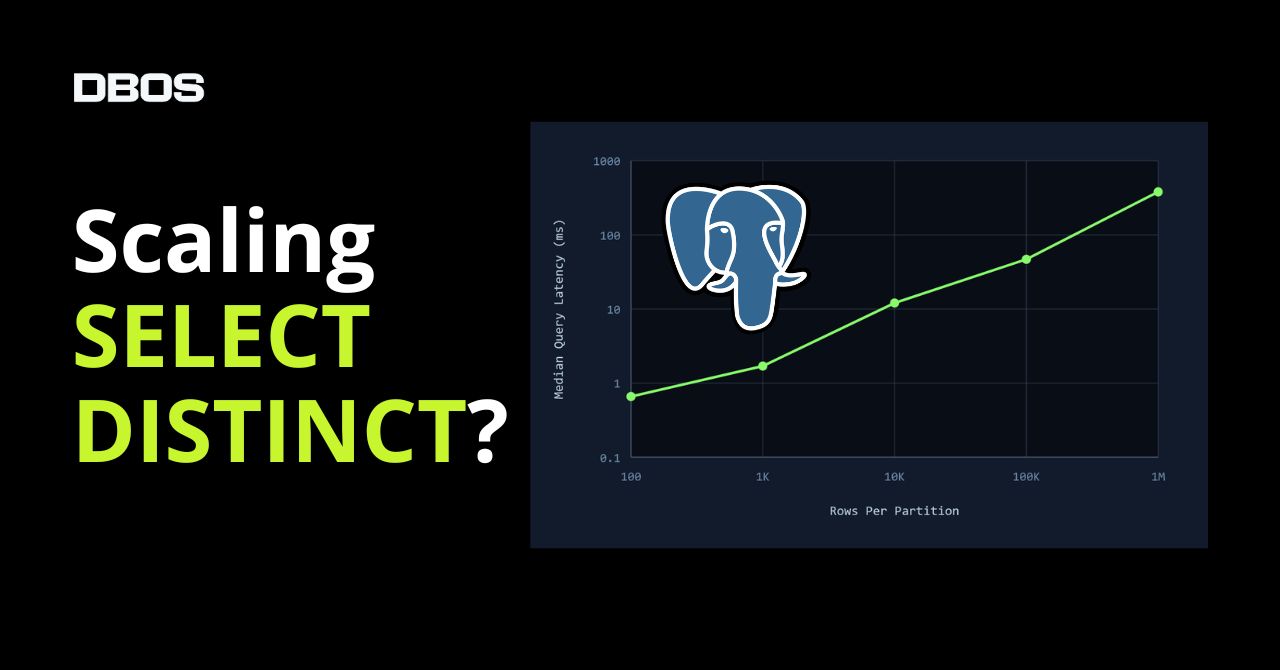
Postgres는 요즘 "모든 것을 담는 데이터베이스"로 자주 추천된다. 그만큼 확장성에 대한 신뢰도 높다. 그런데 직관적으로는 잘 확장될 것 같지만 실제로는 그렇지 않은 기능도 있다. DBOS 팀은 Postgres 기반 큐 시스템의 성능을 진단하다가, 가장 단순하고 저렴해 보였던 SELECT DISTINCT 쿼리가 오히려 가장 비싼 병목이라는 사실을 발견했다. 이 사례는 SQL 문법의 겉모습만 보고 성능을 추정하면 안 된다는 점을 잘 보여준다.
SELECT DISTINCT은 특정 조건을 만족하는 컬럼의 고유한 값들을 찾아주는 구문이다. 문제는 그 성능 특성이 상식과 어긋난다는 데 있다. 테이블을 어떻게 인덱싱하든, 실제 고유 값이 아무리 적든 상관없이, SELECT DISTINCT은 조건에 해당하는 모든 행을 스캔한다. 즉 결과로 나오는 고유 값의 개수가 아니라 조건에 걸리는 전체 행 수에 비례해 시간이 늘어난다.
파티션 큐에서 드러난 문제
DBOS의 워크로드는 큐를 파티션(예: 사용자별)으로 나누고, 각 파티션에 독립적인 흐름 제어를 적용하는 구조였다. 큐에서 작업을 꺼내는 첫 단계는 ENQUEUED 상태의 워크플로가 존재하는 "활성" 파티션을 모두 찾는 것이었고, 이를 SELECT DISTINCT로 구현했다. 이 쿼리는 큐 이름, 워크플로 상태, 파티션 키 순서로 구성된 복합 인덱스로 잘 뒷받침되고 있었다. 인덱스가 이 세 필드를 트리 구조로 정렬해 두므로, 각 고유 파티션에서 행 하나씩만 찾아 반환하면 충분할 것이라고 기대했다. 즉 활성 파티션 수에 비례하는 O(파티션 수) 성능을 예상한 것이다.
초기에는 이 기대가 들어맞는 듯했다. 대부분의 워크로드가 파티션은 많지만 파티션당 워크플로는 적은 "넓고 얕은" 형태였기 때문이다. 문제는 파티션은 적지만 각각에 워크플로가 많이 쌓인 "좁고 깊은" 워크로드에서 터졌다. 파티션이 몇 개뿐이니 1밀리초 안에 끝나야 할 쿼리가 실제로는 수 초씩 걸렸다. 파티션을 10개로 고정하고 파티션당 행을 100개에서 100만 개까지 늘리는 벤치마크를 돌려보니, 지연 시간은 파티션 수가 아니라 파티션당 행 수에 정확히 선형으로 비례했다.
전체 인덱스 스캔이라는 근본 원인
실행 계획을 열어보니 원인이 분명했다. Postgres는 전체 인덱스 스캔을 수행하고 있었다. 즉 해당 큐의 ENQUEUED 워크플로 100만 건을 하나하나 인덱스로 훑으면서 파티션 키가 고유한지 확인했다. 고작 세 개의 파티션 키를 찾기 위해 100만 행을 읽은 셈이다. 이는 인덱스에서 직접 뽑아낼 수 있었던 값을 굳이 전수 조사한 것으로, 극도로 낭비적이다.
쿼리 플래너가 이런 계획을 택한 이유는 다른 선택지가 없기 때문이다. Postgres에서 인덱스를 스캔하는 모든 연산자는 조건에 맞는 값을 전부 가져오는 전체 스캔 방식으로 동작한다. 반면 MySQL은 조건을 만족하는 고유 값만 뽑아 오는 "루스 인덱스 스캔(loose index scan)" 연산자를 제공한다. Postgres 18에서도 다중 컬럼 인덱스에서 맨 앞이 아닌 컬럼을 기준으로 행을 건너뛰는 스킵 스캔(skip scan) 최적화가 추가되긴 했지만, 이 방식 역시 조건에 맞는 행을 모두 스캔하므로 이 문제에는 쓸 수 없다. 2018년에 루스 인덱스 스캔을 도입하려는 시도가 있었으나 유지보수자 교체 등을 거치며 4년 만에 중단됐다.
재귀 CTE로 우회하기
결국 SELECT DISTINCT의 성능이 고유 값 개수가 아니라 테이블 크기에 비례하므로, 대규모에서는 그대로 쓸 수 없다는 결론에 이른다. DBOS 팀은 Postgres가 효율적인 실행 계획을 만들도록 유도하는 우회 쿼리를 작성했다. 핵심은 재귀 공통 테이블 표현식(CTE)이다. 이는 선언형 SQL 안에서 사실상 명령형 반복문을 흉내 내는 기법으로, 첫 반복에서 "가장 작은" 파티션 키를 찾고, 이후 각 반복이 그 다음 고유 파티션 키를 하나씩 찾아 나간다. 각 반복은 정렬된 인덱스에서 SELECT min()을 수행해 값 하나만 가져오므로 인덱스 전체를 훑지 않는다.
각 반복이 고정된 작업량을 갖고 반복 횟수가 고유 파티션 수와 같으므로, 이 쿼리는 목표했던 O(파티션 수) 성능을 낸다. 파티션을 10개로 고정하고 파티션당 행을 1천 개에서 100만 개까지 늘린 벤치마크에서, 새 쿼리의 중앙값 지연 시간은 파티션이 아무리 커져도 변하지 않았다. 실무적으로 이 사례가 주는 교훈은 명확하다. Postgres에서 컬럼의 고유 값을 뽑는 작업이 성능에 민감한 경로에 있다면, 데이터가 "좁고 깊은" 분포로 커질 때 SELECT DISTINCT이 전체 스캔으로 전락할 수 있음을 염두에 두어야 한다. 대신 인덱스를 활용하는 재귀 CTE 패턴이 확실한 대안이 된다. 다만 이 우회 쿼리는 가독성이 크게 떨어지고 인덱스 정렬 구조에 의존하므로, 실제 워크로드의 데이터 분포를 벤치마크로 확인한 뒤 도입 여부를 판단하는 것이 안전하다.