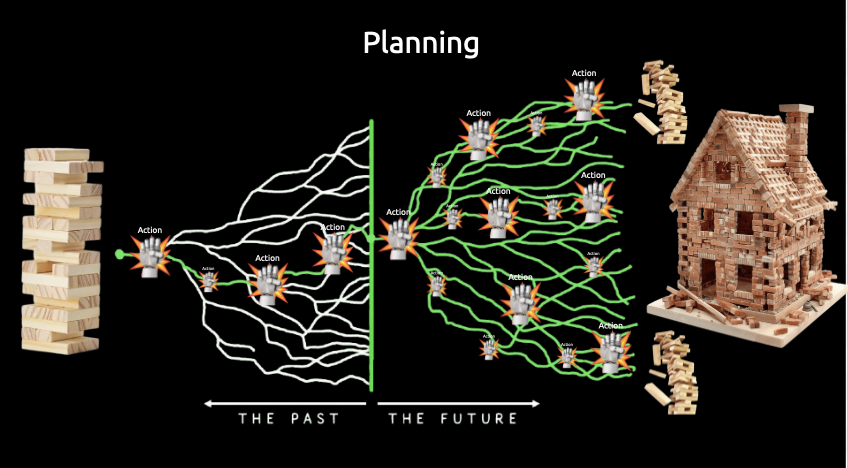
600번의 실험 기록이 공개됐어요
JEPA 방식의 월드 모델로 600번의 실험을 해본 뒤 알게 된 것들을 정리한 글이 올라왔어요. 월드 모델은 로봇이나 자율주행처럼 현실에서 움직이는 AI, 이른바 ‘피지컬 AI’의 핵심 부품으로 꼽히는데요, 그중에서도 JEPA는 얀 르쿤이 LLM의 대안으로 꾸준히 밀어온 노선이에요.
개별 실험의 구체적인 수치와 그래프는 원문에서 직접 보시길 권해요. 이 글에서는 그 기록을 제대로 따라가는 데 필요한 배경, 그러니까 JEPA가 뭐고 왜 실험을 수백 번씩 돌려보게 되는 물건인지를 풀어볼게요.
월드 모델, 그리고 JEPA가 뭐냐면
월드 모델이 뭐냐면, “내가 이렇게 행동하면 세상이 어떻게 바뀔까”를 실제로 해보기 전에 머릿속에서 미리 돌려보는 모델이에요. 우리가 컵을 밀기 전에 “이 정도로 밀면 떨어지겠다”를 아는 것처럼요.
만드는 방법은 크게 두 갈래예요. 하나는 다음 장면을 픽셀 단위로 그려내는 생성형 방식이에요. 결과가 눈에 보여서 직관적이지만, 흔들리는 나뭇잎이나 카펫 무늬처럼 맞힐 수도 없고 맞혀봐야 쓸모도 없는 디테일에 모델의 힘을 쏟게 돼요.
JEPA(Joint Embedding Predictive Architecture, 결합 임베딩 예측 구조)는 반대로 가요. 화면을 먼저 짧은 숫자 묶음(임베딩)으로 요약하고, 다음 화면의 요약본을 예측해요. 내일 날씨를 사진처럼 그리는 대신 “비, 12도”만 맞히는 셈이죠. 학습 코드의 뼈대는 이 정도예요.
z_now = encoder(obs_now) # 현재 화면 → 요약 벡터
z_next = encoder(obs_next) # 다음 화면 → 요약 벡터(정답)
z_pred = predictor(z_now, action) # 행동을 넣어 다음 요약을 예측
loss = mse(z_pred, z_next) + lam * anti_collapse(z_now)
JEPA 실험이 까다로운 이유, ‘붕괴’
마지막 줄의 anti_collapse가 이 분야의 골칫거리예요. JEPA는 정답(z_next)도 모델이 직접 만들거든요. 그러면 아주 쉬운 꼼수가 생겨요. 어떤 화면이 들어오든 인코더가 똑같은 벡터를 내놓으면 예측은 항상 맞고 loss는 0이 돼요. 시험 문제와 채점 기준을 같은 학생이 정하는 상황이죠. 이걸 표현 붕괴라고 불러요.
막는 방법은 계속 바뀌어 왔어요. 초기 I-JEPA와 V-JEPA는 정답용 인코더를 본체보다 천천히 따라오게 만드는 방식(EMA, 지수이동평균)과 기울기 차단을 썼는데, 잘 되긴 해도 왜 되는지 설명이 어려운 경험적 요령에 가까웠어요. 한편 VICReg처럼 임베딩의 분산을 직접 규제하는 갈래도 있었고, 2025년 말 LeJEPA는 임베딩이 사방으로 고르게 퍼진 정규분포를 따르도록 만드는 규제항(SIGReg) 하나로 이런 요령들을 대체하자고 제안했어요.
여기서 중요한 실무 감각이 하나 나와요. JEPA에서는 loss가 내려간다고 학습이 잘 되고 있다는 보장이 없어요. 그래서 임베딩이 실제로 몇 개 차원을 쓰고 있는지, 임베딩만 보고 물체 위치를 간단한 선형 모델로 읽어낼 수 있는지(선형 프로브), 그 모델로 계획을 세웠을 때 과제 성공률이 어떤지를 따로 봐야 해요. 게다가 규제 강도, 예측기 크기, 몇 스텝 앞까지 예측할지 같은 설정에 결과가 민감해서, 조건을 바꿔가며 반복 실험하는 게 이 분야의 기본기예요.
지금 판은 어떻게 짜여 있나
규모가 큰 쪽에는 메타의 V-JEPA 2가 있어요. 100만 시간이 넘는 인터넷 영상으로 먼저 학습하고, 62시간이 안 되는 로봇 영상만 더해서 처음 보는 환경의 로봇 팔이 물건을 집어 옮기게 했어요. 목표 사진의 임베딩에 가까워지는 행동 순서를 요약 공간 안에서 찾는 식이에요. DINO-WM은 이미 잘 학습된 이미지 인코더(DINOv2)를 그대로 두고 예측기만 얹는 절충안이고요.
반대편 끝에는 올해 나온 LeWorldModel이 있어요. 논문에 따르면 파라미터 약 1,500만 개에 손실 항은 두 개뿐이고, GPU 한 장으로 몇 시간이면 학습이 끝나요. 이 정도 규모면 개인 장비로도 수백 번의 실험이 현실적인 숫자가 되죠.
생성형 진영도 만만치 않아요. 구글 딥마인드의 Genie 3는 실시간으로 조작할 수 있는 세계를 그려내고, Dreamer 계열은 요약 공간에서 상상하되 화면 복원도 같이 학습하는 중간 지대에 있어요. 생성형은 사람이 눈으로 검증할 수 있다는 게 강점이고, JEPA는 픽셀을 그리지 않아 계산이 가벼운 대신 결과물이 벡터라 잘 배웠는지 확인하기 어렵다는 게 약점이에요. 르쿤이 메타를 떠나 월드 모델 스타트업 AMI Labs를 차린 것도 이 노선에 건 베팅이고요.
한국 개발자에게는
우선 직접 만져볼 수 있는 주제가 됐다는 게 커요. 2D 밀기 과제(Push-T) 같은 작은 환경이라면 GPU 한 장으로 재현해 볼 수 있고, LLM 파인튜닝보다 부담이 적어요. 제조업과 로봇 비중이 큰 한국에서는 피지컬 AI 수요가 계속 늘 가능성이 높아서, 지금 감을 잡아둘 만해요.
로봇을 안 해도 배울 게 있어요. 붕괴 문제와 표현 평가법은 추천·검색용 임베딩을 학습할 때도 똑같이 나오는 이야기거든요. 그리고 지표 하나만 믿지 않기, 한 번에 변수 하나만 바꾸기, 시드와 설정을 전부 기록하기 같은 실험 습관은 어떤 ML 업무에도 그대로 통해요.
마무리
한 줄로 정리하면, JEPA는 덜 예측해서 더 잘 이해하려는 접근이고, 그 대가로 붕괴와 평가라는 숙제를 떠안아요.
픽셀을 그려내는 월드 모델과 요약만 예측하는 월드 모델, 어느 쪽이 먼저 현장의 로봇을 움직이게 될까요? 직접 돌려보신 분들의 경험도 궁금해요.
🔗 출처: Hacker News