최근 여러 회사가 저마다 'Git 제품'을 내놓는 흐름이 눈에 띈다. 그 배경이 무엇이든, 한 개발자가 오브젝트 스토리지(Tigris)를 백엔드로 삼는 Git 서버를 오픈소스로 만들면서 마주친 기술적 벽은 국내 인프라 실무자에게도 시사하는 바가 크다. 겉보기에 Git은 파일시스템처럼 동작하니, 파일시스템을 번역 계층으로 얹어 오브젝트 스토리지에 연결하면 될 것 같았다. 실제로 소규모에서는 그럭저럭 돌아갔지만, 현실적인 크기의 저장소에서는 성능이 무너졌다. 결국 그는 팩파일 포맷 자체를 오브젝트 스토리지에 맞게 새로 설계하는 길을 택했다.
팩파일은 로컬 디스크를 전제로 만들어졌다
Git은 커밋할 때 변경분을 콘텐츠 주소 기반의 압축 오브젝트로 .git 폴더에 저장한다. 문제는 규모다. 오브젝트를 전부 개별 파일로 두면 리눅스 커널 같은 저장소에서는 과거 node_modules가 그랬듯 inode 한계에 부딪힌다. 그래서 Git은 여러 오브젝트를 하나로 묶은 압축 번들, 즉 팩파일과 그 안의 위치를 알려주는 인덱스를 쓴다. 리눅스 커널 사본은 오브젝트가 1,100만 개에 달하는데, 개별로 가져온다면 GetObject 호출당 넉넉잡아 10ms만 잡아도 전부 받는 데 한 시간이 넘는다. 실제로는 3.4Gi짜리 팩파일 하나로 묶여 있어 그런 일이 벌어지지 않는다.
그렇다면 팩파일이 이미 있으니 문제가 끝난 것 아닐까. 여기서부터 분산 시스템의 복잡함이 시작된다. 팩파일은 로컬 디스크와 mmap을 전제로 설계됐다. Git은 팩파일을 디스크에 쓰고 곧바로 다시 읽는데, 파일시스템 캐시 덕분에 이런 읽기는 길어야 수십 나노초다. 반면 네트워크 왕복은 최소 10ms로, 물리적으로 백만 배가량 느리다. 게다가 Git은 파일에 쓴 직후 그 파일을 읽어 해시를 계산하는 유닉스식 관용구를 쓰는데, 오브젝트 스토리지에서는 PutObject가 끝나기 전의 데이터를 GetObject로 가져올 수 없다.
범위 요청의 함정
HTTP Range 요청을 떠올릴 수 있다. 파일의 일부만 받는 이 기능은 원래 다이얼업 시절 끊긴 다운로드를 이어받기 위한 것이었지만, 이론상 팩파일 안의 특정 오브젝트만 오프셋으로 집어낼 수 있게 해준다. 그런데 실제 인덱스를 순차적으로 처리하면 오브젝트의 압축 해제 후 크기는 알 수 있어도 압축된 크기를 알 수 없다. 즉 정확한 Range 요청을 구성할 정보가 부족하다. 이것이 새 포맷을 만들 수밖에 없었던 절반의 이유였다.
손수 만든 포맷으로 회사 코드 이력을 저장하는 것은 보통 최악의 선택에 가깝다. 다만 Git은 분산 버전 관리 시스템이라 클론할 때 모든 이력을 통째로 복제한다. 즉 모두가 전체 역사의 사본을 갖고 있으니, 새 포맷이 실패해도 다시 push하면 데이터를 복구할 수 있다는 점이 이 도박의 위험을 크게 낮춘다.
CD 백업의 .bin과 .cue에서 빌려온 구조
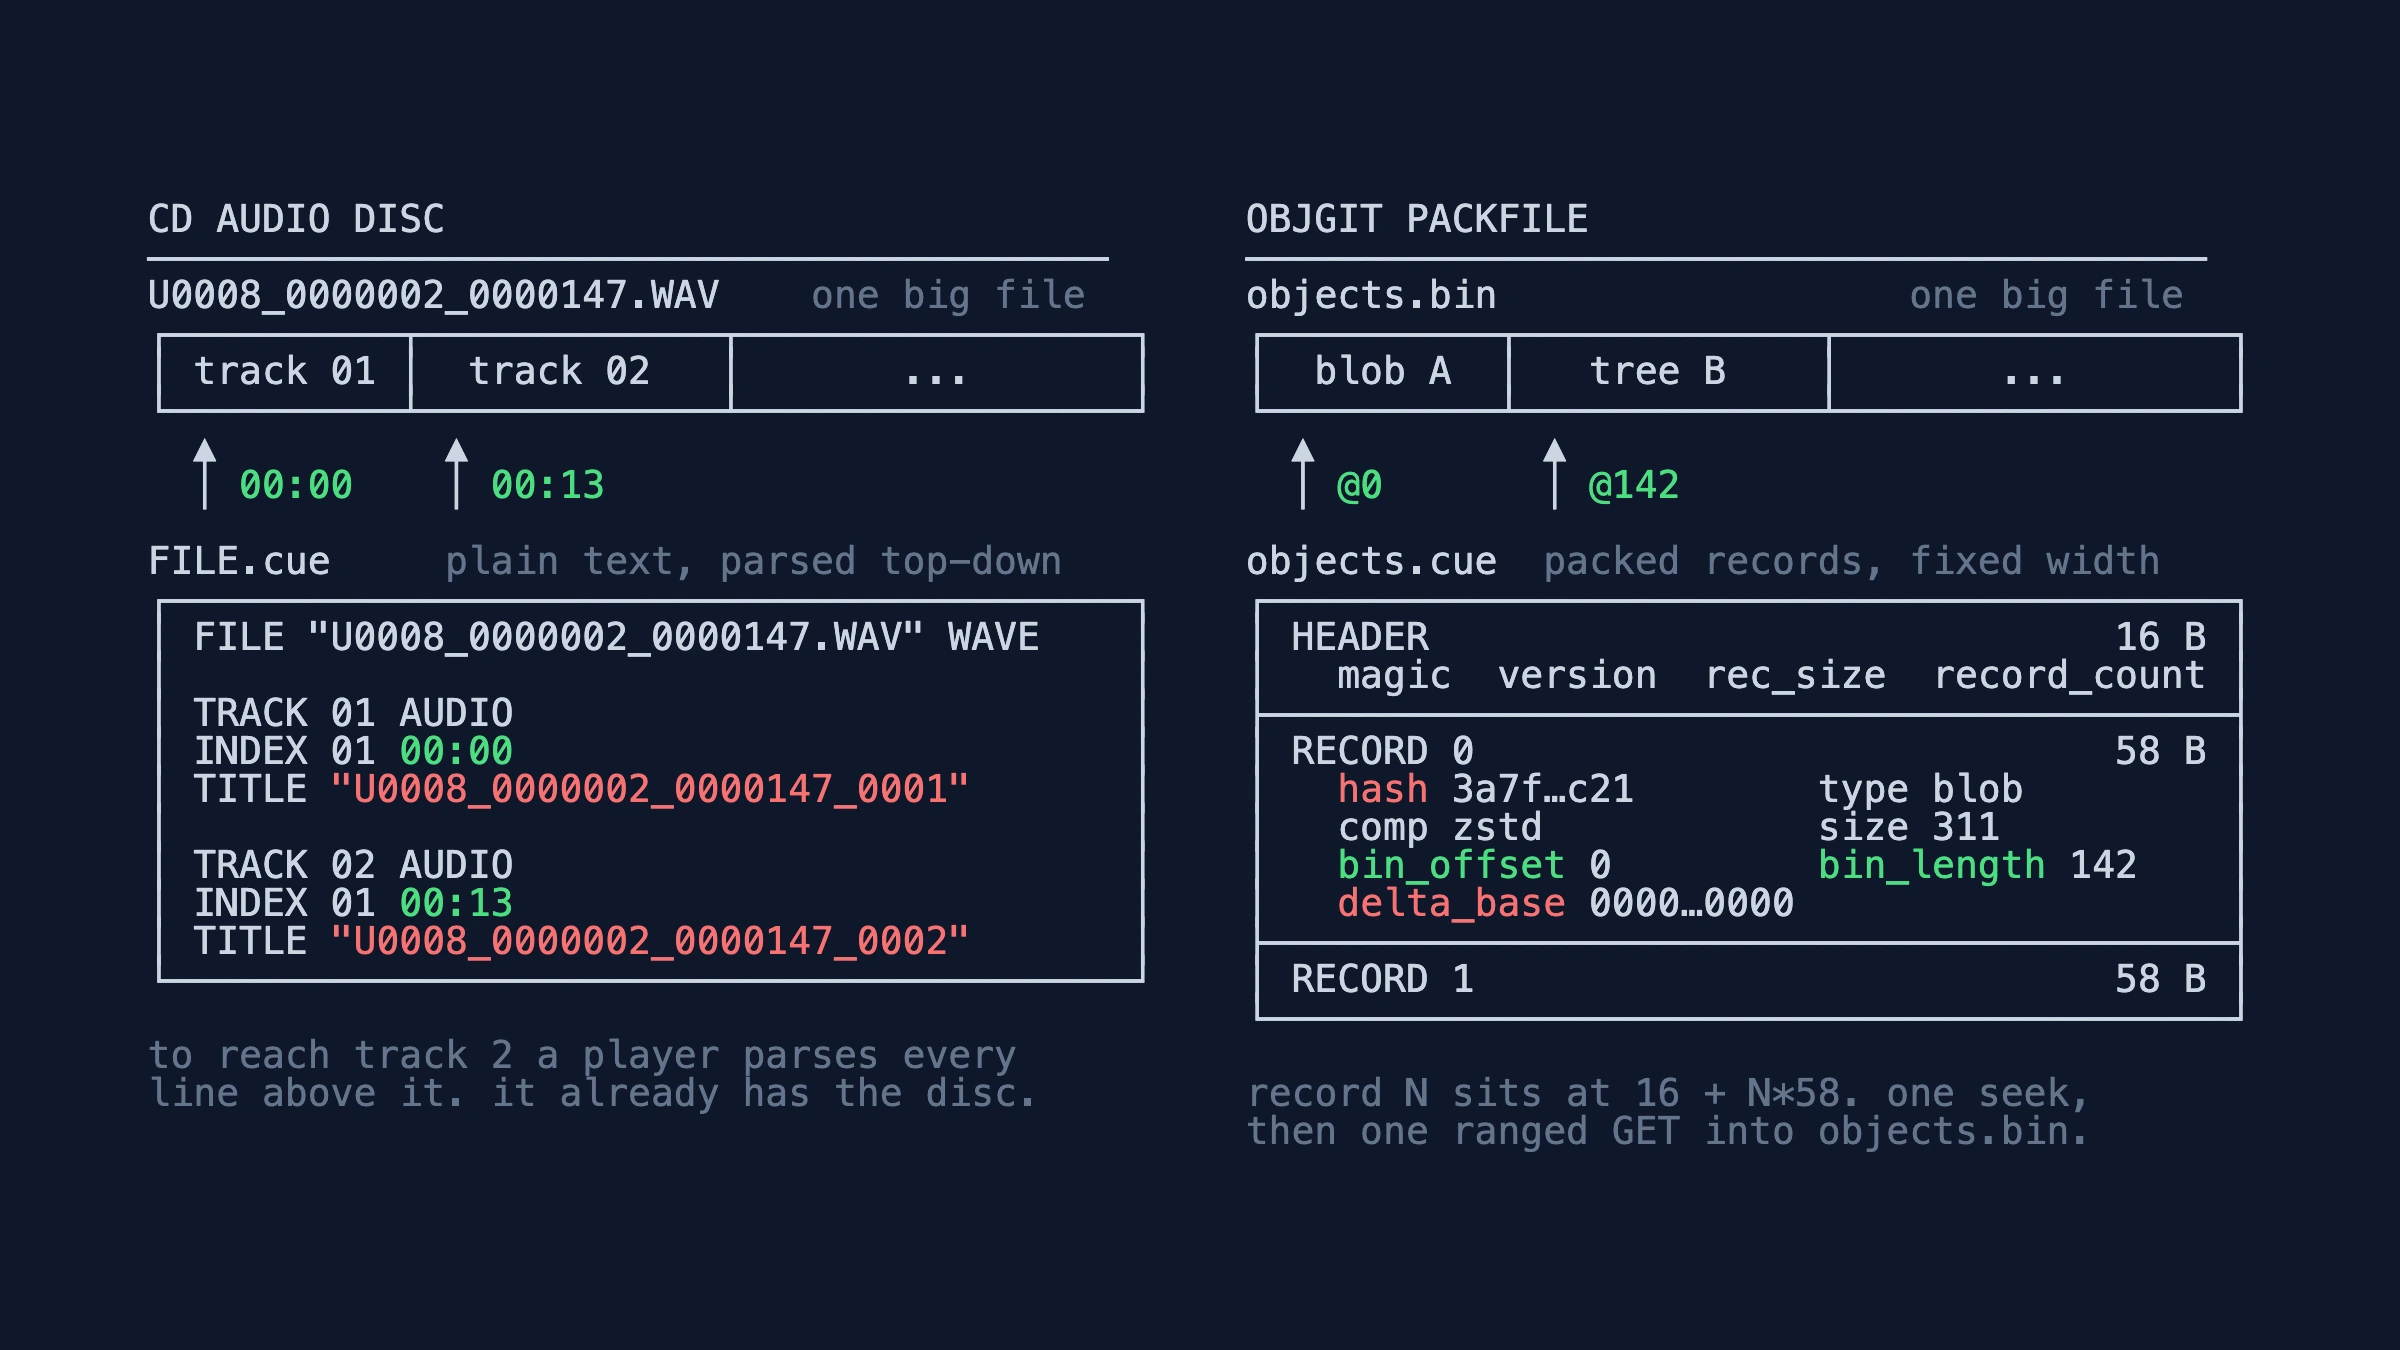
새 포맷의 발상은 뜻밖에도 CD 백업 방식에서 왔다. 데이터 본체를 담는 .bin과, 임의 지점으로 seek할 수 있게 메타데이터를 담는 .cue 시트를 분리하듯, 오브젝트는 최대 128Mi 크기의 .bin 파일에 차례로 쌓고 무엇이 어디 있는지는 바이너리로 인코딩된 별도의 .cue 시트에 담는다. 그 결과 Tigris 위의 Git 저장소는 사실상 컬럼형 저장소가 된다. 핵심은 오프셋과 함께 압축 전·후 크기를 모두 기록한다는 점이다. 이 덕분에 팩파일이 백그라운드에서 내려받히는 동안에도 원하는 오브젝트를 정확한 Range 요청으로 즉시 집어낼 수 있다. 포맷은 zlib보다 빠르고 효율적인 zstd를 쓰고, 델타 오브젝트도 원본 뒤에 붙이지 않고 독립된 오브젝트로 저장해 원본을 읽지 않고도 접근할 수 있게 했다.
지연 최적화도 흥미롭다. Git 라이브러리가 팩파일 내 오브젝트를 요청하면 전체 팩파일을 임시 폴더로 내려받되, 아직 도착하지 않은 '뒤쪽' 데이터는 다운로드가 따라잡을 때까지 Range 요청으로 먼저 가져온다. 결과적으로 팩파일은 읽기에 필요해지는 시점에 딱 맞춰 확보되고, 사용하는 Git 라이브러리의 불가피한 지연 이상은 거의 발생하지 않는다.
실무 관점에서 이 접근의 매력은 클라이언트 변경이 필요 없다는 데 있다. 개발자는 평소처럼 clone·push를 하고, 스토리지 계층이 Git 오브젝트를 오브젝트 스토리지의 오브젝트처럼 다룬다. 다만 이는 특정 오브젝트 스토리지의 임의 접근 성능에 크게 기대는 설계이며, 자체 제작 포맷을 운영에 쓰는 위험은 Git의 분산 특성이라는 안전망 위에서만 성립한다는 점은 분명히 인식할 필요가 있다. 오브젝트 스토리지 위에서 상태 있는 시스템을 재구성할 때, 기존 포맷을 그대로 얹기보다 접근 패턴에 맞춰 포맷을 다시 설계하는 편이 결정적일 수 있음을 보여주는 사례다.