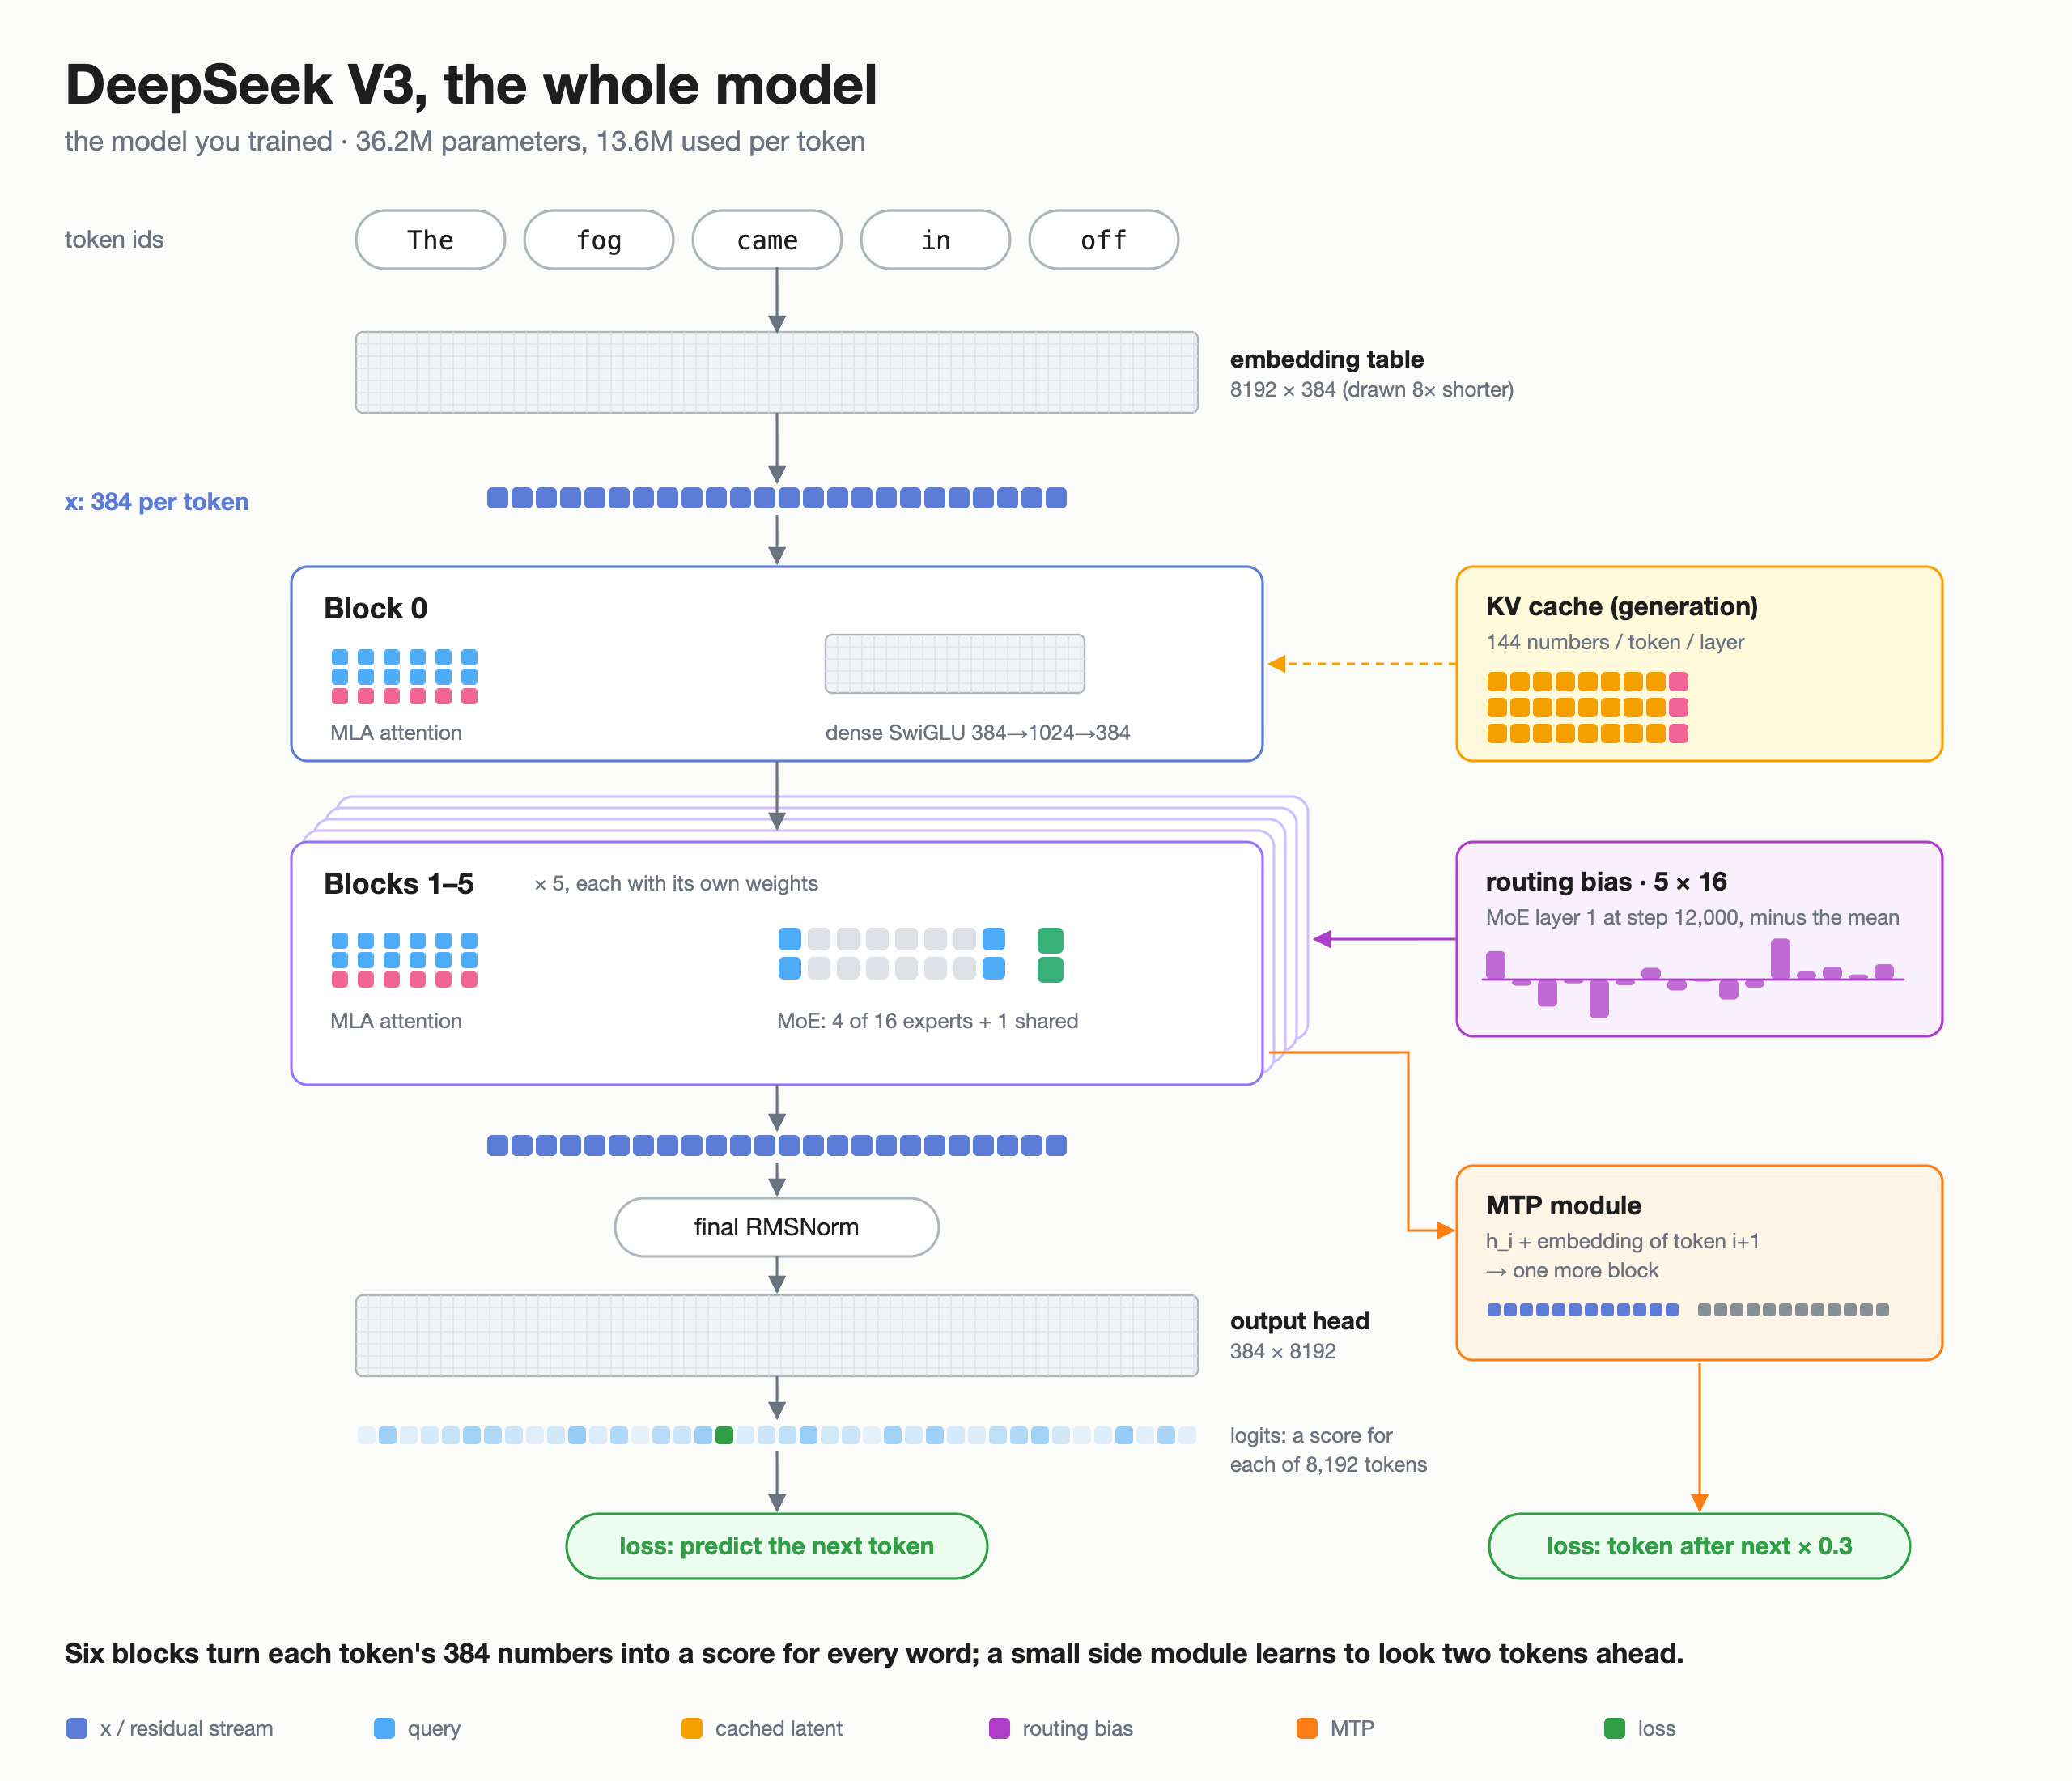
DeepSeek V3 아키텍처를 약 200줄의 순수 JAX 코드로 옮겼다는 프로젝트가 GitHub에 공개됐어요. DeepSeek V3는 파라미터가 6,710억 개나 되는 초대형 모델이라 논문만 읽어서는 감이 잘 안 오는데요, 이렇게 작게 줄인 구현이 있으면 '결국 핵심 부품은 몇 개뿐이구나' 하고 한눈에 들어오거든요. 미리 말씀드리면 200줄짜리 코드가 실제 가중치를 올려 서비스급으로 돌린다는 뜻은 아니고요, 구조를 읽고 실험해 보기 위한 학습용 구현으로 보는 게 자연스러워요. 그래서 이 글에서는 DeepSeek V3를 재현하려면 어떤 부품이 필요한지, 그리고 왜 하필 JAX인지를 풀어볼게요.
DeepSeek V3, 뭐가 특별했죠?
2024년 말에 공개된 DeepSeek V3는 전체 파라미터 6,710억 개 중에서 토큰 하나를 처리할 때 약 370억 개만 사용하는 모델이에요. 덩치는 크지만 매번 일부만 깨워서 쓰니까 학습과 추론 비용이 확 줄어들죠. 이걸 가능하게 한 핵심 부품이 MLA와 MoE예요.
부품 1. MLA: KV 캐시를 압축해서 들고 다니기
LLM이 글을 한 토큰씩 생성할 때는 앞에서 계산해 둔 결과를 다시 쓰려고 key와 value라는 벡터를 저장해 둬요. 이걸 KV 캐시라고 하는데요, 문맥이 길어질수록 메모리를 엄청나게 잡아먹어요. MLA(Multi-head Latent Attention)는 이게 뭐냐면, key와 value를 그대로 저장하지 않고 훨씬 작은 '잠재 벡터' 하나로 압축해서 저장했다가 필요할 때 펼쳐 쓰는 방식이에요. 사진 원본 대신 압축 파일을 보관하는 것과 비슷하죠. 논문 설정으로는 7,168차원짜리 은닉 벡터에서 512차원짜리 잠재 벡터를 만들어 저장해요.
한 가지 까다로운 점은 위치 정보예요. 요즘 모델은 RoPE라는 회전 방식의 위치 인코딩을 쓰는데, 이 압축 저장 방식과는 그대로는 궁합이 맞지 않아요. 그래서 DeepSeek은 위치 정보만 담당하는 작은 채널을 따로 떼어 붙였어요. 구현할 때 가장 헷갈리는 부분이라, 짧은 코드로 확인해 볼 가치가 큰 대목이에요.
부품 2. MoE: 전문가 256명 중 8명만 호출하기
MoE(Mixture of Experts)는 큰 신경망 하나 대신 작은 '전문가' 신경망 여러 개를 두고, 토큰마다 맞는 전문가만 골라 쓰는 구조예요. 종합병원 접수 창구가 환자를 보고 진료과를 배정해 주는 것과 같아요. DeepSeek V3는 층마다 항상 참여하는 공유 전문가 1명과 라우팅 대상 전문가 256명을 두고, 토큰마다 그중 8명을 고르죠.
문제는 인기 있는 전문가에게만 일이 몰리는 현상인데요. 보통은 손실 함수에 벌점을 추가해서 해결하지만, 그러면 모델 성능이 깎일 수 있어요. DeepSeek V3는 전문가마다 편향값을 두고 일이 몰리면 낮추고 한가하면 높이는 식으로, 추가 손실 없이 균형을 맞췄어요. 여기에 다음 토큰뿐 아니라 그다음 토큰까지 맞히게 하는 MTP(Multi-Token Prediction)라는 학습 기법도 더해졌고요.
왜 '순수 JAX'일까요?
JAX는 구글이 만든 수치 계산 라이브러리예요. NumPy와 거의 같은 문법으로 쓰는데, 함수를 넣으면 미분된 함수를 돌려주는 grad, 컴파일해서 빠르게 만들어 주는 jit, 배치 차원을 자동으로 붙여 주는 vmap 같은 '함수 변환'이 핵심이에요. '순수 JAX'라는 말은 Flax나 Equinox 같은 상위 프레임워크 없이 이 기본 도구만 썼다는 뜻이에요.
이렇게 쓰면 모델 가중치는 그냥 중첩된 딕셔너리이고, 모델은 forward(params, x) 형태의 순수 함수가 돼요. PyTorch처럼 클래스 안에 상태가 숨어 있지 않아서, 논문 수식과 코드가 거의 한 줄씩 대응해요. 예를 들어 MoE 라우팅은 점수를 계산하고 jax.lax.top_k로 상위 8개를 고른 뒤 가중합하는 몇 줄이면 표현할 수 있죠. 200줄이라는 분량이 가능한 이유가 여기에 있어요.
비슷한 시도들과 비교하면
작게 다시 짜 보는 문화는 낯설지 않아요. 안드레이 카파시의 minGPT, nanoGPT가 GPT 구조를 수백 줄로 보여주면서 수많은 사람의 교과서가 됐죠. 다만 그쪽은 PyTorch였고 대상도 기본 트랜스포머였어요. 이번 구현은 MLA와 MoE처럼 최근 대형 모델에 들어간 부품을 다룬다는 점, 그리고 함수형 스타일의 JAX로 썼다는 점이 달라요. 반대로 DeepSeek이 공개한 공식 코드는 실제 가중치를 돌리기 위한 것이라 FP8 연산이나 여러 GPU 처리 같은 실전용 코드가 함께 있어서, 구조만 보려는 입문자에게는 부담스러울 수 있어요. 용도가 서로 다른 거죠.
한국 개발자에게 주는 시사점
우선 논문 스터디 교재로 쓰기 좋아요. 차원을 작게 잡으면 GPU 없이 노트북에서도 순전파를 돌려 보고 중간 텐서 모양을 찍어 볼 수 있으니까요. KV 캐시 크기가 왜 문제인지, MoE에서 실제로 계산되는 파라미터가 왜 적은지 설명해야 하는 서빙·인프라 엔지니어에게도 도움이 돼요. JAX 자체도 배워둘 만해요. 실무는 PyTorch가 대세지만 구글 계열 연구 코드는 JAX가 많아서, 읽을 줄만 알아도 최신 연구를 따라가기가 한결 편하거든요.
다만 개인 프로젝트인 만큼 공식 구현과 수치가 일치하는지, 각 부품을 어디까지 옮겼는지는 코드를 직접 확인하고 쓰는 게 좋아요. 라이선스도 한 번 살펴보시고요.
마무리
한 줄로 정리하면, 초대형 모델도 핵심은 'KV 캐시 압축'과 '필요한 전문가만 호출'이라는 두 아이디어이고, 그걸 200줄 남짓한 코드로 읽을 수 있게 됐다는 거예요. 여러분은 새 모델 구조를 공부할 때 논문부터 보시나요, 아니면 이런 미니 구현부터 열어 보시나요?
🔗 출처: Hacker News