무료 논문 저장소 arXiv, 문을 조금 좁히다
AI 공부하는 분이라면 arXiv(아카이브)는 거의 매일 들어가는 사이트일 거예요. 물리학, 수학, 컴퓨터 과학 논문을 학회나 저널 심사 전에 먼저 공개하는 프리프린트 서버예요. 코넬대학교가 운영하고, 누구나 무료로 읽을 수 있어요. 트랜스포머 논문부터 최신 LLM 기술 보고서까지 대부분이 여기 올라오죠.
그런 arXiv가 블로그에서 요청 제한(rate limit) 정책을 업데이트했다고 공지했어요. 논문을 읽기만 하는 분들은 체감할 일이 거의 없을 거예요. 하지만 논문 자동 수집 크롤러, 논문 요약 봇, RAG 파이프라인을 만드는 분들에게는 꽤 중요한 소식이에요. 구체적인 허용치와 적용 범위는 공지 원문을 꼭 직접 확인하세요. 이 글에서는 왜 이런 변화가 생겼는지, 그리고 arXiv 데이터를 ‘예의 바르게’ 가져오는 방법을 정리해볼게요.
rate limit이 뭐냐면
rate limit은 “정해진 시간 동안 한 사용자가 보낼 수 있는 요청 수의 상한선”이에요. 작은 동네 식당을 떠올려보세요. 손님 한 명이 1초에 주문서를 100장씩 밀어 넣으면 주방은 마비되고, 다른 손님들은 밥을 못 먹겠죠. 그래서 사장님이 “한 테이블당 몇 분에 한 번만 주문받을게요” 하고 규칙을 정하는 거예요.
서버도 똑같아요. 제한을 넘으면 보통 HTTP 429 Too Many Requests 응답이 돌아와요. Retry-After 헤더로 “이만큼 기다렸다가 다시 와”라고 알려주기도 하고요. 참고로 arXiv는 예전부터 API 이용 약관에서 3초에 한 번 이하로 요청하고, 동시 연결은 하나만 쓰라고 권고해왔어요.
왜 지금일까: AI 크롤러가 바꾼 풍경
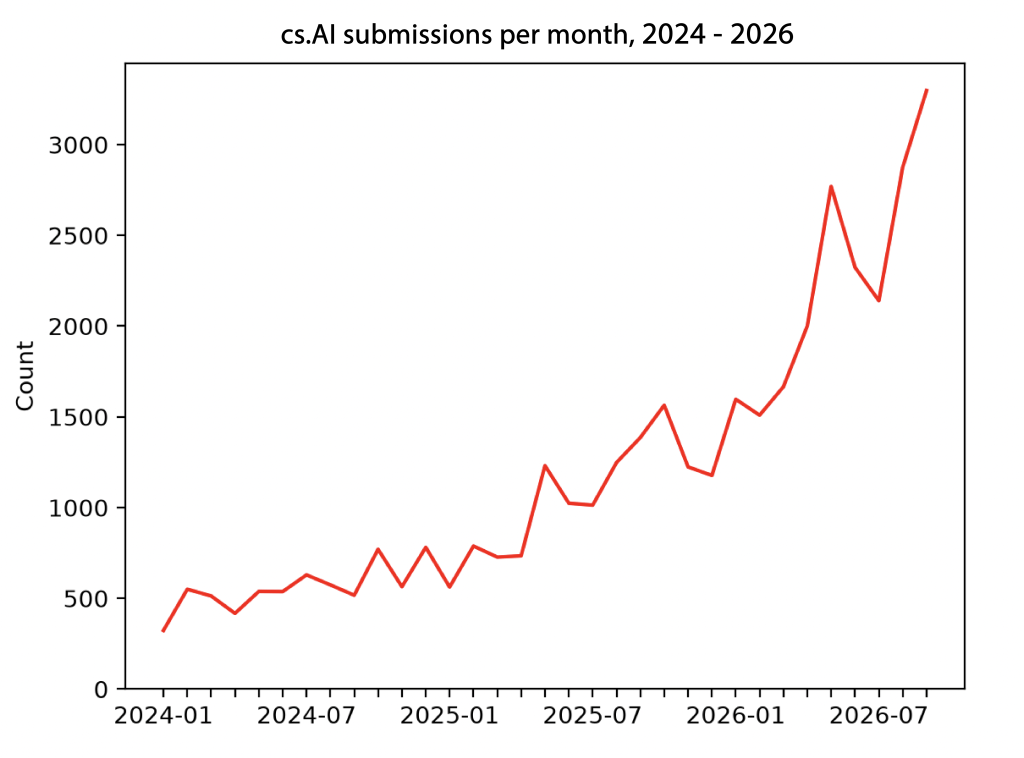
배경에는 AI 시대의 크롤링 폭증이 있어요. 2025년 무렵부터 비영리·오픈소스 인프라들이 AI 학습용 크롤러 때문에 몸살을 앓았다는 이야기가 계속 나왔거든요. GNOME의 GitLab 같은 곳은 작업 증명(Proof-of-Work) 방식의 봇 차단 도구 Anubis를 도입했어요. Wikimedia는 크롤러 트래픽 때문에 대역폭 사용량이 급증했다고 밝히기도 했고요. 게다가 이런 크롤러들은 User-Agent를 위장하고 수많은 IP로 요청을 쪼개 보내서 막기도 어려워요. User-Agent는 요청을 보내는 프로그램의 신분증 같은 거예요.
요즘은 AI 에이전트까지 가세했어요. 사용자가 “최신 논문 찾아서 요약해줘”라고 하면 에이전트가 arXiv에 바로 접속하니까요. arXiv는 회원 기관 후원과 기부로 운영되는 비영리 서비스예요. 이런 트래픽은 곧바로 서버 비용과 운영 부담이 돼요. 정책을 손볼 수밖에 없었던 거죠.
arXiv 데이터, 이렇게 가져오세요
arXiv는 막기만 하는 게 아니라 ‘제대로 된 문’도 열어두고 있어요. 용도에 따라 골라 쓰면 돼요.
- 공식 API (
export.arxiv.org/api/query): 키워드나 저자로 검색할 때 쓰는 기본 창구예요. 결과는 Atom XML로 와요. 파이썬arxiv라이브러리를 쓰면arxiv.Client(delay_seconds=3)처럼 요청 간격 설정이 기본으로 들어 있어서 편해요. - OAI-PMH: 메타데이터를 대량으로, 그리고 증분으로 수집하는 표준 프로토콜이에요. 증분이란 ‘어제 이후 바뀐 것만’ 받는 방식이에요. 매일 새 논문 목록을 동기화하는 서비스라면 이게 정석이에요.
- 벌크 데이터: PDF나 소스 파일이 통째로 필요하면 Amazon S3의 요청자 부담(requester pays) 버킷을 쓰면 돼요. 다운로드 비용을 받는 쪽이 내는 방식이에요. 메타데이터만 필요하면 Kaggle에 공개된 arXiv 데이터셋도 있어요.
업계 맥락: ‘공짜 크롤링’의 시대가 저무는 중
arXiv만의 이야기가 아니에요. 학술 데이터 쪽을 보면 OpenAlex와 Crossref는 요청에 이메일을 넣으면 더 안정적인 ‘polite pool’로 처리해줘요. Semantic Scholar는 API 키를 발급받으면 한도를 더 넉넉하게 주고요. “무료지만, 신원을 밝히면 더 잘 대해줄게”라는 패턴이 자리 잡고 있는 거죠. 범위를 넓히면 Cloudflare가 2025년에 AI 크롤러를 기본 차단하고 크롤링 비용을 받는 모델을 내놓은 것도 같은 흐름이에요. 웹 전체가 ‘누구나 무제한으로 긁어가는 곳’에서 ‘규칙을 지키는 손님만 받는 곳’으로 바뀌고 있어요.
한국 개발자에게 주는 시사점
논문 추천 서비스, 사내 리서치 봇, 논문 기반 RAG를 운영 중이라면 지금 수집 코드를 한번 점검해보세요. 특히 병렬 처리로 속도를 끌어올린 코드는 새 정책에 걸릴 가능성이 높아요. 에이전트에 웹 검색 도구를 붙여 쓰는 분들은 캐시 레이어를 두는 게 좋아요. 그래야 에이전트가 같은 페이지를 몇 번씩 다시 불러오지 않거든요. 공공데이터포털 API에도 일일 트래픽 제한이 있잖아요. rate limit 대응은 이제 크롤러 개발의 기본기예요.
마무리
핵심은 이거예요. arXiv는 앞으로도 무료지만, 무제한은 아니에요. 정해진 문으로, 적당한 속도로 들어가면 아무 문제 없어요.
여러분은 크롤러나 에이전트를 만들 때 rate limit을 어떻게 다루고 계신가요? AI 학습 데이터 수요와 비영리 인프라의 지속 가능성, 그 사이의 균형점은 어디쯤이라고 보시나요?
🔗 출처: Hacker News