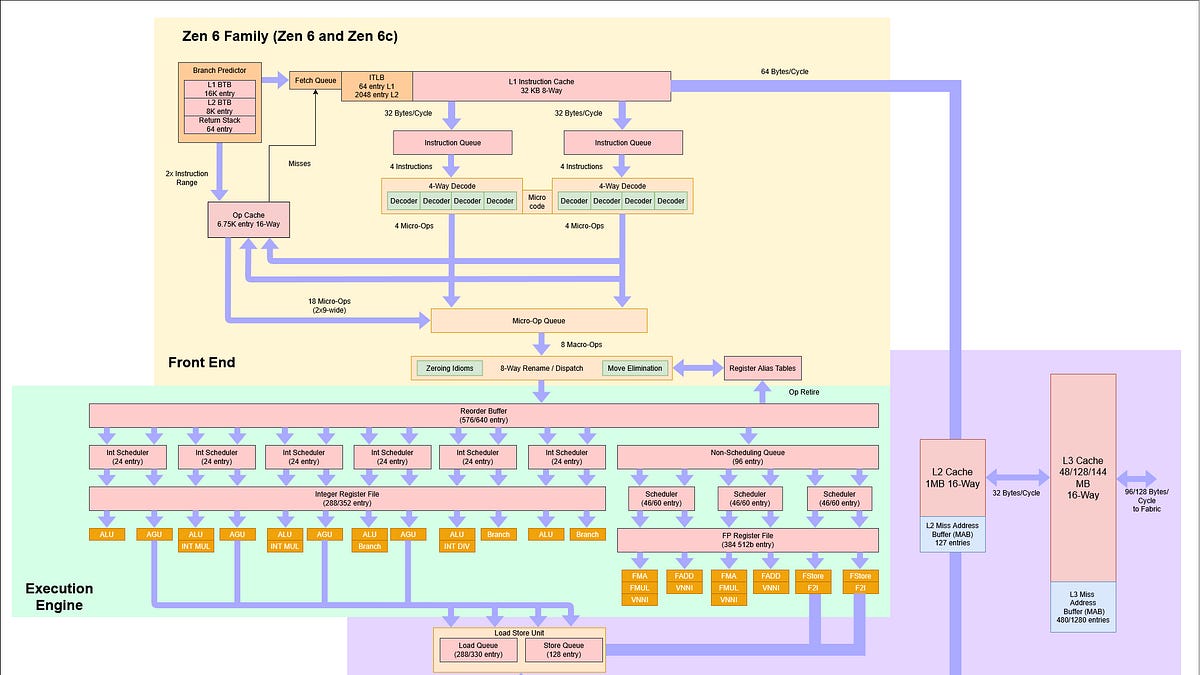
AMD의 차세대 CPU 코어인 젠 6(Zen 6)는 겉으로 보면 젠 5의 자연스러운 연장선이다. 비순차 실행(OoO) 구조를 전반적으로 키우고 코어 곳곳을 다듬은 점진적 개선처럼 보인다. 그러나 안을 들여다보면 정수 스케줄러를 비롯한 여러 부분을 크게 재설계한 흔적이 보인다. 특히 정수 스케줄 구성은 젠 3·젠 4를 연상시키는 배치로 되돌아갔는데, 분석에 따라서는 젠 1에서 젠 2로 넘어갈 때만큼의 변화로 평가된다. 즉 세대 번호만 하나 올라간 미세 조정이 아니라, 내부적으로는 꽤 공격적인 손질이 들어간 세대다.
프런트엔드: 더 빨라진 분기 예측과 두 디코더
젠 5는 측정된 코어 가운데 가장 정확한 방향 예측기를 갖고 있었고, 젠 6는 그 예측기를 그대로 발전시켰다. 눈에 띄는 차이는 예측이 틀렸을 때의 회복 속도다. 예측기가 한계를 넘어 무작위에 가깝게 추측하게 되는 구간에서, 분기당 추가 시간은 젠 5가 약 3.5~4ns인 반면 젠 6는 약 3~3.5ns다. 오예측 한 번의 비용이 줄었다는 뜻으로, 정확도는 비슷하게 유지하면서 틀렸을 때의 손해를 더 작게 만든 셈이다. 또 L1 명령어 캐시 안에서는 사이클당 두 개의 분기를 처리할 수 있게 됐고, BTB는 용량을 늘리기보다 속도를 높이는 쪽에 무게를 뒀다.
디코더 쪽 변화도 실무적으로 중요하다. 젠 5가 도입한 듀얼 디코드 클러스터 구조는 유지되지만, 젠 5에서는 단일 스레드가 사실상 한 클러스터만 쓸 수 있었던 반면 젠 6는 하나의 스레드가 두 디코드 클러스터를 모두 활용한다. 단일 스레드 성능이 중요한 워크로드에서 프런트엔드 병목이 완화될 여지가 생긴 것이다.
실행 유닛: 정수는 효율, 벡터는 VNNI 중심 강화
실행 엔진은 전체적으로 젠 5와 비슷하지만 선택과 집중이 분명하다. 정수 측에서는 젠 4식 NOP 페어링이 돌아와 사이클당 최대 16개의 NOP를 리타이어하고, 동일한 ALU 6개로도 64비트 덧셈을 사이클당 5.96개까지 처리해 젠 5의 5.25보다 이론 최대치에 더 근접한다. 반면 정수 곱셈 유닛은 3개에서 2개로 줄었고 PDEP·PEXT 처리량도 사이클당 3개에서 2개로 내려갔다. AMD는 젠 5의 세 번째 정수 곱셈 유닛이 차지한 면적만큼의 값어치를 못 했다고 본 것이다.
벡터 측에서 부동소수점 유닛 자체는 그대로여서 512비트 FADD·FMUL·FMA를 사이클당 두 개 처리한다. 대신 VNNI 유닛을 2개에서 4개로 늘려 512비트 VNNI 처리량이 1.99에서 3.88 IPC로 거의 두 배가 됐고, 젠 6c도 같은 수치를 낸다. 양자화 추론의 내부 루프나 영상 코덱 필터처럼 VNNI를 쓰는 작업에서 이득이 기대된다. 로드 경로에서는 256비트 로드가 사이클당 4개로 올라 256·512비트 모두 사이클당 128바이트에 도달하는데, 현장에 배포된 벡터 코드 대부분이 여전히 AVX1/2를 겨냥한다는 점에서 의미가 있다.
클래식과 덴스가 갈라진 지점
과거 클래식 코어와 덴스 코어는 CCD당 코어 수와 코어당 L3 용량만 다를 뿐 아키텍처는 사실상 동일했다. 젠 6 세대에서는 이 전제가 깨졌다. 마이크로옵 디스패치 이후부터 로드 큐까지 구간에서 두 코어가 달라진다. 젠 6c는 비순차 구조의 용량이 더 커서, 재정렬 버퍼가 576에서 640, 정수 레지스터 파일이 288에서 352, 벡터 스케줄러가 138에서 180, 로드 큐가 280에서 330으로 늘었다. 더 많은 작업을 띄워 두고 지연을 흡수하기 위한 설계다. 결국 젠 6는 높은 클록에, 젠 6c는 상대적으로 큰 메모리 지연을 버티는 쪽에 맞춰졌다.
캐시 구성도 이를 뒷받침한다. 젠 6는 12코어 CCD, 젠 6c는 32코어 CCD를 쓰지만 코어당 L3는 4MB로 같아 각각 48MB와 128MB가 된다. L3 지연은 젠 5의 약 47사이클에서 젠 6 55사이클, 젠 6c 66사이클로 늘었으나, 젠 6는 높은 클록이 이를 상쇄해 10.7ns로 젠 5 기반 EPYC 9355P의 10.3ns와 큰 차이가 없다. 젠 6c는 낮은 클록과 큰 CCX 탓에 16.4ns다. 한편 젠 5에서 L2 대부분 구간이 사이클당 42바이트만 읽던 이상 동작은 젠 6에서 64바이트로 안정화됐다.
성능과 남는 질문
추정된 단일 스레드 SPEC CPU 2026에서 EPYC 9686F는 상위권에 자리한다. 전 세대 최상위 클라이언트 칩 라이젠 9 9950X3D2를 정수에서 비슷하게 맞추고 부동소수점에서 앞서며, 4.1GHz로 클록을 맞추면 큰 L3를 가진 X3D 대비 정수 약 4%, 부동소수점 약 11% 앞선다. 덴스 코어인 EPYC 9996도 약 900MHz 낮은 클록에 네 배 많은 코어를 달고도 전 세대 EPYC 9575F와 단일 스레드가 엇비슷하다. 두 칩을 맞붙이면 9686F가 양 부문에서 약 18% 앞서지만, 4.1GHz로 클록을 통일하면 그림이 뒤집혀 젠 6c가 클록당 정수 약 6.7%, 부동소수점 약 4% 앞선다. 메모리 집약적 구간에서 젠 6c의 128MB L3가 더 많은 요청을 흡수해 메모리 스톨 비중을 낮추기 때문이다. 다만 코드베이스가 큰 서브테스트에서는 9686F의 프런트엔드 지연 스톨 비중이 눈에 띄게 높아, 캐시·메모리 계층 차이가 그대로 드러난다.
정리하면 젠 6는 프런트엔드·분기 예측·OoO 구조를 두루 손봐 젠 5 대비 분명한 세대 향상을 제공한다. 그러나 실무 관점에서 더 흥미로운 변화는 클래식과 덴스가 더 이상 같은 코어의 밀도 차이가 아니라, 쓰임새에 맞춰 형태를 달리한 두 코어가 됐다는 점이다. 고클록이 유리한 작업인지, 큰 캐시로 메모리 지연을 흡수해야 하는 작업인지에 따라 선택이 달라지므로, 도입 전 워크로드 특성을 먼저 파악하는 일이 전보다 중요해졌다. 남는 질문은 젠 7에서 이 분화가 더 벌어질지, 아니면 공통 기반을 유지할지다.