70년 전 원자력의 약속이 AI로 돌아왔어요
1954년, 미국 원자력위원회 의장이었던 루이스 스트로스가 이런 말을 했어요. '우리 아이들은 전기가 너무 싸서 계량할 필요조차 없는(too cheap to meter) 시대에 살게 될 것이다.' 원자력이 전기를 거의 공짜로 만들 거라는 낙관이었죠. 결과는 다들 아시다시피 그렇게 되지 않았어요. 전기 요금 고지서는 지금도 매달 꼬박꼬박 날아오니까요.
그런데 이 표현이 최근 다시 등장했어요. Rust 컴파일러 쪽 기여로 알려진 개발자 jyn이 'Tokens Too Cheap to Meter'라는 제목의 글을 올렸는데요. 이번엔 전기가 아니라 LLM(대규모 언어 모델)의 토큰 이야기예요. 토큰이 뭐냐면, AI 모델이 글을 읽고 쓸 때 쓰는 최소 단위예요. 영어 단어 하나가 대략 1~2토큰이고, 한국어는 글자 한두 개가 토큰 하나가 되기도 해요. AI API 요금은 이 토큰 개수로 매겨지거든요. 그러니까 '토큰이 너무 싸서 계량할 필요가 없다'는 말은, AI를 쓰는 비용이 사실상 0에 가까워지고 있다는 뜻이에요. 제목부터 도발적인데, 이 표현이 왜 다시 소환됐는지, 그리고 정말 그렇게 될지 같이 따져볼게요.
실제로 얼마나 싸졌길래
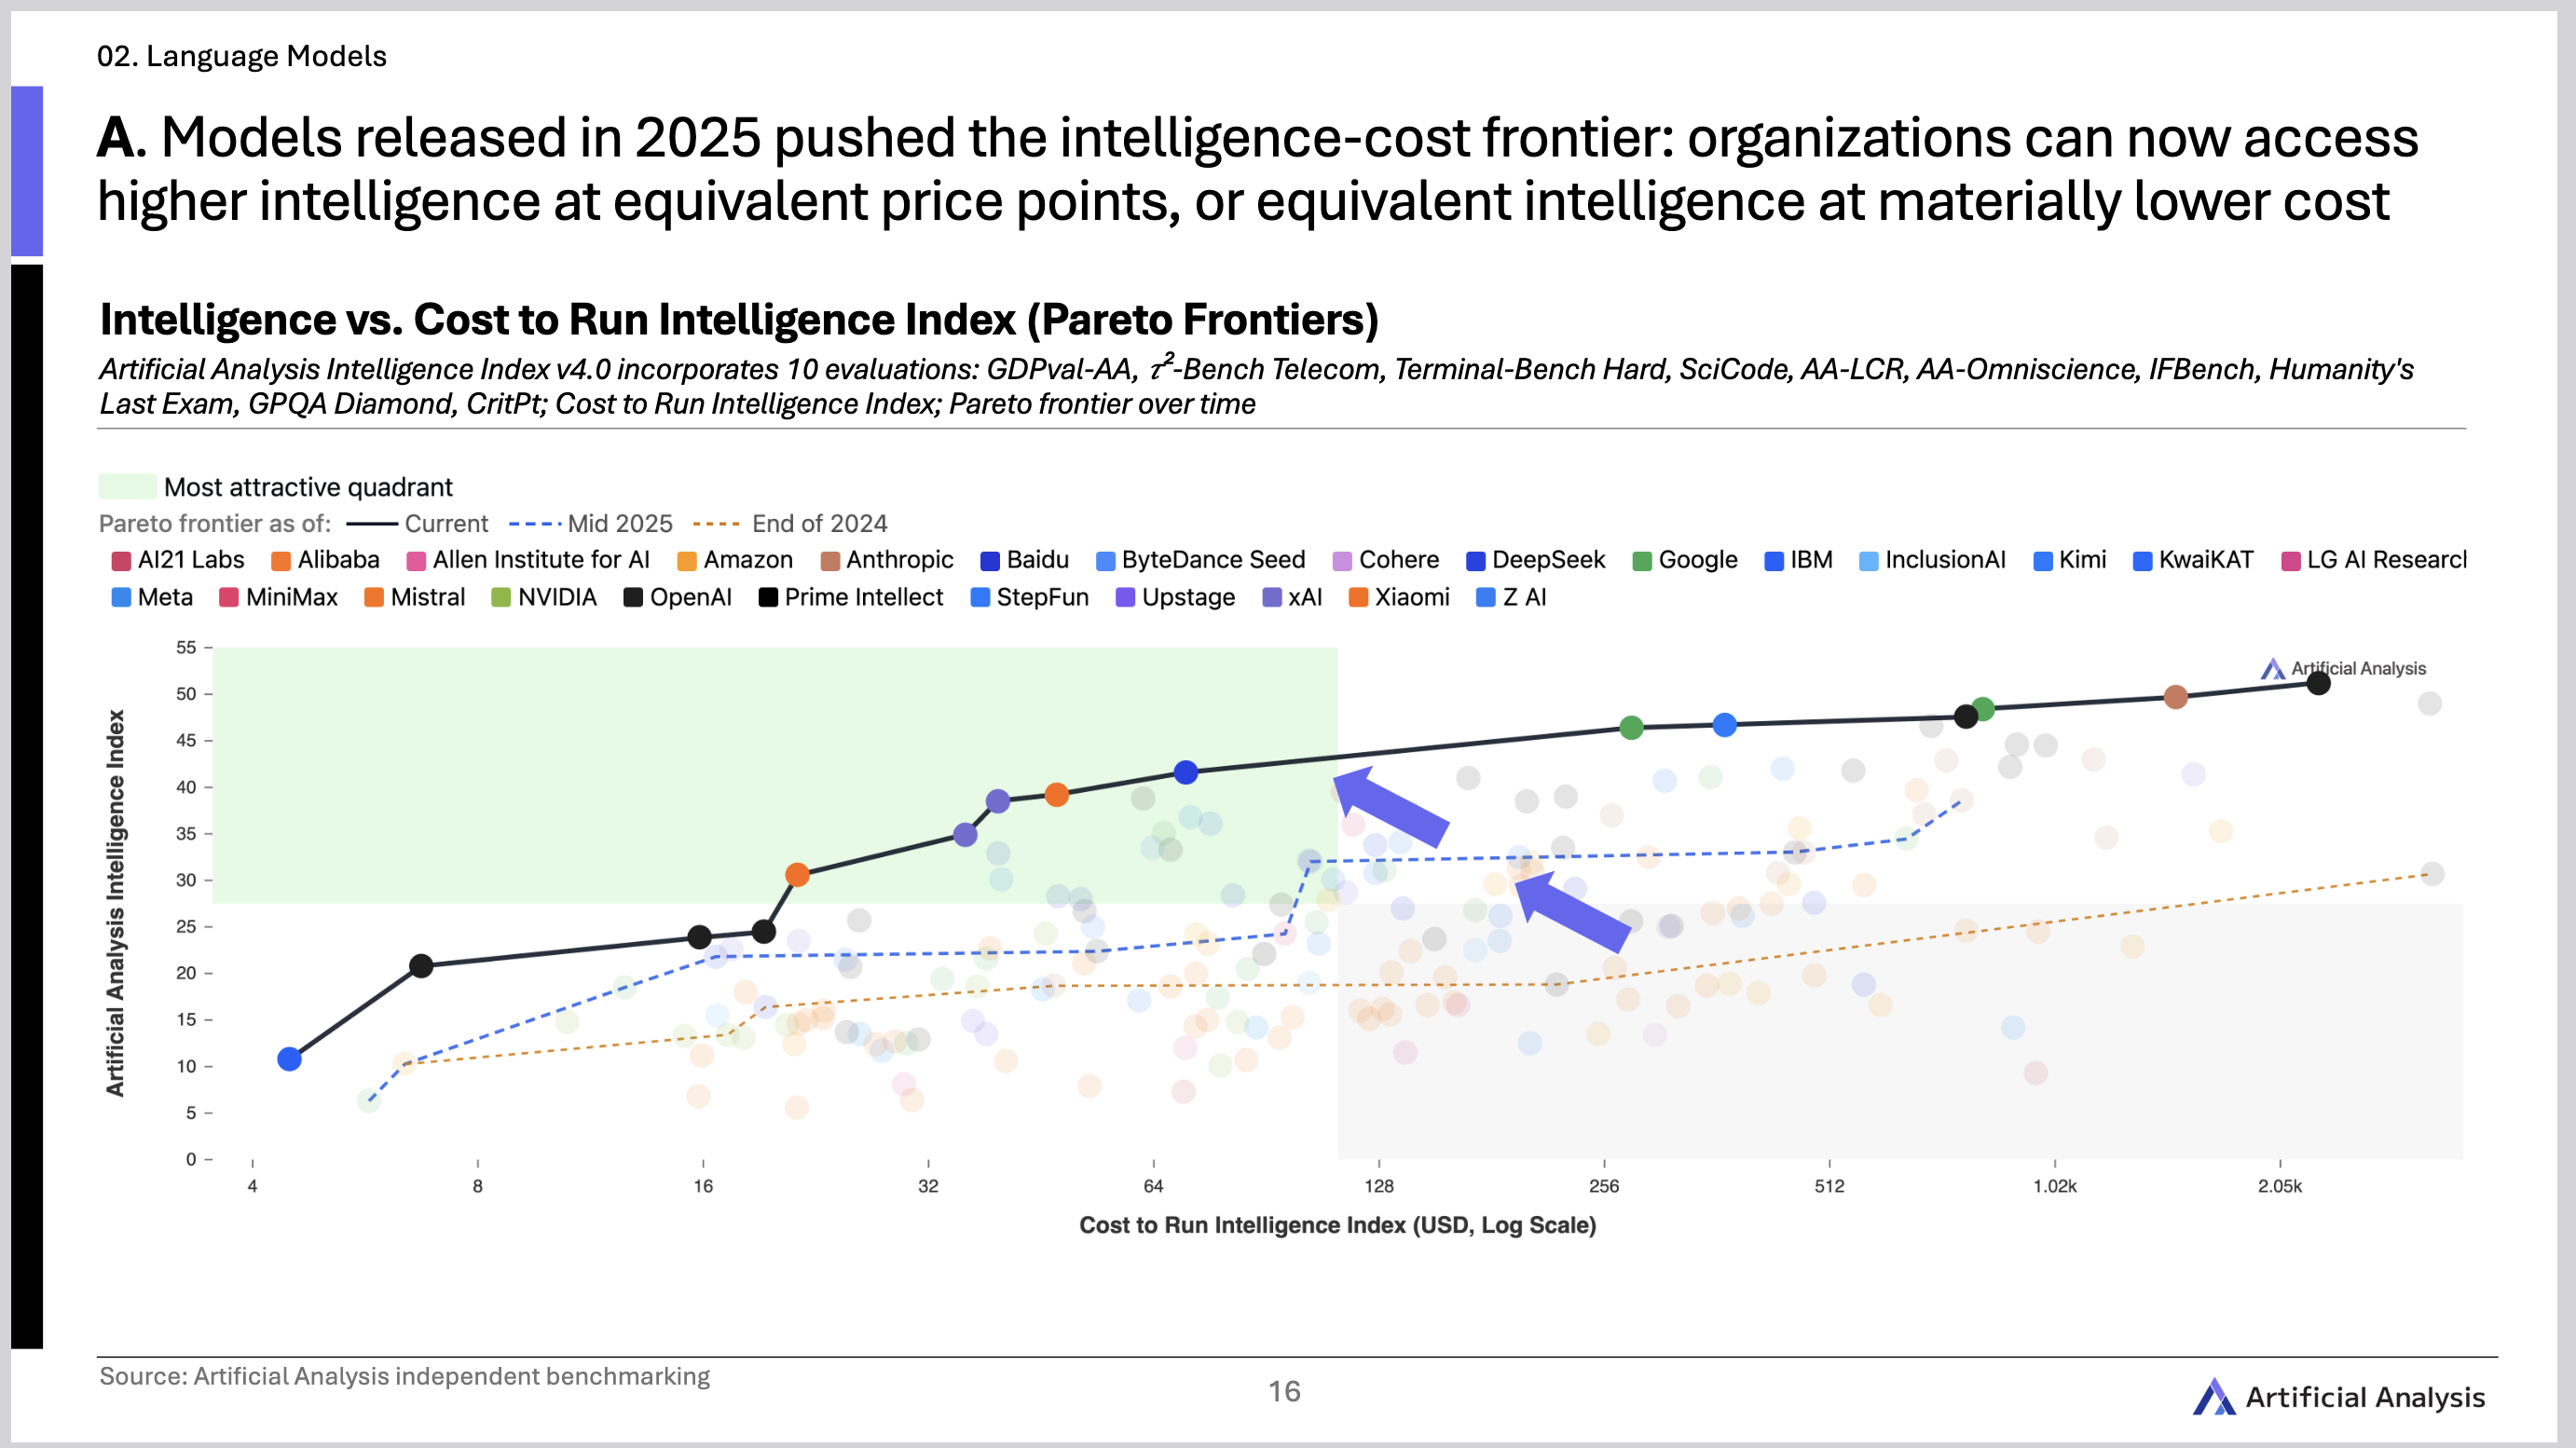
숫자를 보면 감이 와요. 2020년 GPT-3(davinci)는 100만 토큰당 60달러였어요. 2024년에 나온 GPT-4o mini는 입력 기준 100만 토큰당 0.15달러였고요. 성능은 훨씬 좋아졌는데 가격은 400배 가까이 떨어진 거예요. 같은 수준의 지능을 얻는 비용이 매년 10배씩 떨어진다는 분석도 있는데요. 반도체 성능이 2년마다 두 배가 된다는 무어의 법칙보다 훨씬 가파른 기울기예요.
이게 왜 가능하냐면 크게 세 가지가 맞물려 있어요. 첫째, 모델 자체가 효율적으로 바뀌었어요. 큰 모델의 지식을 작은 모델에 옮겨 담는 증류(distillation), 그리고 요청마다 필요한 부분의 파라미터만 켜서 쓰는 MoE(Mixture of Experts) 구조가 대표적이에요. 둘째, 추론 인프라가 좋아졌어요. 여러 요청을 한 번에 묶어 처리하는 배칭, 앞서 계산한 결과를 재활용하는 KV 캐시, 반복되는 프롬프트를 저장해두는 프롬프트 캐싱 같은 것들이죠. 셋째, 경쟁이에요. 누구나 내려받아 돌릴 수 있는 오픈웨이트 모델이 쏟아지면서 가격을 안 내릴 수가 없게 됐어요.
'싸다'가 '공짜'가 되면 뭐가 달라지나요
핵심은 가격 하락 그 자체보다 그게 개발 방식을 어떻게 바꾸느냐예요. 비유를 하나 들어볼게요. 인터넷이 종량제였던 시절엔 다들 접속 시간을 아껴가며 썼잖아요. 그런데 정액제가 되고 나서는 탭을 수십 개 열어두고 영상을 켜놓은 채 잠들어도 아무도 신경 안 써요. 자원이 사실상 무제한이 되면 아끼는 습관 자체가 사라지고, 완전히 다른 사용 패턴이 생기는 거죠.
토큰도 마찬가지예요. 지금까지는 '이 작업에 AI를 쓰면 비용이 얼마지?'를 따져가며 신중하게 호출했어요. 그런데 토큰이 공짜에 가까워지면 굳이 한 번에 정답을 내려고 애쓸 필요가 없어져요. 같은 문제를 열 번 풀게 한 뒤 제일 좋은 답을 고르거나, 코드를 작성한 다음 스스로 리뷰하고 테스트를 돌려보고 다시 고치는 루프를 수백 번 돌리는 접근이 가능해지죠. 사람이 개입하는 지점이 '매 단계'에서 '최종 결과 확인'으로 옮겨가는 거예요. 실제로 에이전트 방식의 코딩 도구들은 하나의 작업을 위해 파일을 읽고, 검색하고, 수정하고, 테스트하는 과정에서 수십만 토큰을 자연스럽게 소모해요. 예전 같으면 비싸서 못 할 방식인데 지금은 그게 기본 동작이에요.
그런데 원자력은 왜 실패했을까요
여기서 잠깐 삐딱하게 볼 필요가 있어요. 원자력 전기는 왜 계량할 필요 없는 수준까지 못 갔을까요? 발전 원가는 실제로 낮아졌지만, 발전소 건설비, 안전 규제, 송전망 유지비 같은 고정비가 계속 따라붙었기 때문이에요. 전기 한 단위를 더 만드는 한계 비용은 0에 가까워도, 그걸 집까지 전달하는 시스템 전체의 비용은 0이 될 수 없었던 거죠.
AI 토큰에도 비슷한 함정이 있어요. 첫 번째는 제번스의 역설(Jevons paradox)이에요. 자원이 싸지면 절약하는 게 아니라 오히려 더 많이 쓰게 된다는 경제학 개념인데요. 토큰이 100배 싸지면 우리는 100배가 아니라 1000배 더 쓰게 될 거예요. 에이전트 도구를 써보신 분들은 아실 텐데, 단가는 떨어졌는데 월 청구서는 오히려 늘어나는 경험을 하게 되거든요. 두 번째는 최전선 모델의 가격이에요. '2년 전 수준의 지능'은 확실히 공짜에 가까워지고 있지만, '지금 가장 똑똑한 모델'은 여전히 비싸요. 그리고 우리는 늘 가장 똑똑한 걸 쓰고 싶어 하죠.
한국 개발자에게 주는 시사점
첫째, 비용 최적화의 기준을 다시 잡을 때예요. 반년 전에 비싸서 포기했던 아이디어가 있다면 지금 다시 계산해보세요. 문서 전체를 매번 컨텍스트에 넣는 방식, 모든 PR에 AI 리뷰를 붙이는 방식, 로그를 통째로 LLM에 넘겨 분석하는 방식이 이제는 현실적인 선택지일 수 있어요.
둘째, 모델 선택 전략이 중요해져요. 모든 작업에 최고급 모델을 쓸 필요는 없어요. 분류나 추출처럼 단순한 작업은 작은 모델로 돌리고, 복잡한 추론이 필요한 부분에만 큰 모델을 쓰는 라우팅 구조를 짜두면 비용을 크게 줄이면서 품질은 유지할 수 있어요.
셋째, 그럼에도 토큰 사용량 모니터링은 놓지 마세요. '계량할 필요가 없다'는 말은 아직 은유예요. 실제로는 에이전트가 무한 루프에 빠져서 하룻밤에 수백 달러를 태우는 사고가 심심치 않게 일어나거든요. 예산 상한선, 호출 횟수 제한, 알림 설정은 여전히 필수예요.
정리하면
토큰의 단가는 확실히 공짜에 가까워지고 있고, 그래서 AI를 '아껴 쓰는' 설계에서 '마음껏 돌리는' 설계로 사고를 바꿀 때가 왔지만, 총 비용은 사용량이 폭발하면서 오히려 늘 수 있으니 계량기는 아직 떼면 안 된다는 거예요.
여러분은 어떠세요? 토큰 비용 때문에 접었다가 지금은 다시 해볼 만하다고 느끼는 프로젝트가 있으신가요? 팀에서 AI 사용 비용을 어떤 기준으로 관리하고 계신지도 궁금해요.
🔗 출처: Hacker News