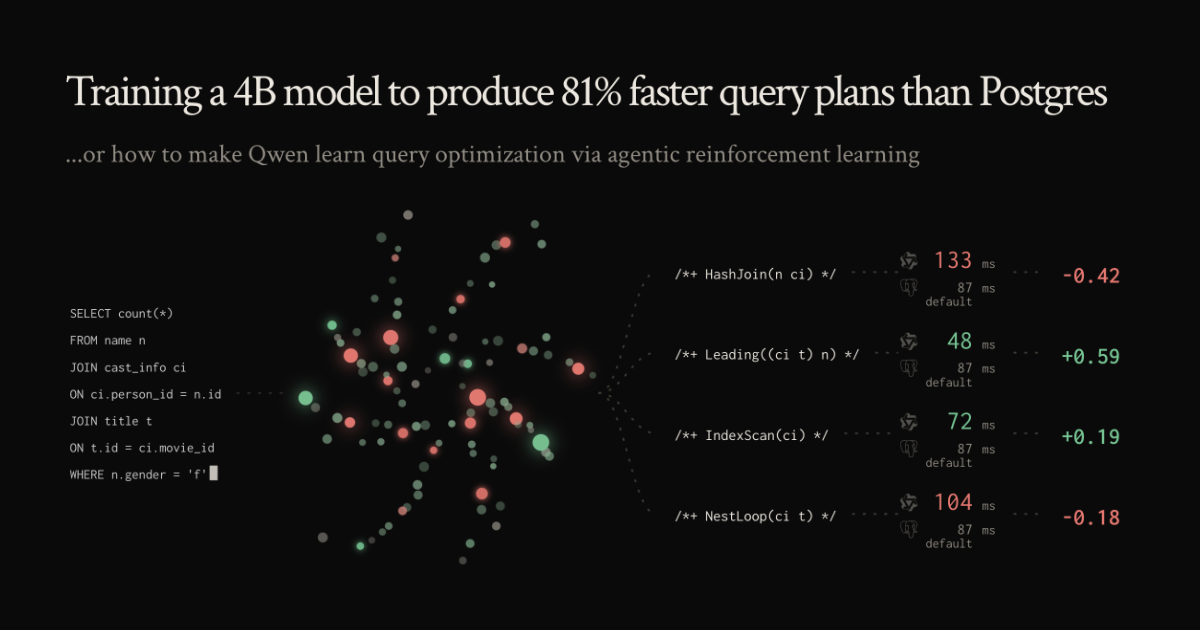
지금 데이터베이스 쪽에서 꽤 흥미로운 실험 결과가 하나 나왔어요. Rohan Bansal이라는 개발자가 QORL이라는 프로젝트를 공개했는데요. 40억(4B) 파라미터짜리 작은 언어 모델을 강화학습으로 훈련시켰더니, PostgreSQL이 자체적으로 만드는 쿼리 실행 계획보다 81% 더 빠르게 실행되는 계획을 뽑아냈다는 내용이에요. 'Postgres 옵티마이저를 AI가 이겼다'는 말인데, 왜 이게 의미가 있는지 처음부터 차근차근 풀어볼게요.
쿼리 옵티마이저가 뭐냐면
SQL은 좀 특이한 언어예요. 우리는 '어떤 데이터를 원하는지'만 적지, '어떻게 가져올지'는 적지 않거든요. 테이블 다섯 개를 조인하는 쿼리를 던지면, 어느 테이블부터 읽을지, 두 테이블을 합칠 때 해시 조인을 쓸지 중첩 루프를 돌릴지, 인덱스를 탈지 전체를 훑을지 같은 결정은 전부 데이터베이스가 알아서 해요. 이 결정을 내리는 부품이 바로 쿼리 옵티마이저(플래너)예요.
문제는 경우의 수가 어마어마하다는 거예요. 테이블 10개만 조인해도 가능한 조인 순서가 수백만 가지가 넘어요. 그래서 Postgres는 각 방법의 '비용'을 추정하는 수식(비용 모델)을 가지고 있고, 동적 계획법으로 그중 가장 싸 보이는 계획을 고르죠. 테이블이 너무 많으면 유전 알고리즘(GEQO)으로 적당히 괜찮은 답을 찾고요.
그런데 이 비용 추정이 자주 틀려요. 비용 계산의 핵심 재료가 '이 조건을 만족하는 행이 몇 개일까'라는 카디널리티 추정인데, 여러 조건이 서로 연관되어 있으면(예를 들어 도시가 부산이면 지역번호가 051일 확률이 높다) 테이블 통계만으로는 맞추기 어렵거든요. 추정이 10배 틀리면 조인 순서가 꼬이고, 그러면 같은 쿼리가 몇 초 걸릴 게 몇 분 걸리는 일이 생겨요. DBA들이 힌트를 넣고 쿼리를 고쳐 쓰느라 고생하는 이유가 대부분 여기서 나오죠.
어떻게 학습시켰나
QORL의 접근은 생각보다 단순해요. 언어 모델한테 SQL 쿼리와 스키마 정보를 주고, '이 쿼리는 이런 순서로, 이런 조인 방식으로 실행해'라는 계획을 텍스트로 뱉게 해요. 그 계획을 Postgres에 강제로 적용하는 건 pg_hint_plan 같은 확장으로 가능하고요. 그다음이 핵심인데, 그 계획으로 실제로 쿼리를 돌려서 실행 시간을 재고, 빨랐으면 보상을 많이 주고 느렸으면 적게 주는 방식으로 모델을 업데이트해요.
이게 강화학습이에요. 이게 뭐냐면, 정답지를 주고 외우게 하는 게 아니라 '해보고 결과가 좋으면 칭찬, 나쁘면 벌점'을 반복해서 스스로 좋은 행동을 찾게 하는 방식이에요. 쿼리 최적화가 강화학습에 잘 맞는 이유는 '정답 계획'을 사람이 만들어줄 필요가 없다는 점이에요. 실행 시간이라는 완벽하게 객관적인 채점 기준이 이미 있으니까요.
왜 하필 4B라는 작은 모델이냐면, 옵티마이저는 쿼리가 들어올 때마다 매번 돌아야 하는 부품이라서요. 계획 짜는 데 3초 걸리면 쿼리가 2초 빨라져도 의미가 없잖아요. 4B 정도면 GPU 한 장, 혹은 잘 양자화하면 CPU에서도 수백 밀리초 안에 답을 낼 수 있어요.
다만 81%라는 숫자는 조심해서 읽어야 해요. 이건 벤치마크 전체 실행 시간 기준이고, 학계에서 쓰는 조인 벤치마크들은 Postgres 옵티마이저가 특히 약한 복잡한 다중 조인 쿼리 위주거든요. 기본키로 한 줄 찾는 단순 쿼리에서는 이런 이득이 나올 수 없어요.
이전 시도들과 뭐가 다른가
학습형 옵티마이저는 사실 새로운 아이디어는 아니에요. 2019년 MIT 쪽에서 나온 Neo가 신경망으로 조인 계획을 직접 만들었고, 2021년 Bao는 좀 더 현실적인 접근을 택했어요. 계획을 통째로 만드는 대신 '이 쿼리엔 해시 조인 끄기', '이 쿼리엔 인덱스 강제' 같은 힌트 묶음 몇 개 중 하나를 고르는 식이었죠. 선택지를 좁혀서 실패해도 크게 망하지 않게 한 거예요.
QORL이 다른 점은 범용 언어 모델을 출발점으로 삼았다는 거예요. 이전 모델들은 조인 트리를 숫자로 인코딩하는 전용 신경망이라 스키마가 바뀌면 처음부터 다시 배워야 했는데, 언어 모델은 SQL 자체를 읽을 수 있으니 새로운 테이블이나 쿼리 패턴에 훨씬 유연하게 대응할 여지가 있어요. 대신 Bao 같은 안전장치 없이 계획을 통째로 생성하면, 가끔 터무니없이 느린 계획을 만드는 리그레션 위험이 커지죠. 상용 DB들도 같은 문제를 알고 있어서, Oracle의 적응형 계획이나 SQL Server의 지능형 쿼리 처리처럼 '실행 중에 추정이 틀렸다 싶으면 계획을 바꾸는' 방향으로 조금씩 움직여 왔어요.
우리한테 무슨 의미인가
솔직히 이걸 내일 프로덕션에 넣을 순 없어요. 열 번 중 아홉 번 빨라져도 한 번 100배 느려지면 그게 장애거든요. 하지만 당장 써먹을 수 있는 방향은 있어요. 느린 쿼리 로그에서 상위 쿼리들을 뽑아 모델이 제안한 계획을 EXPLAIN ANALYZE로 검증하고, 사람이 확인한 뒤 pg_hint_plan으로 고정하는 '옵티마이저 코파일럿' 형태예요. 이 흐름을 만들려면 실행 계획 읽는 법과 힌트 다루는 법을 알아야 하니, 그 자체가 좋은 공부가 되죠.
더 큰 교훈은 '채점이 자동으로 되는 문제에는 작은 모델과 강화학습 조합이 정말 강하다'는 패턴이에요. 인덱스 추천, 쿼리 리라이팅, 컴파일러 최적화 플래그 선택, 캐시 정책 튜닝처럼 결과를 숫자로 잴 수 있는 영역이 여러분 회사 안에도 꽤 많을 거예요.
정리
20년 넘게 사람이 손으로 다듬어 온 비용 모델을, 실행 시간을 보상으로 배운 4B 모델이 넘어서기 시작했어요. 여러분 서비스에서 가장 골치 아팠던 느린 쿼리는 옵티마이저가 잘못 판단한 경우였나요, 아니면 스키마나 인덱스 문제였나요? 그리고 실행 계획을 AI에게 맡기려면 어떤 안전장치가 있어야 안심이 될까요?
🔗 출처: Hacker News