무슨 이야기인가요
미국의 여론조사 기관 퓨리서치센터(Pew Research Center)가 온라인 설문에서 '가짜 응답자(bogus respondents)'를 걸러내는 방법들을 검토한 보고서를 냈어요. 제목이 꽤 솔직해요. '쉬운 해결책은 없다(No Easy Fix)'. 여론조사 얘기가 왜 개발자 커뮤니티에 올라오냐고 생각하실 수 있는데요. 이 문제의 본질이 봇 탐지, 데이터 품질, 그리고 요즘 폭발적으로 늘어난 LLM 기반 자동 응답이라서 그래요. 사용자 리서치를 돌리거나, 크라우드소싱으로 학습 데이터를 모으거나, 서비스에 설문 기능을 만드는 팀이라면 남 얘기가 아니거든요.
'옵트인 패널'이 뭐고 왜 문제인가요
이게 뭐냐면, 온라인 옵트인(opt-in) 설문은 광고나 포인트 사이트를 통해 '설문 참여하고 보상 받으세요'라고 모집한 사람들에게 설문을 돌리는 방식이에요. 전화로 무작위 표본을 뽑는 것보다 훨씬 싸고 빠르니까, 요즘 시장 조사나 여론조사 상당수가 이 방식으로 돌아가요. 문제는 보상이 걸려 있다는 점이에요. 돈이 되면 봇이 오고, 한 사람이 여러 계정을 만들고, 해외에서 VPN을 타고 들어와 미국인인 척하고, 요즘은 LLM으로 주관식 답변까지 그럴듯하게 써내요.
퓨리서치는 몇 년 전부터 이 문제를 추적해 왔는데요. 예전 조사에서 옵트인 패널 응답자 중 일정 비율이 가짜로 추정된다는 결과를 냈고, 더 흥미로운 건 이 가짜 응답자들이 '아무 질문에나 예라고 답하는' 성향이 있다는 거예요. 그래서 나온 유명한 사례가 있어요. 30세 미만 응답자의 12%가 '핵잠수함 조종 면허가 있다'고 답한 거예요. 당연히 말이 안 되죠. 이런 응답이 섞이면 실제로는 5%인 의견이 15%로 부풀려지고, 특히 젊은 층이나 소수 집단처럼 표본이 작은 그룹에서 왜곡이 심해져요.
왜 걸러내기가 어렵나요
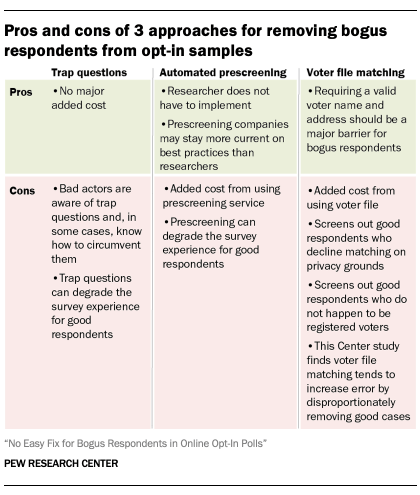
보통 생각하는 방법들이 있어요. 너무 빨리 답한 사람 제거(speeder 필터), 모든 문항에 같은 답을 찍은 사람 제거(straightlining 탐지), '이 문항에는 약간 동의를 선택하세요' 같은 주의력 확인 문항(attention check), 같은 IP나 기기에서 온 중복 제거, 주관식 답변이 말이 되는지 확인, 이런 것들이요. 퓨리서치가 이번에 짚은 요지는 이 방법들이 각각 일부만 잡아내고, 서로 겹치는 부분이 적으며, 어떤 걸 어떻게 조합해도 가짜 응답을 완전히 제거하지 못한다는 거예요.
더 근본적인 문제가 있어요. 필터를 세게 걸면 진짜 응답자도 같이 날아가요. 빨리 답하는 진짜 사람도 있고, 주의력 문항을 실수로 틀리는 진짜 사람도 있거든요. 그러면 남는 표본이 '설문에 유독 성실한 사람들'로 편향돼서 또 다른 왜곡이 생겨요. 게다가 필터 기준이 알려지면 봇 운영자는 금방 적응해요. 응답 시간에 랜덤 딜레이를 넣고, 주의력 문항 패턴을 학습하고, LLM으로 주관식을 채우면 지금의 필터 대부분은 무력화돼요. 스팸 필터나 어뷰징 탐지를 해본 개발자라면 익숙한 창과 방패의 싸움이에요.
업계 맥락: 크라우드소싱과 학습 데이터도 똑같은 문제를 겪고 있어요
이 문제는 여론조사에만 있는 게 아니에요. 아마존 메커니컬 터크(MTurk)나 프롤리픽(Prolific) 같은 크라우드소싱 플랫폼에서는 이미 몇 년 전부터 '작업자가 LLM으로 답을 생성한다'는 연구가 나왔고, 그렇게 오염된 데이터로 모델을 학습시키면 모델이 모델을 배우는 악순환이 생겨요. RLHF(사람 피드백으로 모델을 다듬는 과정)에 쓰이는 선호 데이터, 제품 리뷰, 앱스토어 평점, 커뮤니티 투표까지 '사람의 의견을 모으는 모든 파이프라인'이 같은 위협에 노출돼 있어요.
대응 방향도 비슷하게 수렴하고 있어요. 하나는 모집 단계에서 신원 검증을 강화하는 것(퓨리서치 자체가 주소 기반으로 무작위 모집한 패널을 쓰는 이유예요), 다른 하나는 응답 내용이 아니라 행동 신호(마우스 움직임, 입력 리듬, 기기 지문)를 보는 것, 그리고 애초에 보상 구조를 봇에게 매력 없게 만드는 거예요. 어느 것도 완벽하지 않고, 전부 비용이 든다는 게 문제고요.
한국 개발자에게 주는 시사점
당장 실무에서 적용할 수 있는 건 이래요. 첫째, 설문이나 리뷰, 투표 데이터를 그대로 믿지 마세요. 최소한 응답 시간 분포, 중복 기기, 주관식 유사도 정도는 확인하고, '이 데이터에 가짜가 몇 퍼센트 섞여 있을 것'이라는 가정을 분석 결과에 명시하세요. 둘째, LLM으로 학습 데이터나 평가 데이터를 크라우드소싱한다면, 작업자가 LLM을 쓰는지 탐지하는 것보다 아예 '사람만 할 수 있는 과제' 설계(자기 경험 서술, 실시간 상호작용 등)로 바꾸는 게 효과적이에요. 셋째, 필터링 기준은 공개하지 말고 주기적으로 바꾸세요. 넷째, 필터로 제거한 응답과 남긴 응답의 인구 분포를 비교해서, 필터 자체가 편향을 만들고 있지 않은지 확인하세요.
마무리
한 줄로 정리하면, 온라인에서 사람의 의견을 모으는 모든 시스템은 이제 '봇과 LLM이 섞여 있다'는 전제로 설계해야 하고, 완벽한 필터는 없으니 오염을 측정하고 관리하는 쪽으로 사고를 바꿔야 한다는 거예요.
여러분 서비스의 리뷰나 투표, 설문 데이터는 얼마나 믿을 수 있나요? 봇이나 LLM 응답을 걸러내려고 시도해 본 방법 중 효과가 있었던 게 있다면 공유해 주세요.
🔗 출처: Hacker News