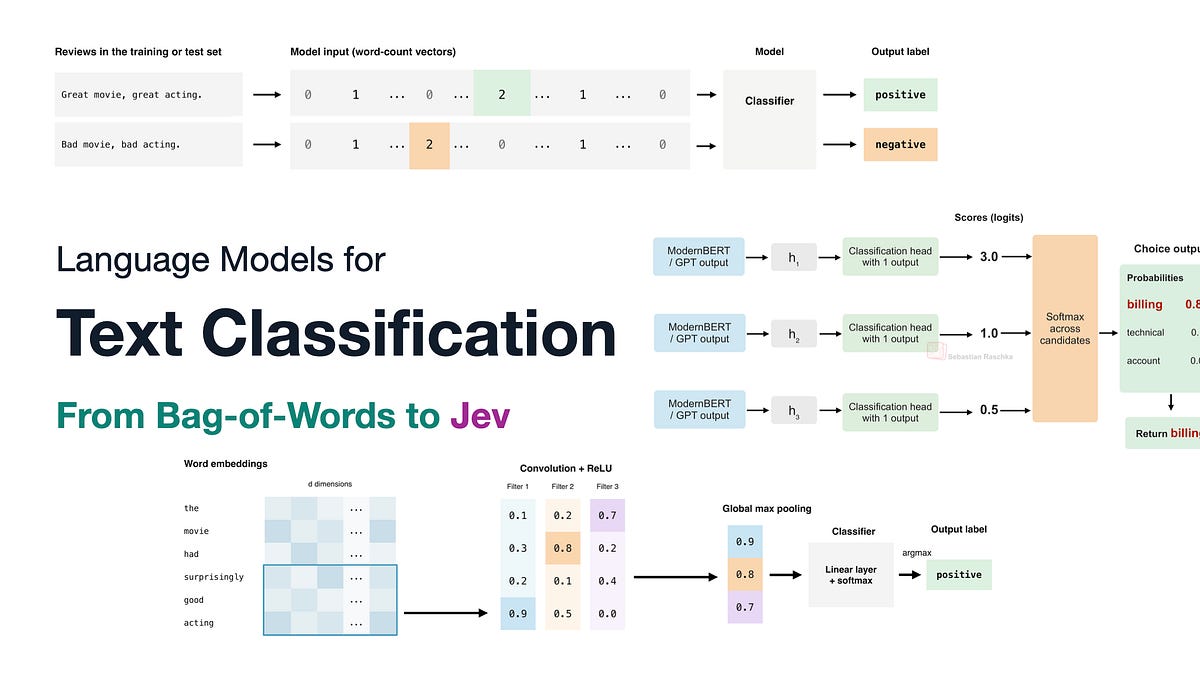
최근 2주 사이 기술 커뮤니티에서 'Jev(제프)'라는 AI 모델이 하나의 문화 현상처럼 회자되고 있다. 제프는 이름 그대로 무언가를 '분류'하는 모델이다. 그래서 처음에는 "결국 분류기 아니냐, 이 정도면 내가 직접 만들 수 있다"는 반응을 사기 쉽다. 하지만 텍스트 분류를 오랫동안 다뤄 온 실무자들 사이에서도 "생각보다 훨씬 잘 작동한다"는 쪽으로 평가가 기우는 분위기다. 이 열풍을 제대로 이해하려면 제프가 어디에 서 있는 모델인지, 즉 텍스트 분류 기술의 계보 안에서 그 위치를 짚어 볼 필요가 있다.
제프의 핵심 강점은 성능의 절대치가 아니라 '위치'에 있다. 최신 GPT 계열이나 오픈웨이트 대형 언어 모델도 제프가 하는 분류 작업을 똑같이 해내며, 오히려 훨씬 폭넓은 의사결정까지 할 수 있다. 대신 제프는 같은 분류 작업을 더 빠르고 저렴하게 처리한다. 반대쪽 끝을 보면, 좁고 명확하게 정의된 문제에서는 그 문제만을 위해 만든 전용 분류기가 제프보다 더 정확하고 빠르고 싸다. 제프의 판매 포인트는 이 전용 모델들보다 훨씬 범용적이라는 점이다. 결국 제프는 범용 LLM과 전용 분류기 사이의 빈 공간을 메우는 절충안인 셈이다.
단어 가방에서 시작된 텍스트 분류
텍스트 분류의 고전적 출발점은 '단어 가방(bag-of-words)' 표현이다. 길이가 제각각인 자유 형식 텍스트를, 고정 크기 입력 벡터를 요구하는 나이브 베이즈·로지스틱 회귀·SVM·랜덤 포레스트·XGBoost 같은 전통적 분류기에 맞춰 주는 방법이다. 원리는 단순하다. 학습 데이터에 등장하는 모든 고유 단어로 어휘 사전을 만들고(의미가 거의 없는 'a', 'the' 같은 불용어는 선택적으로 제거), 각 단어에 벡터의 한 자리를 배정한 뒤 문서마다 단어가 몇 번 나오는지를 센다. 어휘가 5만 개면 입력이 열 단어든 30만 단어든 항상 5만 차원 벡터가 나오고, 대부분의 값은 0이다. 원시 빈도 대신 TF-IDF 같은 정규화 기법을 쓰기도 한다.
이 방식은 계산이 저렴하고, 특정 단어가 라벨에 강한 단서를 주는 스팸 필터링 같은 문제에서 빠르고 꽤 정확한 결과를 낸다. 실제로 초기 Gmail 스팸 필터도 나이브 베이즈와 단어 가방을 썼다고 알려져 있다. 다만 결정적 약점은 단어 순서를 잃는다는 점이다. "개가 사람을 문다"와 "사람이 개를 문다"가 동일한 벡터로 표현된다. n-그램으로 국소적 순서를 일부 보존할 수 있지만 그만큼 어휘 크기가 커진다. 그럼에도 단어 가방과 로지스틱 회귀의 조합은 구현이 워낙 쉬워서, 저위험 응용에서는 여전히 모든 텍스트 분류 문제의 기본 기준선(baseline)으로 쓸 만하다.
RNN과 CNN, 그리고 순서를 살리는 표현
단어 가방의 순서 손실을 피하려는 시도가 단어 임베딩과 신경망 구조다. 단어 가방이 텍스트 전체를 빈도로 표현한다면, 임베딩은 개별 단어를 학습된 밀집 벡터로 표현한다. Word2Vec이나 GloVe처럼 모델 밖에서 학습하거나, 임베딩 층을 신경망 안에 넣어 함께 학습할 수 있다. 다만 이런 고전적 임베딩은 조회 시점에 문맥과 무관해서 'river bank'와 'bank account'의 'bank'가 같은 벡터를 받는다. 문맥 반영은 이후 어텐션 같은 개념이 담당한다.
RNN은 텍스트를 한 단어씩 읽으며 현재 단어 임베딩과 직전 은닉 상태를 결합한다. 은닉 상태는 지금까지 처리한 내용을 요약한 고정 크기 벡터이고, 순서를 바꾸면 상태 갱신의 흐름이 달라지므로 단어 순서가 의미를 갖는다. 학습이 까다로운 것이 단점이라 LSTM(1997), GRU(2014), 최근의 xLSTM(2024) 같은 개선이 이어졌고, 고정 크기 상태를 순차 갱신한다는 착상은 어텐션보다 저렴한 상태공간 모델로도 이어졌다. CNN 역시 이미지의 패치 대신 인접한 단어 임베딩 창에 필터를 적용하는 식으로 텍스트에 쓸 수 있으며, 입력 길이에 무관한 출력을 위해 전역 최대 풀링을 쓰는 것이 일반적이다.
숫자로 보면 계보의 성격이 분명해진다. 균형 잡힌 IMDb 영화 리뷰 데이터셋에서 단어 가방과 로지스틱 회귀는 약 89.9% 정확도를 기록했지만, 밑바닥부터 학습한 LSTM RNN은 오히려 85.66%에 그쳤다. 단순함이 늘 지는 것은 아니라는 뜻이다. 반면 큰 데이터로 먼저 사전학습한 뒤 목표 과제에 미세조정하는 전이학습을 적용한 ULMFiT(2018)은 같은 데이터에서 95.4%까지 끌어올렸다. 트랜스포머는 2017년 이 어텐션 계보를 이어받아 많은 NLP 응용에서 RNN을 대체했다.
실무자가 읽어야 할 함의
제프 열풍을 기술적으로 번역하면, "제프는 본질적으로 텍스트 분류기이지만, 단지 분류기인 것만은 아니다"라는 이중적 진술로 요약된다. 실무 관점에서 중요한 건 도구 선택의 스펙트럼이다. 문제가 좁고 라벨이 명확하며 단어 단서가 강하다면, 단어 가방과 로지스틱 회귀 기준선이나 전용 분류기가 여전히 가장 경제적이다. 반대로 폭넓은 판단과 유연성이 필요하면 대형 LLM이 답이다. 제프의 자리는 그 사이, 즉 범용성은 원하지만 LLM의 지연과 비용은 부담스러운 경우다.
다만 이 기사가 제프 자체의 내부 구조를 확증하는 것은 아니라는 점은 짚어 둘 필요가 있다. 원 저자도 제프의 방법론을 '교육적 추정'이라고 명시했고, 어떤 제휴나 무료 제공도 없이 순수하게 기술적 맥락을 제공하려는 글임을 밝히고 있다. 결국 지금 필요한 태도는 새 모델 이름에 휩쓸리기보다, 자신의 문제가 정확도·속도·비용의 삼각형 어디에 놓이는지를 먼저 정의하는 것이다. 분류기의 30년 계보가 알려 주는 교훈은 한결같다. 가장 화제가 되는 모델이 아니라, 문제에 맞는 표현과 규모를 고른 쪽이 이긴다.