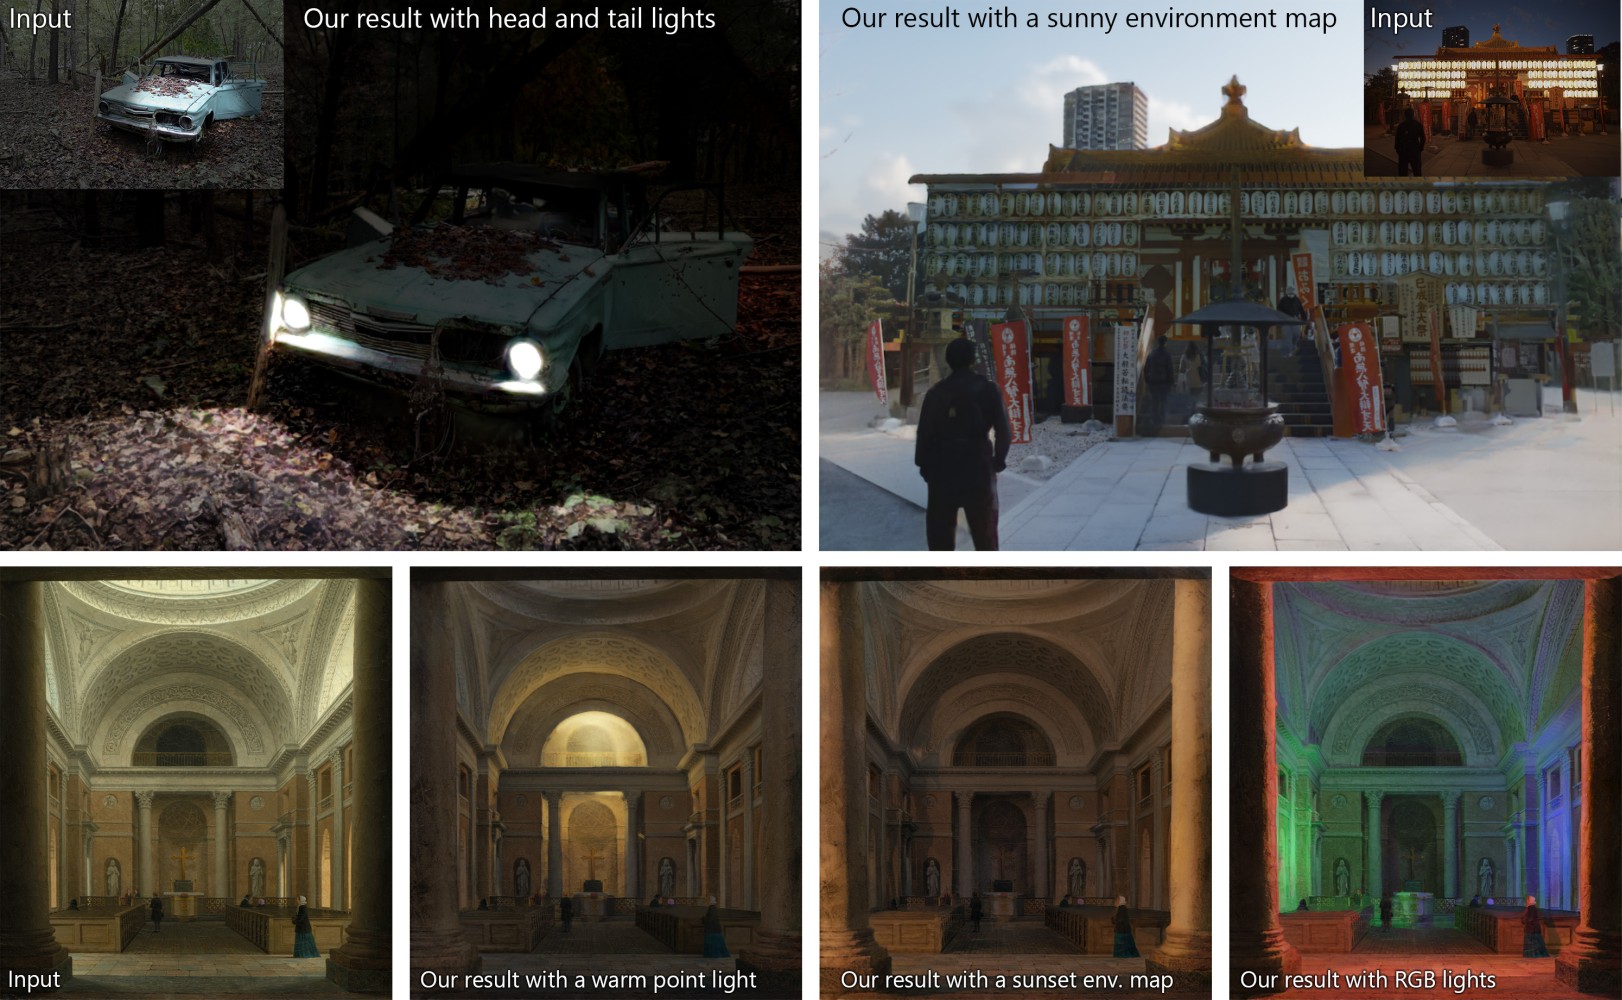
찍고 나서 조명을 바꿀 수 있다면
사진을 찍고 나서 “아, 빛이 왼쪽에서 들어왔으면 훨씬 좋았을 텐데” 싶었던 적 있으시죠? 구도는 크롭으로, 색감은 보정으로 어떻게든 되는데 빛의 방향과 위치만큼은 찍는 순간에 정해져 버려요. 그런데 이미 찍은 사진 속에 3D 프로그램처럼 조명을 '배치'해서 다시 비출 수 있게 해주는 연구가 있어요. 사이먼프레이저대(SFU) Computational Photography Lab의 Chris Careaga와 Yağız Aksoy가 SIGGRAPH 2025에서 발표한 Physically Controllable Relighting of Photographs인데요. 이름 그대로 '물리적으로 제어 가능한 사진 재조명'이에요.
기존 방식은 뭐가 아쉬웠나
요즘 사진 재조명(relighting)은 대부분 디퓨전 모델 기반이에요. “노을빛으로 바꿔줘” 같은 텍스트나 배경 이미지를 주면 그럴듯하게 분위기를 바꿔주죠. 결과물은 예쁜데, 문제는 통제가 안 된다는 거예요. “광원을 피사체 오른쪽 뒤에, 살짝 따뜻한 색으로 놓고 싶다”는 걸 말로 정확히 전달하기 어렵고, 모델이 그림자를 물리적으로 맞게 그려준다는 보장도 없어요.
반대편에는 Blender 같은 3D 툴이 있어요. 여기서는 조명을 원하는 좌표에 놓고 세기와 색을 숫자로 조절하면 렌더러가 물리 법칙대로 계산해주죠. 완벽하게 통제되지만 이건 3D 장면이 있을 때 얘기고, 우리 손에 있는 건 사진 한 장뿐이에요. 이 연구는 그 둘을 이어 붙였어요. 통제는 전통적인 렌더링에게, 사실감은 신경망에게 맡기는 구조예요.
어떻게 동작하나
파이프라인은 세 단계로 볼 수 있어요.
1단계, 사진을 3D 장면으로 바꾸기. 사진 한 장에서 두 가지를 추정해요. 하나는 깊이와 형태(지오메트리)고, 다른 하나는 고유 이미지 분해(intrinsic decomposition) 예요. 이게 뭐냐면, 우리가 보는 픽셀 색을 '물체 본래의 색'과 '그 위에 떨어진 빛'으로 쪼개는 작업이에요. 흰 벽에 주황색 조명이 비치면 사진에는 주황색으로 찍히지만 벽 자체는 흰색이잖아요. 이걸 분리해내야 기존 조명을 걷어내고 새 조명을 입힐 수 있어요. 이렇게 얻은 형태에 본래 색을 입혀서 색이 칠해진 메시(colored mesh) 를 만들어요.
2단계, 조명을 놓고 패스 트레이싱. 3D 장면이 생겼으니 이제 사용자가 원하는 위치에 광원을 놓을 수 있어요. 그리고 패스 트레이싱, 그러니까 빛이 지나가는 경로를 실제로 추적해서 계산하는 렌더링 방식으로 새 조명 아래의 장면을 그려요. 그림자가 어디로 떨어지는지, 빛이 어디까지 닿는지가 물리적으로 계산되는 거죠. 다만 사진 한 장에서 추정한 메시라 거칠고, 이 결과만 보면 꽤 어색해요.
3단계, 신경망으로 마무리. 그래서 이 '대략적인 렌더링'을 피드포워드 신경망 렌더러에 넣어서 실제 사진 같은 최종 결과로 다듬어요. 신경망은 조명을 지어내는 게 아니라, 이미 물리적으로 계산된 빛을 사진답게 표현하는 역할만 맡는 거예요.
영리한 부분: 정답 데이터 없이 학습하기
재조명 연구의 고질적인 문제가 학습 데이터예요. 같은 장면을 조명만 바꿔서 찍은 사진 쌍이 대량으로 필요한데, 일상적인 환경에서 그런 데이터를 모으기는 정말 어렵거든요. 그래서 합성 데이터나 스튜디오에서 찍은 데이터에 기대는 경우가 많았어요.
이 연구는 자기지도 학습(self-supervised) 으로 풀었어요. 미분 가능한 렌더링을 이용해서, 평범한 사진에서 “이 사진이 찍힐 때 조명이 어땠는지”를 거꾸로 복원해요. 그렇게 복원한 조명으로 메시를 렌더링한 결과를 입력으로, 원본 사진을 정답으로 삼으면 학습 쌍이 만들어지죠. 즉 '대략적인 렌더링에서 진짜 사진으로 가는 법'을 일반 사진 모음만으로 배울 수 있는 거예요. 덕분에 특정 스튜디오 환경이 아닌 일상 사진에도 적용할 수 있게 됐어요.
다른 접근들과 비교하면
텍스트나 배경으로 분위기를 바꾸는 IC-Light, 환경맵으로 물체를 다시 비추는 Neural Gaffer, 사진 속 광원을 켜고 끄는 구글의 LightLab 같은 디퓨전 기반 연구들이 같은 문제를 다른 각도에서 풀고 있어요. 스마트폰의 인물 사진 조명 효과처럼 얼굴에 특화된 재조명은 이미 상용화돼 있기도 하고요. 그쪽은 결과물의 완성도와 편의성이 강점이고, 이 연구는 명시적인 3D 제어가 강점이에요. 광원 위치를 직접 다룰 수 있다는 건 VFX나 합성 작업처럼 “정확히 이렇게”가 필요한 곳에서 큰 차이를 만들어요. 한계도 분명해요. 사진 한 장에서 추정한 정보에 기대다 보니 안 보이는 뒷면은 알 수 없고, 깊이나 분해가 틀리면 그 오차가 결과에 그대로 따라올 수밖에 없어요.
한국 개발자에게는
이커머스 상품 사진, 인테리어나 부동산 이미지, 영상 합성 쪽에서 일한다면 눈여겨볼 만해요. 당장 서비스에 붙이는 것보다 설계 방식을 배워갈 가치가 더 커요. “생성 모델에게 전부 맡기지 말고, 물리적으로 계산할 수 있는 부분은 계산한 다음 신경망에게는 마무리만 시킨다”는 구조는 재조명 말고도 여러 문제에 적용할 수 있거든요. 깊이 추정, 고유 이미지 분해, 미분 가능한 렌더링 같은 키워드가 낯설다면 이 논문이 좋은 입문 지도가 돼줄 거예요.
마무리
한 줄로 정리하면, “빛은 물리로 계산하고, 사실감은 신경망으로 채운다” 는 연구예요. 여러분은 생성형 AI 결과물에서 “예쁘긴 한데 내 마음대로 안 된다”는 답답함을 느낀 적 있나요? 그럴 때 어떤 식으로 제어권을 되찾았는지 궁금해요.
🔗 출처: Hacker News